

La memoria de un agente de IA es lo que le permite llevar algo de un paso, o de una sesión, al siguiente. Un modelo de lenguaje por sí solo no recuerda nada entre llamadas. Lo que parece recordar lo volvió a poner en el prompt tu código. Cómo guardes y recuperes ese material decide qué puede recordar el agente, con qué rapidez y a qué costo por turno.
En resumen. Los agentes necesitan cuatro tipos de memoria: una ventana de conversación corta, hechos a largo plazo que se encuentran por significado, un bloc de notas para la tarea en curso y un registro de lo que ocurrió. Cada uno tiene una forma, una vida útil y una consulta distintas, así que una única tabla de memoria no encaja bien con ninguno. HotKV guarda los cuatro en un solo motor en memoria con los comandos
AMEM.*. Hemos medido la caché y la búsqueda vectorial de HotKV, no la memoria de agentes, así que este artículo explica el diseño y no afirma ninguna mejora de velocidad.
Por qué una ventana de contexto no es memoria
Una ventana de contexto es el texto que envías con cada solicitud. Tiene un límite de tamaño, pagas tokens de entrada por todo lo que contiene en cada turno y desaparece cuando termina la sesión. Tampoco se puede buscar en ella. Si un agente necesita un dato de hace tres semanas, pegar todo el historial no es una respuesta.
La memoria es la capa que decide qué entra en la ventana a continuación. Conserva los turnos recientes y encuentra los pocos hechos antiguos que importan. Guarda el estado de la tarea actual y registra lo que ha hecho el agente. Los investigadores describen los agentes en términos parecidos. El marco CoALA, de Sumers, Yao, Narasimhan y Griffiths, separa la memoria de trabajo de la memoria episódica, semántica y procedimental a largo plazo.
Los cuatro tipos de memoria de agentes de IA
Los cuatro almacenes de HotKV cubren casi el mismo terreno, adaptado a lo que tiene que construir una aplicación. La memoria procedimental, el saber hacer que reside en el código y los prompts del agente, normalmente vive en tu repositorio o en un registro de prompts y no es un almacén aparte.
Memoria de conversación
Es la transcripción a corto plazo de una sesión. Los mensajes llevan un rol (sistema, usuario, asistente o herramienta). Están en una ventana deslizante acotada, de modo que los turnos más antiguos se descartan al alcanzar el límite. Responde a una sola pregunta. ¿Qué se dijo hace poco? En HotKV eso son AMEM.CONV.CREATE, AMEM.CONV.APPEND y AMEM.CONV.WINDOW.
Memoria semántica
La memoria semántica es conocimiento a largo plazo guardado como hechos con un vector de embedding. El agente los recupera por significado, no por clave. Se apoya en un índice vectorial HNSW, del mismo tipo que el que impulsa la búsqueda vectorial. AMEM.SEM.STORE guarda un hecho y AMEM.SEM.RECALL devuelve las mejores coincidencias con una puntuación de similitud. Aquí van los documentos, las preferencias del usuario y las correcciones aprendidas.
Memoria de trabajo
La memoria de trabajo es el bloc de notas de una tarea en curso, un conjunto plano de claves y valores acotado a una sesión. Guarda el paso actual, el ticket que se está atendiendo o un resultado parcial. Debería desaparecer cuando acabe la tarea. AMEM.WORK.SET acepta un tiempo de vida precisamente por eso.
Memoria episódica
La memoria episódica es un registro de solo anexado de eventos con marca de tiempo, como una acción realizada, una observación hecha o una decisión tomada. Permite que un agente, o una persona que lo revisa, pregunte qué ocurrió y cuándo. AMEM.EPIS.LOG escribe un evento y AMEM.EPIS.QUERY los lee por tipo y rango de tiempo.
La memoria de agentes de IA en la práctica
En la práctica importan dos cosas. Cómo escribes en la memoria y qué lees de vuelta en cada turno.
Guardar memoria con comandos
Este es un agente de soporte que atiende una conversación. El texto de la política ficticia y los vectores de tres números son solo ilustrativos. Un modelo de embeddings real produce vectores de 768 o 1536 números, y creas el espacio de nombres con esa dimensión.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
En cada turno, el agente lee la ventana reciente y recupera los pocos hechos que coinciden con la pregunta. Comprueba su nota de trabajo y construye el prompt con esas piezas. Después de actuar, registra el evento. Nada de ese bucle necesita el historial completo.
Leer la memoria en cada turno
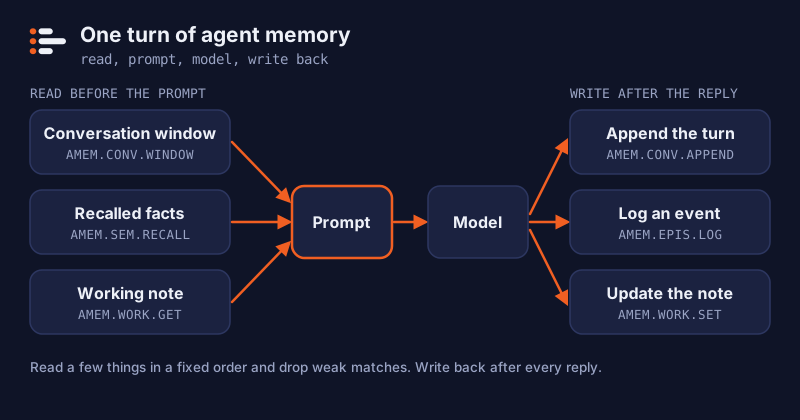
Guardar memoria es la mitad fácil. La destreza está en decidir qué leer de vuelta, porque todo lo que lees entra en el prompt y cuesta tokens de entrada. Un bucle razonable lee un puñado de cosas en un orden fijo. Primero los turnos recientes, luego los pocos hechos que coinciden con la pregunta y después el estado de la tarea. Aquí está con el cliente oficial de Python, con tu propia función de embeddings y tu plantilla de prompt.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # ajústalo con tus propios datos

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # créala una vez, antes del primer append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # tu plantilla de prompt

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
El corte de similitud lo ajustas tú. Un valor que va bien con un modelo de embeddings y un conjunto de hechos será erróneo para otro, así que comprueba la recuperación con preguntas cuya respuesta conoces. Descartar las coincidencias débiles importa más de lo que parece, porque un hecho pobre en el prompt es peor que ningún hecho.
Las partes estables de este prompt, como las instrucciones del sistema, son también la parte que la caché de prompts del proveedor abarata. Pon la memoria que lees al final, después del texto estable, para que cambiarla no invalide esa caché.
Resúmenes en lugar de ventanas cada vez más largas
Una ventana descarta por completo los turnos antiguos. Eso está bien para una charla informal y mal para una tarea larga, donde el turno 3 puede seguir importando en el turno 300. La respuesta habitual es un resumen continuo. Tras cada tramo de conversación, el agente, o un modelo más barato, anota lo aprendido, y el resumen sustituye a los turnos antiguos en el prompt.
HotKV guarda un resumen por agente con AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND y AMEM.SUMMARY.GET. SET sustituye el texto y APPEND añade una línea. Cada actualización sube un número de versión, así que otro componente puede saber de forma barata que el resumen cambió y cuándo.
Un resumen pierde información, y resumir un resumen pierde más cada vez. Mantén los valores exactos, como identificadores, importes y fechas, fuera de la prosa y en la memoria de trabajo o en hechos semánticos, donde sobreviven. Usa el resumen para la forma del trabajo, como las preferencias, las decisiones tomadas y lo que queda por hacer.
Reglas de diseño y retención
La memoria crece sin límite si no la detienes, así que fija los límites antes de la primera escritura.
Reglas que mantienen útil la memoria
- Acota todo. Fija un
WINDOWen las conversaciones y unTTLen las sesiones y los valores de trabajo. En conversaciones, valores de trabajo y hechos, HotKV registra la hora de expiración para el archivo de solo anexado y las réplicas, así que una entrada que ha expirado no vuelve cuando el archivo se reproduce tras un reinicio. - Guarda hechos, no transcripciones. Resume antes de escribir en la memoria semántica. Un hecho es más fácil de recuperar que una página de diálogo.
- Mantén separados a los agentes. Usa un identificador o un espacio de nombres distinto por agente y por inquilino, para que la memoria de un cliente nunca se recupere para otro.
- Recupera pocos, no muchos. Toma las tres a cinco mejores coincidencias y descarta las débiles por puntuación de similitud antes de que entren en el prompt.
- Deja fuera los secretos. La memoria se vuelve a leer en los prompts, así que nunca guardes contraseñas, claves ni datos que no le enseñarías al modelo.
Cuánto tiempo conservar cada tipo
Estas vidas útiles son sugerencias nuestras, no valores por defecto. Elige las tuyas según la rapidez con que cambian los hechos de fondo y lo que se te permite conservar.
| Tipo de memoria | Vida útil sugerida | Controles en HotKV |
|---|---|---|
| Conversación | La sesión, o un periodo fijo como un día | WINDOW y TTL en AMEM.CONV.CREATE |
| Trabajo | La tarea, y luego se borra | TTL en AMEM.WORK.SET, y AMEM.WORK.CLEAR |
| Semántica | Hasta que el hecho deje de ser cierto | TTL en AMEM.SEM.STORE, y AMEM.SEM.FORGET |
| Episódica | Todo el tiempo que exijan tus necesidades de auditoría o soporte | AMEM.EPIS.QUERY por rango de tiempo, y AMEM.EPIS.CLEAR (los eventos no tienen tiempo de vida) |
La retención es también una cuestión de privacidad. Si la memoria guarda algo sobre una persona, la vida útil que elijas forma parte de lo que le prometes, así que déjala por escrito.
Cómo falla la memoria de los agentes
La mayoría de los fallos de memoria son lentos. El agente funciona bien una semana y luego empieza a empeorar. Estos son los fallos contra los que hay que diseñar.
Fallos habituales
- Hechos obsoletos. Un hecho que era cierto en marzo se recupera en octubre. Dale a los hechos un tiempo de vida, o guárdalos bajo una clave por entidad para que el valor nuevo sobrescriba al antiguo.
- Contradicciones. Dos hechos guardados se contradicen y el agente elige uno al azar. Prefiere un hecho por clave a añadir notas nuevas junto a las antiguas.
- Recuperar de más. Demasiadas coincidencias llenan el prompt de texto poco relacionado. Recupera pocas y descarta las débiles.
- Fugas entre usuarios. La memoria de un cliente se recupera para otro. Usa identificadores o espacios de nombres distintos para cada inquilino, comprobados en el código antes de cada lectura.
- Crecimiento sin límite. Nada expira nunca, así que las consultas se vuelven lentas y los costos van subiendo. Cada tipo necesita una vida útil. Donde HotKV no tiene tiempo de vida, como en el registro episódico, programa tú mismo un borrado o una exportación.
- Deriva del resumen. Un resumen de un resumen deja poco a poco de corresponderse con lo que ocurrió. Mantén el registro de eventos como fuente de verdad y regenera los resúmenes a partir de él.
Trata el texto guardado como no fiable
El último punto merece más atención. Todo lo que un agente escribe en la memoria puede leerse más tarde en un prompt. Eso incluye texto procedente de una página web, un correo o un usuario. Esa es la forma indirecta de inyección de prompts que OWASP clasifica como LLM01. Guarda la fuente de cada hecho. Confía menos en la memoria escrita a partir de contenido externo, y no dejes nunca que una nota recuperada prevalezca sobre tu prompt del sistema.
Qué hemos medido y qué no
Los benchmarks publicados de HotKV cubren el throughput de comandos, la búsqueda vectorial y el ahorro de tokens de la caché de respuestas. La memoria de agentes todavía no tiene un benchmark propio. No afirmamos nada sobre su latencia ni sobre cuánto mejora la calidad de los agentes. Lo que sí podemos decir es arquitectónico. Los cuatro almacenes se ejecutan en el mismo proceso que la caché y el índice vectorial. Una consulta de memoria es una sola llamada a un sistema que ya operas.
El benchmark de ahorro de tokens y la comparación entre caché de prompts y caché semántica muestran la parte medida. El caso de uso de la memoria de agentes muestra los comandos en un escenario completo.
Usar la memoria de agentes desde Claude Code o Cursor
Un asistente compatible con el Model Context Protocol puede usar parte de esta memoria sin código a medida. El servidor de código abierto hotkv-mcp expone como herramientas la memoria de conversación, las notas de trabajo, un registro de eventos y un resumen continuo. Tiene un modo de solo lectura y un espacio de nombres que confina al agente. No expone la memoria semántica, y sus herramientas no pueden fijar una ventana ni un tiempo de vida, así que para eso usa la biblioteca cliente. El siguiente artículo, un servidor MCP para la memoria de agentes, muestra cómo conectarlo y qué cubren sus salvaguardas.
Preguntas frecuentes
¿Qué es la memoria de agentes de IA?
La memoria de agentes de IA es la capa de almacenamiento y recuperación que permite a un agente conservar información entre pasos y sesiones. Suele combinar una ventana de conversación reciente, hechos a largo plazo que se encuentran por significado, un bloc de notas para la tarea actual y un registro de eventos.
¿Qué diferencia hay entre la memoria de agente a corto y a largo plazo?
La memoria a corto plazo guarda lo que ocurre ahora, como los turnos recientes y el estado de la tarea, y es acotada y temporal. La memoria a largo plazo guarda el conocimiento que debe sobrevivir a una sesión, como hechos, preferencias y eventos pasados, y se consulta cuando hace falta.
¿Qué es un resumen continuo en la memoria de agentes?
Un resumen continuo es una descripción breve y en curso de lo que un agente ha aprendido o decidido hasta ahora, que se actualiza mientras avanza el trabajo. Sustituye a los turnos antiguos en el prompt para que este no deje de crecer. HotKV guarda uno por agente y sube un número de versión en cada actualización.
¿Necesito una base de datos vectorial para la memoria de agentes?
Solo para la memoria semántica, donde los hechos se encuentran por significado. Las ventanas de conversación, el estado de trabajo y los registros de eventos no necesitan vectores. HotKV guarda los cuatro en un solo motor, así que el índice vectorial y los demás almacenes no son sistemas separados.
¿Cuánto tiempo debe conservarse la memoria de agentes?
Depende del tipo. La memoria de trabajo debería expirar cuando termina la tarea, las conversaciones tras la sesión o un periodo fijado, y los registros episódicos todo el tiempo que exijan tus necesidades de auditoría. Los hechos de la memoria semántica deben revisarse y eliminarse cuando dejen de ser ciertos.
¿Se puede atacar la memoria de un agente?
Sí. El texto escrito en la memoria se lee más tarde en los prompts, así que una nota envenenada puede dirigir al agente. Registra de dónde procede cada hecho, confía menos en el contenido externo y mantén la memoria recuperada por debajo de tu prompt del sistema en autoridad.
¿HotKV guarda la memoria de agentes en RAM?
HotKV es un motor en memoria, así que las lecturas se sirven desde la memoria. Las escrituras en los cuatro almacenes se registran para el archivo de solo anexado y para las réplicas, con las horas de expiración incluidas, según la documentación del producto.

Continúa la conversación
Comentarios
¿Preguntas sobre el método? ¿Un resultado distinto en tu hardware? Comparte lo que encontraste. Los comentarios se revisan antes de aparecer.