

Con el nombre de caché para modelos de lenguaje se venden dos cosas distintas, y los equipos compran con frecuencia una esperando la otra. La caché de prompts es una función del proveedor que abarata la lectura de un prefijo de prompt repetido. La caché semántica es una capa que ejecutas tú mismo y que responde una pregunta desde la memoria, de modo que nunca se llama al modelo. Resuelven mitades distintas de la factura y funcionan mejor juntas.
En resumen. La caché de prompts da un descuento sobre el comienzo repetido de un prompt, como un prompt del sistema largo, pero el modelo se sigue ejecutando y sigues pagando cada token de salida. La caché exacta y la semántica eliminan la llamada por completo cuando una pregunta ya se respondió antes. En nuestro benchmark de 3000 solicitudes, con la caché de prompts del proveedor ya activada, poner HotKV delante redujo las llamadas al modelo, los tokens y el costo en cerca de un 70 %, porque los tokens de salida seguían siendo entre el 73 % y el 92 % del costo de la línea base.
Cómo funciona la caché de prompts
La caché de prompts vive en el proveedor del modelo. Marcas el comienzo estable de una solicitud, normalmente las herramientas y el prompt del sistema, y el proveedor guarda su forma procesada durante un tiempo breve. La siguiente solicitud que empiece con el texto idéntico se factura con una tarifa reducida por esa parte. Aquí describimos la versión de Anthropic porque es la que medimos. Los detalles de abajo proceden de su documentación sobre la caché de prompts, consultada el 18 de octubre de 2026.
Qué se guarda en la caché
Un acierto exige una coincidencia exacta. Todos los bloques hasta el que marcaste con cache_control, incluido este, deben ser idénticos, en el orden herramientas, prompt del sistema y mensajes. Si cambias un solo carácter al principio del prompt, todo lo que viene después es un fallo. La pregunta va al final, así que nunca forma parte del prefijo en caché.
Los prompts por debajo de una longitud mínima no se guardan en caché y no se devuelve ningún error. Para los modelos Claude actuales que usamos, Fable 5.1, Opus 5.5, Sonnet 5.5 y Haiku 5.5, el mínimo documentado es de 512 tokens. Las entradas de la caché están aisladas por organización, y por espacio de trabajo en la API de Claude.
Cuánto cuesta
La vida útil por defecto es de cinco minutos, y cada uso de la entrada la renueva sin cargo adicional. También hay una vida útil de una hora. Escribir una entrada cuesta 1,25 veces el precio base de entrada para cinco minutos y 2 veces para una hora. Leerla cuesta 0,1 veces el precio base de entrada en la mayoría de los modelos, 0,05 veces en Opus 5.5 y Sonnet 5.5 y 0,025 veces en Fable 5.1, según la página de precios. Esos multiplicadores cambian, así que lee la página actual antes de hacer ninguna cuenta.
Lo que la caché de prompts no puede eliminar
La caché de prompts da un descuento por leer el prefijo. No se salta el modelo. Cada solicitud sigue generando una respuesta nueva, sigues esperándola y cada token de salida se factura al precio completo de salida.
Nuestro benchmark muestra cuánto importa eso. Enviamos 3000 preguntas de atención al cliente a cada uno de cuatro modelos Claude, con una política de 2200 tokens como prompt del sistema y la caché del proveedor activada. Entre el 90 % y el 93 % de los tokens contados eran lecturas de caché de esa política. La salida era solo entre el 6 % y el 9 % de los tokens, pero entre el 73 % y el 92 % del costo de la línea base. El prefijo ya era barato, así que el gasto restante estaba en las respuestas.
Ese es el hueco que llenan las otras capas. El método completo y los resultados están en el benchmark de ahorro de tokens.
Caché de respuestas exacta y semántica
Dos capas responden una solicitud desde la memoria. Se diferencian en cómo deciden que una solicitud nueva coincide con una anterior.
Caché de respuestas exacta
Una caché exacta guarda la respuesta final bajo una clave construida con todo lo que la determina. Normalmente son el modelo, la versión del prompt y la pregunta normalizada. Cuando vuelve a llegar la misma solicitud se devuelve la respuesta guardada y no se llama al modelo. No hay puntuación de similitud ni riesgo de devolver una respuesta pensada para otra pregunta.
En nuestra ejecución, la caché exacta respondió alrededor del 39 % de las solicitudes. Una pregunta repetida volvió con una mediana de unos 0,05 ms. Se midió con un cliente de Python a través de loopback en la misma máquina, así que léela como una cifra local y no de red. El benchmark usó simples GET y SET para esta capa. HotKV Enterprise también tiene una caché de prompts de coincidencia exacta dedicada, PCACHE.*, con límites por espacio de nombres y seguimiento de costos.
La caché exacta no entiende de formulaciones. "How do I reset my password?" y "I forgot my password" son dos claves distintas.
Caché semántica
Una caché semántica busca por el significado de la pregunta. Convierte la pregunta en un embedding, encuentra la pregunta guardada más cercana y devuelve su respuesta si la similitud del coseno supera un umbral. En HotKV eso es SCACHE.*, construido sobre el mismo índice vectorial que la búsqueda vectorial.
Alrededor del 31 % de nuestras solicitudes se respondieron así. Una paráfrasis tardó una mediana de unos 130 ms, casi todos por la llamada al servicio de embeddings, de modo que un acierto semántico es mucho más rápido que una llamada al modelo, pero no instantáneo. Sin la capa semántica, una caché exacta por sí sola habría necesitado como máximo 1264 llamadas al modelo de 3000, alrededor de un 58 % menos. La capa semántica llevó el ahorro a cerca del 70 %.
Es también donde está el riesgo. Una pregunta parecida no siempre es la misma pregunta. Hicimos que un segundo modelo Claude juzgara cada acierto semántico frente a una respuesta nueva. Con nuestro umbral por defecto de 0,81, las respuestas en caché encajaron con la pregunta exacta entre 5,8 y 10,7 puntos porcentuales menos a menudo que las nuevas. En Sonnet 5.5, los umbrales de 0,88 o superiores no mostraron ese déficit, con evidencia escasa. Las preguntas escritas para diferir en un detalle decisivo coincidieron aun así el 62 % de las veces con 0,81 y el 10 % con 0,95.
Caché de prompts frente a caché semántica, lado a lado
| Caché de prompts del proveedor | Caché de respuestas exacta | Caché semántica | |
|---|---|---|---|
| Qué elimina | Parte del precio de entrada | La llamada completa al modelo | La llamada completa al modelo |
| Regla de coincidencia | Prefijo idéntico | Solicitud idéntica | Significado similar por encima de un umbral |
| Tokens de salida facturados | Sí, cada vez | No, en un acierto | No, en un acierto |
| Riesgo de respuesta errónea | Ninguno | Ninguno para solicitudes idénticas | Real, ajustado con el umbral |
| Dónde se ejecuta | En el proveedor | En tu caché | En tu caché, más una llamada de embeddings |
| Proporción de solicitudes en nuestra ejecución | Siempre activa | Cerca del 39 % | Cerca del 31 % |
La caché de prompts del proveedor y la caché de respuestas no son alternativas. Una reduce el precio de las llamadas que sigues haciendo, y la otra reduce cuántas llamadas haces.
Qué hace el almacenamiento en caché con la latencia
Saltarse el modelo cambia la rapidez con la que llegan las respuestas, además de lo que cuestan. En nuestra ejecución, el tiempo mediano hasta una respuesta completa pasó de 2,7 segundos a 127 ms en Fable 5.1, de 2,9 segundos a 126 ms en Opus 5.5, de 1,8 segundos a 128 ms en Sonnet 5.5 y de 1,4 segundos a 125 ms en Haiku 5.5. Eso es entre 11 y 23 veces más rápido en la mediana.
El extremo lento apenas se movió. Alrededor del 30 % de las solicitudes seguían llegando al modelo, y el percentil 99 en Fable 5.1 fue de unos 6,4 segundos con HotKV frente a 6,6 segundos sin él. Una caché elimina la espera de las solicitudes que responde y no hace nada por las que no acierta. Si tu queja es un peor caso lento y no un caso típico lento, la caché por sí sola no lo arreglará.
Estos son tiempos hasta la respuesta completa, porque las llamadas no se transmitieron en streaming. Una respuesta en streaming muestra antes sus primeras palabras. La diferencia en una ventana de chat es menor que la de estas cifras.
Elegir una capa para tu tráfico
La capa adecuada depende de cómo se repiten tus solicitudes, y puedes medirlo antes de construir nada.
Ajusta la capa al tráfico
Ajusta la capa a cómo se repiten tus solicitudes.
- Un prompt del sistema o una lista de herramientas largos y estables: usa la caché de prompts del proveedor. Cuesta poco activarla y no cambia ninguna respuesta.
- La misma pregunta con las mismas palabras, como un botón, una plantilla o un reintento: usa una caché de respuestas exacta. Es segura y rápida.
- Tráfico de soporte, búsqueda y preguntas frecuentes en el que la gente pregunta lo mismo con otras palabras: añade una caché semántica, fija el umbral alto y comprueba la calidad de las respuestas con tus propias preguntas antes de fiarte de ella.
- Respuestas que dependen del usuario, del reloj o de datos en vivo: no guardes ninguna en caché, o construye la clave con los datos que cambian la respuesta.
El ahorro sigue a la repetición. Cuando hicimos que todas las intenciones fueran igual de probables en lugar de sesgadas, el costo bajó un 56 % en los dos modelos que volvimos a ejecutar, y con 3000 preguntas todas distintas bajó un 38 %. Una carga de trabajo sin preguntas repetidas ni similares no ahorra nada.
Mide primero tu propia repetición
Antes de construir nada, averigua cuánto de tu tráfico se repite. Ese número decide si merece la pena tener una caché exacta. Lleva diez minutos con las preguntas que ya registras. Normaliza cada pregunta como lo hará la clave de tu caché, cuenta las distintas y mira qué parte del tráfico fue una repetición.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share es la fracción de solicitudes que habría respondido una caché exacta, una vez que hubiera visto cada pregunta por primera vez. Nuestro conjunto de prueba tenía 1264 preguntas distintas entre 3000 solicitudes, así que la cifra fue de alrededor del 58 %. Si la tuya sale cerca del 5 %, una caché exacta servirá de poco, y solo una capa semántica puede ayudar.
Hay dos advertencias. Una caché empieza vacía, así que las primeras solicitudes siempre llegan al modelo. En nuestra ejecución, alrededor del 52 % de las primeras mil solicitudes se sirvieron desde la caché y alrededor del 81 % de las últimas mil. Además, un registro del tráfico del mes pasado te habla del mes pasado. Si estás a punto de lanzar una función que cambia lo que la gente pregunta, trata la cifra como una guía aproximada.
Poner las capas juntas
Una solicitud debe pasar por las capas de la más barata y segura a la más cara, y tienes que poder ver qué ahorró cada una.
El orden de las consultas
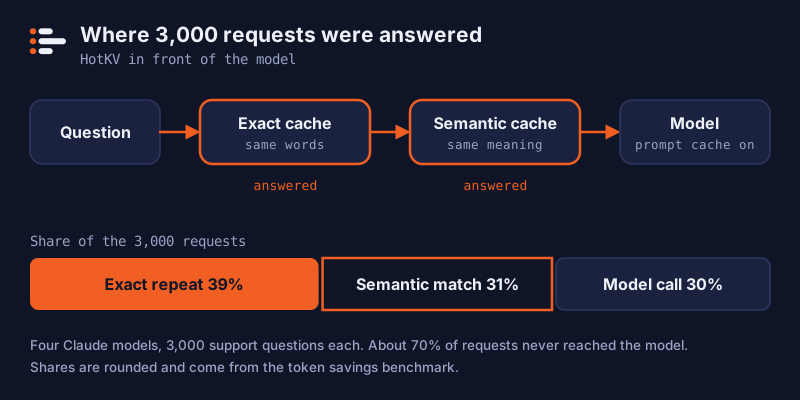
El orden importa. Comprueba primero la capa más barata y segura, y llama al modelo solo cuando todas fallen. Este esquema supone un cliente al estilo de redis-py con decode_responses=True, dos espacios de nombres creados de antemano y tus propias funciones embed y llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # mismas palabras

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # mismo significado

    reply = llm.complete(question)                   # aquí se aplica la caché de prompts del proveedor
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Crea los espacios de nombres una sola vez con PCACHE.CREATE answers_exact y SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, usando la dimensión de tu modelo de embeddings. El conjunto de comandos de IA viene con las instancias Performance y Scale de HotKV Cloud, y la página de IA enumera lo que hace cada motor. La página de precios muestra qué plan incluye qué.
Llevar la cuenta en producción
Una caché que no puedes ver es una caché de la que no puedes fiarte. HotKV lleva el recuento de aciertos y fallos por espacio de nombres. Si guardas con cada entrada el uso de tokens de la llamada original, también puede atribuir los tokens y el costo que evitó cada acierto posterior. Las respuestas de PCACHE.STATS y SCACHE.STATS incluyen entonces campos como usage_saved_requests, usage_saved_input_tokens y usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Sustituye <model> por el id de tu modelo. INPUT cuenta los tokens de prompt sin caché y CACHEREAD los tokens que el proveedor sirvió desde su propia caché, así que no se solapan. El modelo debe estar en la tabla de precios de HotKV para que el campo de costo signifique algo. LLMSTATS.PRICE LIST muestra qué modelos se conocen, y LLMSTATS.PRICE SET añade los tuyos. Un modelo sin precio sigue teniendo sus tokens contados, pero su costo se registra como cero y un contador aparte muestra que hubo solicitudes sin precio.
Las cachés reducen el gasto, y un presupuesto limita lo que queda. LLMBUDGET.SET define un límite de tokens y de dólares sobre una ventana de tiempo. LLMBUDGET.CONSUME se comprueba antes de la llamada al modelo, de modo que un agente descontrolado se detiene antes de gastar el dinero y no después. LLMSTATS.RECORD guarda totales por inquilino que entienden los tokens de lectura y de escritura de caché del proveedor. Los tres usan una única tabla de precios cuando pasas el nombre del modelo, así que un ahorro, un presupuesto y una cifra del panel no pueden contradecirse.
Errores que hacen que una caché devuelva respuestas equivocadas
La mayoría de los malos aciertos de caché vienen de una clave a la que le falta algo. Pon el modelo, la versión del prompt y cualquier versión de herramienta o de política en la clave exacta, para que un cambio de prompt no pueda servir respuestas escritas para el anterior.
Dale a las entradas una vida útil que se ajuste a la rapidez con que cambian tus datos. Separa a los inquilinos con espacios de nombres distintos para que la respuesta de un cliente nunca se ofrezca a otro. No guardes nunca en caché una respuesta que contenga datos personales, a menos que la clave incluya de quién son esos datos.
Por último, mide con tu propio tráfico. Nuestras cifras proceden de un conjunto de datos público de preguntas bancarias breves, una política ficticia y una ejecución por condición, y no son una promesa para tu carga de trabajo.
Preguntas frecuentes
¿Qué es la caché de prompts?
La caché de prompts es una función de los proveedores de modelos que guarda durante un tiempo breve el comienzo ya procesado de un prompt. Una solicitud posterior que empiece exactamente con el mismo texto se factura a una tarifa menor por esa parte. El modelo se sigue ejecutando y produce una respuesta nueva, así que sigues pagando los tokens de salida.
¿La caché de prompts es lo mismo que la caché semántica?
No. La caché de prompts reutiliza un prefijo de prompt repetido y sigue llamando al modelo. La caché semántica devuelve una respuesta guardada a una pregunta de significado similar y se salta la llamada al modelo. Abordan costos distintos y se pueden usar juntas.
¿La caché de prompts reduce el costo de los tokens de salida?
No. Solo rebaja el precio de leer el prefijo en caché. En nuestro benchmark, la salida fue entre el 6 % y el 9 % de los tokens pero entre el 73 % y el 92 % del costo de la línea base con la caché de prompts ya activada, y por eso guardar en caché respuestas completas ahorró mucho más.
¿Cuánto dura la caché de prompts de Anthropic?
Por defecto, cinco minutos, renovados cada vez que se usa la entrada. Hay una opción de una hora con un precio de escritura mayor. Consulta la documentación actual, porque los límites y los precios cambian.
¿Puedo usar juntas la caché de prompts y la caché semántica?
Sí, y nuestro benchmark hizo exactamente eso. La caché de prompts del proveedor siguió activada en ambas ejecuciones, y las capas semántica y exacta se situaron delante del modelo. Los aciertos de caché se saltan la llamada, y los fallos siguen beneficiándose del prefijo con descuento.
¿Qué umbral de similitud debe usar una caché semántica?
No hay un valor universal. Elegimos 0,81 en una partición de entrenamiento aparte, y en Sonnet 5.5 las respuestas en caché no mostraron déficit de calidad frente a las nuevas desde 0,88 en adelante, con evidencia escasa. Empieza alto, compara las respuestas en caché con las nuevas usando tus propias preguntas y baja el umbral solo si la calidad se mantiene.

Continúa la conversación
Comentarios
¿Preguntas sobre el método? ¿Un resultado distinto en tu hardware? Comparte lo que encontraste. Los comentarios se revisan antes de aparecer.