Este benchmark de latencia de Redis mide cuánto tardan HotKV, Redis, Valkey y Dragonfly en responder con una tasa de solicitudes fija. Nuestros benchmarks anteriores medían el rendimiento, y un lector señaló con razón que el rendimiento no lo es todo. Por eso mantuvimos la carga constante, la subimos paso a paso y registramos la mediana (p50) y el percentil 99 (p99) en cada paso. También medimos el tiempo de entrega de pub/sub.
En resumen. En este benchmark de latencia de Redis en AWS, HotKV y Dragonfly sostuvieron 1,6 millones de GET por segundo, Redis con 8 hilos de E/S unos 0,8 millones, Valkey con 8 hilos de E/S unos 0,4 millones, y Redis y Valkey con un solo hilo unos 0,2 millones. De 200.000 a 1,6 millones de solicitudes por segundo, el p99 de HotKV se mantuvo entre 0,59 y 0,76 ms, frente a 0,71 a 1,48 ms de Dragonfly. Con poca carga, los productos multihilo empataron en el p99, y la entrega de pub/sub también fue un empate.
Por qué hicimos un benchmark de latencia de Redis con tasa fija
Una prueba de rendimiento empuja al servidor tan fuerte como puede y mide cuánto sirvió. Eso dice poco sobre cuánto espera una solicitud concreta. Una prueba de latencia fija cuántas solicitudes por segundo envían los clientes y mide el tiempo de cada una. Así el servidor soporta la misma carga que cualquier otro producto y los tiempos se pueden comparar.
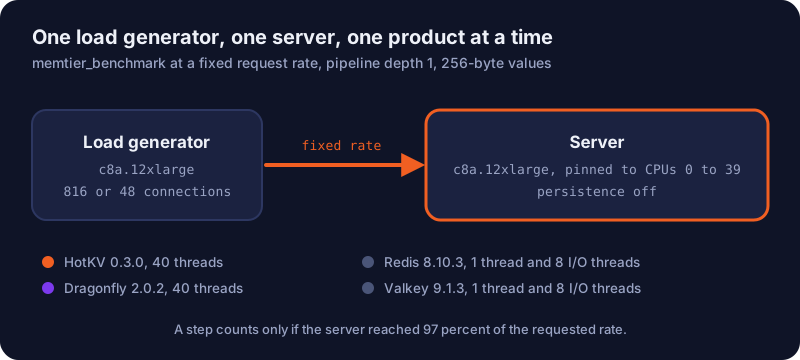
Este tipo de prueba tiene una trampa. memtier_benchmark es una herramienta de bucle cerrado: un cliente espera la respuesta antes de enviar la siguiente solicitud. Si un servidor no da abasto, el cliente simplemente envía menos solicitudes, y la latencia de las que sí envió parece mejor de lo que es. Por eso contamos un paso como sostenido solo cuando la tasa alcanzada es al menos el 97 por ciento de la que pedimos. Los pasos que no superan esa prueba aparecen como «NS» (no sostenido) en las tablas y no mostramos su latencia.
Qué probamos
Máquinas
- Servidores y generador de carga. Instancias
c8a.12xlarge(AMD EPYC 9R45, 48 núcleos, sin SMT, 96 GiB, red de 22,5 Gbit/s) en un grupo de ubicación de clúster de AWS en eu-south-2a, con Ubuntu 24.04. Una instancia ejecutó el generador de carga y otra el servidor. - Un producto cada vez. Cada producto se ejecutó solo en el servidor, de modo que nada se solapó y nada compartió la red. Cada proceso del servidor estaba fijado a las CPU 0 a 39, con la persistencia y el modo protegido desactivados.
Productos
- HotKV 0.3.0 con 40 hilos.
- Dragonfly 2.0.2 con 40 hilos proactor.
- Redis 8.10.3 y Valkey 9.1.3, cada uno ejecutado dos veces, una con la configuración predeterminada de un solo hilo y otra con
--io-threads 8.
La línea de arranque y la salida en vivo de CONFIG GET de cada ejecución se guardan con sus resultados.
Carga y procedimiento
El conjunto de datos eran 1.000.000 de claves con valores de 256 bytes, y la profundidad de pipeline era 1, de modo que cada solicitud espera su propia respuesta. La carga fue solo GET y una mezcla de 1 escritura por cada 10 lecturas. Cada paso duró 20 segundos, dos veces, y damos la media de las dos ejecuciones. memtier_benchmark usó un límite de tasa por conexión y registró un histograma HDR. Probamos dos números de conexiones.
- 816 conexiones (24 hilos de 34 conexiones), con tasas de 20.000 a 2,4 millones de solicitudes por segundo.
- 48 conexiones (4 hilos de 12 conexiones), con tasas de hasta 300.000 solicitudes por segundo. Por encima, 48 conexiones no pueden alcanzar la tasa, porque cada conexión solo puede enviar tan rápido como recibe respuestas.
Resultados
Primero van las tablas de GET, una por cada número de conexiones, y después pub/sub.
Con 816 conexiones
Cada celda muestra p50 / p99 en milisegundos, para GET. «NS» significa no sostenido, y entre paréntesis está la tasa que sí alcanzó. Un guion significa que el barrido de ese producto ya se había detenido.
| Solicitudes/s | HotKV | Dragonfly | Redis 1 hilo | Redis 8 hilos de E/S | Valkey 1 hilo | Valkey 8 hilos de E/S |
|---|---|---|---|---|---|---|
| 19.584 | 0,38 / 1,81 | 0,48 / 1,90 | 1,63 / 5,29 | 0,68 / 2,07 | 1,59 / 5,13 | 0,76 / 2,63 |
| 99.552 | 0,24 / 0,76 | 0,27 / 1,76 | 2,60 / 5,12 | 0,40 / 0,98 | 2,65 / 5,13 | 1,71 / 3,19 |
| 199.920 | 0,25 / 0,59 | 0,25 / 1,34 | 2,91 / 5,60 | 0,55 / 1,11 | 3,02 / 5,81 | 1,11 / 2,15 |
| 399.840 | 0,27 / 0,63 | 0,27 / 1,48 | NS (258k) | 0,62 / 1,23 | NS (259k) | 1,24 / 1,49 |
| 799.680 | 0,28 / 0,75 | 0,28 / 1,26 | - | 0,68 / 1,18 | - | NS (670k) |
| 1.199.520 | 0,28 / 0,67 | 0,28 / 1,05 | - | NS (1.078k) | - | - |
| 1.599.360 | 0,28 / 0,64 | 0,28 / 0,71 | - | - | - | - |
| 2.399.856 | NS (2.284k) | NS (2.281k) | - | - | - | - |
La carga mixta dio el mismo resultado. El p99 de HotKV fue de 0,54 a 0,75 ms de 200.000 a 1,6 millones de solicitudes por segundo, y los puntos que cada producto pudo sostener fueron los mismos que con GET. Todo está en la carpeta de resultados.
Cómo leer las filas de un solo hilo
Las medianas de 1,6 a 3 ms de Redis y Valkey con un solo hilo y 816 conexiones no son su latencia en régimen estable. Con un límite de tasa, memtier_benchmark hace que las 816 conexiones disparen en el mismo instante. Un servidor de un solo hilo tiene que procesar esa ráfaga de 816 solicitudes una tras otra, así que la mediana de una solicitud incluye su lugar en la cola. Hicimos la prueba de 48 conexiones que sigue para eliminar este efecto.
Con 48 conexiones
Las celdas tienen el mismo significado que antes, solo para GET.
| Solicitudes/s | HotKV | Dragonfly | Redis 1 hilo | Redis 8 hilos de E/S | Valkey 1 hilo | Valkey 8 hilos de E/S |
|---|---|---|---|---|---|---|
| 9.984 | 0,14 / 0,54 | 0,14 / 0,37 | 0,21 / 0,89 | 0,17 / 0,92 | 0,21 / 0,91 | 0,20 / 0,81 |
| 49.968 | 0,10 / 0,28 | 0,11 / 0,28 | 0,21 / 0,41 | 0,13 / 0,28 | 0,21 / 0,43 | 0,21 / 0,44 |
| 99.984 | 0,09 / 0,28 | 0,10 / 0,28 | 0,20 / 0,40 | 0,13 / 0,28 | 0,20 / 0,38 | 0,19 / 0,35 |
| 199.968 | 0,08 / 0,27 | 0,08 / 0,27 | 0,20 / 0,35 | 0,10 / 0,27 | 0,21 / 0,36 | 0,11 / 0,28 |
| 300.000 | 0,08 / 0,27 | 0,08 / 0,27 | NS (231k) | 0,09 / 0,26 | NS (233k) | 0,09 / 0,26 |
Tiempo de entrega de pub/sub
Medimos el tiempo desde que se publica un mensaje hasta que se entrega a un suscriptor, con 64 publicadores, 100 suscriptores y una carga de 128 bytes, usando pubsub-sub-bench. Cada mensaje fue a un suscriptor. Las celdas muestran p50 / p99 en milisegundos.
| Entregas/s | HotKV | Dragonfly | Redis 1 hilo | Redis 8 hilos de E/S | Valkey 1 hilo | Valkey 8 hilos de E/S |
|---|---|---|---|---|---|---|
| unas 21.000 | 0,10 / 0,71 | 0,10 / 0,65 | 0,11 / 0,74 | 0,11 / 0,62 | 0,11 / 0,76 | 0,12 / 0,78 |
| unas 107.000 | 0,10 / 1,02 | 0,12 / 0,92 | 0,10 / 0,80 | 0,11 / 0,63 | 0,10 / 0,82 | 0,10 / 0,86 |
| unas 215.000 | 0,11 / 1,20 | 0,13 / 1,13 | 0,51 / 1,03 | 0,20 / 0,73 | 0,57 / 1,07 | 0,12 / 1,22 |
Todos los productos entregaron en el mismo rango. Con la carga más alta, los productos de un solo hilo tuvieron una mediana mayor, 0,51 y 0,57 ms frente a 0,11 ms de HotKV.
También tuvimos que parchear pubsub-sub-bench. Comparaba un tiempo de publicación en milisegundos con un tiempo de recepción en microsegundos. El parche está en la carpeta de resultados.
Qué muestran los resultados
Las tablas muestran una ventaja de HotKV y Dragonfly con carga alta, un empate con poca carga y un techo para Redis y Valkey con un solo hilo.
HotKV y Dragonfly mantuvieron una cola baja hasta 1,6 millones de solicitudes por segundo
Ambos sostuvieron 1,6 millones de GET por segundo con 816 conexiones, con una mediana de 0,28 ms. El p99 de HotKV estuvo entre 0,59 y 0,76 ms desde 200.000 solicitudes por segundo. El de Dragonfly estuvo entre 0,71 y 1,48 ms, y con 1,6 millones los dos quedaron cerca (0,64 frente a 0,71 ms). Redis y Valkey con hilos de E/S dejaron de sostener la tasa con cargas menores, y Redis y Valkey con un solo hilo, en torno a 260.000.
Con poca carga los productos multihilo empatan
Con 48 conexiones, hasta 300.000 solicitudes por segundo, HotKV, Dragonfly y Redis con 8 hilos de E/S tuvieron todos un p99 de unos 0,27 ms. HotKV tuvo la mediana más baja, de 0,08 a 0,09 ms desde 100.000 solicitudes por segundo, con Dragonfly entre 0,08 y 0,10 ms. Una diferencia de 0,01 ms está dentro de lo que pueden causar otras partes de la configuración, así que no la presentamos como una victoria.
Redis y Valkey con un solo hilo llegaron a su límite en unas 230.000 por segundo
Con 48 conexiones tuvieron una mediana de unos 0,2 ms y un p99 de 0,35 a 0,43 ms, y no sostuvieron 300.000 solicitudes por segundo (unas 231.000 y 233.000). Ese es el techo de un hilo con este hardware y esta carga. Por eso Redis y Valkey suelen ejecutarse como muchos procesos o como un clúster, como en nuestro benchmark de clúster.
Limitaciones
Son mediciones de HotKV Ltd de las versiones y la configuración indicadas arriba. No son una afirmación sobre ninguna otra versión, configuración o carga de estos productos.
La configuración de la prueba
- Un servidor, un generador de carga. Dos repeticiones por paso, en un conjunto de máquinas en una fecha. No medimos la variación entre máquinas ni entre días.
- Configuraciones que elegimos. Redis y Valkey se ejecutaron con su configuración predeterminada de un solo hilo y con
--io-threads 8, y no ajustamos ninguno más allá de eso. Otros ajustes podrían cambiar sus cifras. Si cree que algún ajuste perjudica a un producto, díganoslo y lo revisaremos y publicaremos el resultado. - El efecto ráfaga de la herramienta. Con 816 conexiones, las medianas de los productos de un solo hilo están infladas por la forma en que funciona el límite de tasa de
memtier_benchmark, como se explicó antes.
Lo que no se midió
- Datos. Valores más grandes o sesgados, memoria por clave y persistencia. La persistencia estaba desactivada en todos los servidores.
- Modos. Modo clúster, pub/sub fragmentado, TLS, replicación y conmutación por error.
- Fan-out de pub/sub. Un mensaje a muchos suscriptores.
Redis, Valkey y Dragonfly son marcas de sus respectivos propietarios. Se nombran solo para identificar el software que medimos, y esto no implica patrocinio, respaldo ni afiliación.
Reprodúzcalo
Los scripts de barrido, la línea de arranque y la configuración en vivo de cada servidor, el parche de pubsub-sub-bench y todos los resultados en bruto están en el repositorio de benchmarks. El script de latencia es harness/lat_sweep.sh y el de pub/sub es harness/ps_sweep.sh. La carpeta raw contiene un archivo por prueba con el JSON de memtier_benchmark, los histogramas HDR y el uso de CPU del servidor de cada ejecución.
Pruébelo usted mismo
HotKV Cloud ejecuta HotKV por usted. Empiece en HotKV Cloud o hable con ventas para comparar HotKV con su propia carga.
Preguntas frecuentes
¿Es HotKV más rápido que Redis en latencia?
Bajo carga y con las tasas que probamos, sí. Con 816 conexiones y 200.000 solicitudes por segundo, HotKV tuvo un p99 de 0,59 ms, Redis con 8 hilos de E/S 1,11 ms y Redis con un solo hilo 5,60 ms. Con poca carga y 48 conexiones, los productos multihilo empataron en el p99, en unos 0,27 ms.
¿Por qué mantuvieron fija la tasa de solicitudes?
Con una tasa fija todos los productos soportan la misma carga, así que las latencias se pueden comparar. Una prueba de rendimiento muestra cuánto sirve un servidor en su límite, lo que dice poco sobre cuánto espera una solicitud.
¿Qué significa «no sostenido»?
El producto alcanzó menos del 97 por ciento de la tasa de solicitudes que pedimos. memtier_benchmark es una herramienta de bucle cerrado, así que un servidor sobrecargado hace que los clientes envíen menos y la latencia de las solicitudes restantes parece mejor de lo que es. No mostramos latencia para esos pasos.
¿Cómo se compara el tiempo de entrega de pub/sub?
Con las tres cargas que probamos, todos los productos entregaron en el mismo rango, con una mediana de unos 0,1 ms en las dos cargas más bajas. La tabla de arriba tiene todas las cifras.
¿Puedo reproducir este benchmark de latencia de Redis?
Sí. Los scripts, las configuraciones y todos los resultados en bruto están en el repositorio de benchmarks. Necesita dos servidores en la misma red, un generador de carga y los cuatro productos.
Continúa la conversación
Comentarios
¿Preguntas sobre el método? ¿Un resultado distinto en tu hardware? Comparte lo que encontraste. Los comentarios se revisan antes de aparecer.