
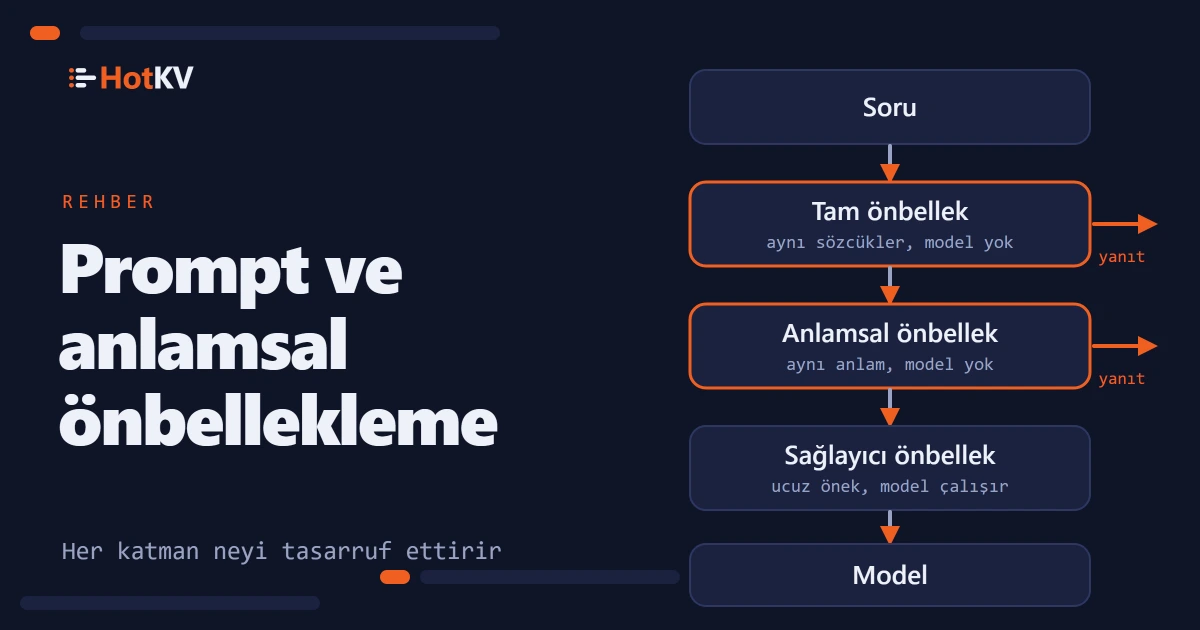
Dil modelleri için önbellekleme adı altında iki farklı şey satılır ve ekipler düzenli olarak birini alıp diğerini bekler. Prompt önbellekleme, tekrarlanan bir prompt önekinin okunmasını ucuzlatan bir sağlayıcı özelliğidir. Anlamsal önbellekleme ise bir soruyu bellekten yanıtlayan ve modelin hiç çağrılmamasını sağlayan, kendi çalıştırdığınız bir katmandır. Faturanın farklı yarılarını çözerler ve birlikte en iyi sonucu verirler.
Kısaca. Prompt önbellekleme, uzun bir sistem prompt'u gibi bir prompt'un tekrarlanan başlangıcında indirim yapar, ancak model yine çalışır ve her çıkış tokenı için yine ödersiniz. Birebir ve anlamsal önbellekleme, bir soru daha önce yanıtlandıysa çağrıyı tamamen ortadan kaldırır. Sağlayıcının prompt önbelleklemesi zaten açıkken yaptığımız 3.000 istekli kıyaslamada, önüne HotKV eklemek model çağrılarını, tokenları ve maliyeti yaklaşık %70 düşürdü; çünkü çıkış tokenları hâlâ temel maliyetin %73 ila %92'siydi.
Prompt önbellekleme nasıl çalışır
Prompt önbellekleme model sağlayıcısında yaşar. Bir isteğin sabit başlangıcını, genellikle araçları ve sistem prompt'unu, işaretlersiniz ve sağlayıcı bunun işlenmiş halini kısa bir süre saklar. Aynı metinle başlayan sonraki istek, o kısım için indirimli bir oranla faturalandırılır. Burada Anthropic'in sürümünü anlatıyoruz, çünkü ölçtüğümüz odur. Aşağıdaki ayrıntılar, 18 Ekim 2026'da denetlenen prompt önbellekleme belgelerinden gelir.
Neler önbelleğe alınır
Bir isabet birebir eşleşme gerektirir. cache_control ile işaretlediğiniz bloğa kadar ve onun dahil olduğu her blok, araçlar, sistem prompt'u, sonra iletiler sırasıyla aynı olmalıdır. Prompt'un başında tek bir karakteri değiştirirseniz, ondan sonrasının hepsi ıskalama olur. Sorunun kendisi en sonda gelir, bu nedenle önbelleğe alınan önekin parçası olmaz.
Asgari uzunluğun altındaki prompt'lar önbelleğe alınmaz ve hata döndürülmez. Kullandığımız güncel Claude modelleri, Fable 5.1, Opus 5.5, Sonnet 5.5 ve Haiku 5.5 için belgelenmiş asgari değer 512 tokendır. Önbellek girdileri kuruluş başına ve Claude API'de çalışma alanı başına yalıtılır.
Neye mal olur
Varsayılan ömür beş dakikadır ve girdinin her kullanımı onu ek ücret olmadan yeniler. Bir saatlik ömür de mevcuttur. Bir girdiyi yazmak, beş dakika için temel giriş fiyatının 1,25 katına, bir saat için 2 katına mal olur. Okumak ise fiyat sayfasına göre çoğu modelde temel giriş fiyatının 0,1 katına, Opus 5.5 ve Sonnet 5.5'te 0,05 katına, Fable 5.1'de 0,025 katına mal olur. Bu çarpanlar değişir; bu yüzden herhangi bir hesap yapmadan önce güncel sayfayı okuyun.
Prompt önbelleklemenin kaldıramadığı şey
Prompt önbellekleme, önekin okunmasında indirim yapar. Modeli atlamaz. Her istek yine yeni bir yanıt üretir, onu yine beklersiniz ve her çıkış tokenı tam çıkış fiyatıyla faturalandırılır.
Kıyaslamamız bunun ne kadar önemli olduğunu gösteriyor. Dört Claude modelinin her birine, sistem prompt'u olarak 2.200 tokenlık bir politikayla ve sağlayıcı önbellekleme açıkken 3.000 müşteri destek sorusu gönderdik. Sayılan tokenların %90 ila %93'ü o politikanın önbellek okumalarıydı. Çıktı tokenların yalnızca %6 ila %9'uydu, ama temel maliyetin %73 ila %92'siydi. Önek zaten ucuzdu; bu yüzden kalan harcama yanıtlardaydı.
Diğer katmanların doldurduğu boşluk budur. Yöntemin tamamı ve sonuçlar token tasarrufu kıyaslamasındadır.
Birebir ve anlamsal yanıt önbellekleme
İki katman bir isteği bellekten yanıtlar. Yeni bir isteğin eskisiyle eşleştiğine nasıl karar verdikleri bakımından farklıdırlar.
Birebir yanıt önbellekleme
Birebir bir önbellek, nihai yanıtı onu şekillendiren her şeyden oluşan bir anahtar altında saklar. Normalde bu, model, prompt sürümü ve normalleştirilmiş sorudur. Aynı istek yeniden geldiğinde saklanan yanıt döndürülür ve model çağrılmaz. Benzerlik skoru yoktur ve farklı bir soru için tasarlanmış bir yanıtı döndürme riski yoktur.
Bizim çalıştırmamızda birebir önbellek isteklerin yaklaşık %39'unu yanıtladı. Tekrarlanan bir soru ortancada yaklaşık 0,05 ms'de geri geldi. Bu, aynı makinede loopback üzerinden bir Python istemcisiyle ölçüldü; bu yüzden onu bir ağ değeri değil, yerel bir değer olarak okuyun. Kıyaslama bu katman için düz GET ve SET kullandı. HotKV Enterprise ayrıca ad alanı başına sınırlar ve maliyet izlemeli, özel bir birebir eşleşmeli prompt önbelleğine, PCACHE.*, sahiptir.
Birebir önbellekleme ifade biçimine kördür. "How do I reset my password?" ve "I forgot my password" iki farklı anahtardır.
Anlamsal önbellekleme
Anlamsal bir önbellek, sorunun anlamına bakar. Soruyu bir embedding'e dönüştürür, en yakın saklanan soruyu bulur ve kosinüs benzerliği bir eşiği aşarsa yanıtını döndürür. HotKV'de bu, vektör aramayla aynı vektör dizini üzerine kurulu SCACHE.*'tir.
İsteklerimizin yaklaşık %31'i bu yolla yanıtlandı. Bir yeniden ifade ortancada yaklaşık 130 ms sürdü; bunun neredeyse tamamı embedding servisine yapılan çağrıydı, bu yüzden bir anlamsal isabet model çağrısından çok daha hızlıdır ama anlık değildir. Anlamsal katman olmasaydı, tek başına birebir bir önbellek 3.000 içinden en fazla 1.264 model çağrısı gerektirirdi, yani yaklaşık %58 daha az. Anlamsal katman tasarrufu yaklaşık %70'e çıkardı.
Risk de buradadır. Benzer bir soru her zaman aynı soru değildir. İkinci bir Claude modelinin her anlamsal isabeti yeni bir yanıta karşı değerlendirmesini sağladık. 0,81 varsayılan eşiğimizde, önbellekteki yanıtlar tam soruya yeni olanlardan 5,8 ila 10,7 yüzde puan daha az sıklıkla uydu. Sonnet 5.5'te 0,88 ve üzerindeki eşiklerde, zayıf kanıtla, böyle bir açık görülmedi. Tek bir belirleyici ayrıntıyla farklılaşacak şekilde yazılmış sorular, 0,81'de yine %62, 0,95'te %10 oranında eşleşti.
Prompt önbellekleme ve anlamsal önbellekleme yan yana
| Sağlayıcı prompt önbelleklemesi | Birebir yanıt önbelleği | Anlamsal önbellek | |
|---|---|---|---|
| Neyi ortadan kaldırır | Giriş fiyatının bir kısmını | Model çağrısının tamamını | Model çağrısının tamamını |
| Eşleşme kuralı | Aynı önek | Aynı istek | Eşiğin üzerinde benzer anlam |
| Faturalandırılan çıkış tokenları | Evet, her seferinde | Hayır, isabette | Hayır, isabette |
| Yanlış yanıt riski | Yok | Aynı istekler için yok | Gerçek, eşikle ayarlanır |
| Nerede çalışır | Sağlayıcıda | Sizin önbelleğinizde | Sizin önbelleğinizde, artı bir embedding çağrısı |
| Çalıştırmamızdaki istek payı | Her zaman açık | Yaklaşık %39 | Yaklaşık %31 |
Sağlayıcı prompt önbellekleme ve yanıt önbellekleme birbirinin alternatifi değildir. Biri yapmaya devam ettiğiniz çağrıların fiyatını düşürür, diğeri kaç çağrı yaptığınızı azaltır.
Önbelleklemenin gecikmeye etkisi
Modeli atlamak, yanıtların maliyetini olduğu kadar ne kadar hızlı geldiğini de değiştirir. Çalıştırmamızda tam yanıta kadar geçen ortanca süre Fable 5.1'de 2,7 saniyeden 127 ms'ye, Opus 5.5'te 2,9 saniyeden 126 ms'ye, Sonnet 5.5'te 1,8 saniyeden 128 ms'ye ve Haiku 5.5'te 1,4 saniyeden 125 ms'ye düştü. Bu, ortancada 11 ila 23 kat daha hızlıdır.
Yavaş uç neredeyse hiç kıpırdamadı. İsteklerin yaklaşık %30'u hâlâ modele ulaştı ve Fable 5.1'de 99. yüzdelik, HotKV ile yaklaşık 6,4 saniye, onsuz 6,6 saniyeydi. Bir önbellek, yanıtladığı istekler için beklemeyi ortadan kaldırır ve ıskaladıkları için hiçbir şey yapmaz. Şikayetiniz yavaş bir tipik durum değil de yavaş bir en kötü durumsa, tek başına önbellekleme bunu çözmez.
Çağrılar akış olarak yapılmadığı için bunlar tam yanıta kadar geçen sürelerdir. Akış olarak gelen bir yanıt ilk sözcüklerini daha erken gösterir. Bir sohbet penceresindeki fark, bu sayılardaki farktan küçüktür.
Trafiğiniz için bir katman seçmek
Doğru katman isteklerinizin nasıl tekrarlandığına bağlıdır ve bunu bir şey kurmadan önce ölçebilirsiniz.
Katmanı trafiğe uydurun
Katmanı isteklerinizin nasıl tekrarlandığına uydurun.
- Uzun, sabit bir sistem prompt'u veya araç listesi: sağlayıcı prompt önbelleklemesini kullanın. Açmak ucuzdur ve hiçbir yanıtı değiştirmez.
- Aynı sözcüklerle aynı soru, örneğin bir düğme, bir şablon veya bir yeniden deneme: birebir bir yanıt önbelleği kullanın. Güvenli ve hızlıdır.
- İnsanların aynı şeyi farklı sözcüklerle sorduğu destek, arama ve SSS trafiği: bir anlamsal önbellek ekleyin, eşiği yüksek ayarlayın ve ona güvenmeden önce yanıt kalitesini kendi sorularınızda denetleyin.
- Kullanıcıya, saate veya canlı veriye bağlı yanıtlar: hiçbirini önbelleğe almayın ya da önbelleği yanıtı değiştiren olgulara göre anahtarlayın.
Tasarruf, tekrarı izler. Her amacı çarpık değil eşit olasılıklı yaptığımızda, yeniden çalıştırdığımız iki modelde maliyet %56 düştü ve 3.000 soru da birbirinden farklıyken %38 düştü. Tekrarlanan veya benzer sorusu olmayan bir iş yükü hiçbir şey tasarruf ettirmez.
Önce kendi tekrarınızı ölçün
Bir şey kurmadan önce trafiğinizin ne kadarının tekrarlandığını öğrenin. Bu sayı, birebir bir önbelleğe sahip olmaya değip değmeyeceğine karar verir. Zaten günlüğe kaydettiğiniz sorularla on dakika sürer. Her soruyu önbellek anahtarınızın yapacağı şekilde normalleştirin, farklı olanları sayın ve trafiğin ne kadarının tekrar olduğunu görün.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share, birebir bir önbelleğin, her soruyu ilk kez gördükten sonra yanıtlayacağı isteklerin oranıdır. Test kümemizde 3.000 istek arasında 1.264 farklı soru vardı; bu yüzden rakam yaklaşık %58'di. Sizinki %5 civarında çıkarsa, birebir bir önbellek pek bir şey yapmaz ve yalnızca anlamsal bir katman yardımcı olabilir.
İki uyarı geçerlidir. Bir önbellek boş başlar; bu yüzden ilk istekler her zaman modele ulaşır. Çalıştırmamızda ilk bin isteğin yaklaşık %52'si ve son bin isteğin yaklaşık %81'i önbellekten sunuldu. Ve geçen ayın trafiğinin bir günlüğü size geçen ayı anlatır. İnsanların ne sorduğunu değiştirecek bir özelliği yayına almak üzereyseniz, rakamı kabaca bir rehber olarak değerlendirin.
Katmanları bir araya getirmek
Bir istek katmanlardan en ucuz ve en güvenliden en pahalıya doğru geçmeli ve her birinin neyi tasarruf ettirdiğini görebilmelisiniz.
Arama sırası
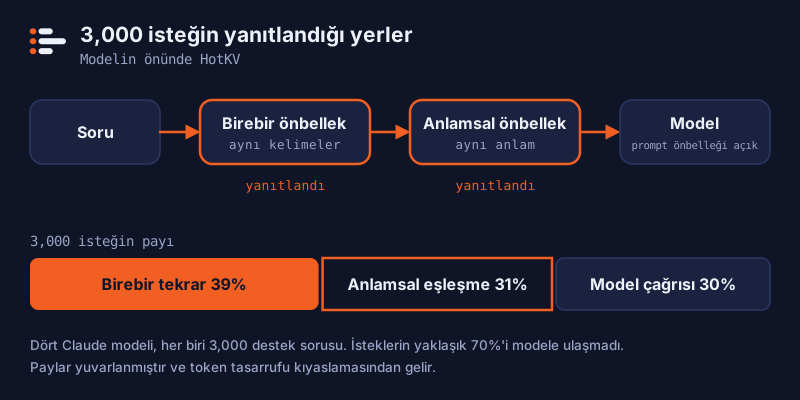
Sıra önemlidir. Önce en ucuz ve en güvenli katmanı denetleyin ve modeli yalnızca her şey ıskaladığında çağırın. Bu taslak, decode_responses=True ile redis-py tarzı bir istemci, önceden oluşturulmuş iki ad alanı ve kendi embed ile llm işlevlerinizi varsayar.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # aynı sözcükler

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # aynı anlam

    reply = llm.complete(question)                   # sağlayıcı prompt önbellekleme burada geçerli
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Ad alanlarını embedding modelinizin boyutunu kullanarak PCACHE.CREATE answers_exact ve SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90 ile bir kez oluşturun. Yapay zeka komut seti HotKV Cloud Performance ve Scale örnekleriyle birlikte gelir ve Yapay zeka sayfası her motorun ne yaptığını listeler. Fiyatlandırma sayfası hangi planın neyi içerdiğini gösterir.
Üretimde skor tutmak
Göremediğiniz bir önbelleğe güvenemezsiniz. HotKV ad alanı başına isabet ve ıskalama sayılarını tutar. Her girdiyle birlikte asıl çağrının token kullanımını saklarsanız, sonraki her isabetin önlediği tokenları ve maliyeti de atfedebilir. PCACHE.STATS ve SCACHE.STATS yanıtları o zaman usage_saved_requests, usage_saved_input_tokens ve usage_saved_cost_usd gibi alanlar taşır.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
<model> yerine modelinizin kimliğini yazın. INPUT önbelleğe alınmamış prompt tokenlarını ve CACHEREAD sağlayıcının kendi önbelleğinden sunduğu tokenları sayar; böylece ikisi çakışmaz. Maliyet alanının anlam taşıması için modelin HotKV'nin fiyat tablosunda olması gerekir. LLMSTATS.PRICE LIST hangi modellerin bilindiğini gösterir ve LLMSTATS.PRICE SET kendinizinkini ekler. Fiyatı olmayan bir modelin tokenları yine sayılır, ancak maliyeti sıfır olarak kaydedilir ve ayrı bir sayaç isteklerin fiyatlandırılmadığını gösterir.
Önbellekler harcamayı azaltır, bir bütçe de kalanı sınırlar. LLMBUDGET.SET bir zaman penceresinde bir token ve dolar sınırı tanımlar. LLMBUDGET.CONSUME model çağrısından önce denetlenir; böylece başıboş bir ajan parayı harcadıktan sonra değil, harcamadan önce durdurulur. LLMSTATS.RECORD sağlayıcının önbellek okuma ve önbellek yazma tokenlarını anlayan kiracı başına toplamları tutar. Üçü de model adını verdiğinizde tek bir fiyat tablosunu kullanır; böylece bir tasarruf, bir bütçe ve bir pano rakamı birbiriyle çelişemez.
Bir önbelleğin yanlış yanıt döndürmesine yol açan hatalar
Kötü önbellek isabetlerinin çoğu, bir şeyi eksik olan bir anahtardan gelir. Modeli, prompt sürümünü ve herhangi bir araç veya politika sürümünü birebir anahtara koyun; böylece bir prompt değişikliği eski olanı için yazılmış yanıtları sunamaz.
Girdilere, olgularınızın ne kadar hızlı değiştiğine uyan bir ömür verin. Bir müşterinin yanıtı asla bir başkasına sunulmasın diye kiracıları ayrı ad alanlarıyla ayrı tutun. Anahtar kimin verisi olduğunu içermedikçe kişisel veri içeren bir yanıtı asla önbelleğe almayın.
Son olarak, kendi trafiğinizde ölçün. Rakamlarımız kısa bankacılık sorularından oluşan tek bir herkese açık veri kümesinden, kurgusal bir politikadan ve koşul başına bir çalıştırmadan geliyor; iş yükünüz için bir söz değildir.
Sık sorulan sorular
Prompt önbellekleme nedir?
Prompt önbellekleme, bir prompt'un işlenmiş başlangıcını kısa bir süre saklayan bir model sağlayıcı özelliğidir. Birebir aynı metinle başlayan sonraki istek, o kısım için daha düşük bir oranla faturalandırılır. Model yine çalışır ve yeni bir yanıt üretir; bu yüzden çıkış tokenları için yine ödersiniz.
Prompt önbellekleme anlamsal önbellekleme ile aynı mı?
Hayır. Prompt önbellekleme tekrarlanan bir prompt önekini yeniden kullanır ve modeli yine çağırır. Anlamsal önbellekleme, benzer anlamlı bir soruya saklanan yanıtı döndürür ve model çağrısını atlar. Farklı maliyetleri ele alırlar ve birlikte kullanılabilirler.
Prompt önbellekleme çıkış tokenı maliyetlerini azaltır mı?
Hayır. Yalnızca önbelleğe alınmış önekin okunma fiyatını düşürür. Kıyaslamamızda, prompt önbellekleme zaten açıkken çıktı tokenların %6 ila %9'uydu ama temel maliyetin %73 ila %92'siydi; bu yüzden tüm yanıtları önbelleğe almak çok daha fazla tasarruf ettirdi.
Anthropic'in prompt önbelleği ne kadar sürer?
Varsayılan beş dakikadır ve girdi her kullanıldığında yenilenir. Daha yüksek bir yazma fiyatıyla bir saatlik bir seçenek mevcuttur. Sınırlar ve fiyatlar değiştiği için güncel belgelere bakın.
Prompt önbellekleme ve anlamsal önbelleklemeyi birlikte kullanabilir miyim?
Evet, kıyaslamamız tam olarak bunu yaptı. Sağlayıcı prompt önbellekleme iki çalıştırmada da açık kaldı ve anlamsal ile birebir katmanlar modelin önünde durdu. Önbellek isabetleri çağrıyı atlar, ıskalamalar yine indirimli önekten yararlanır.
Bir anlamsal önbellek hangi benzerlik eşiğini kullanmalı?
Evrensel bir değer yoktur. Biz ayrı bir eğitim bölümünde 0,81'i seçtik ve Sonnet 5.5'te, zayıf kanıtla, önbellekteki yanıtlar 0,88 ve üzerinde yeni olanlara göre bir kalite açığı göstermedi. Yüksekten başlayın, önbellekteki yanıtları yeni olanlara karşı kendi sorularınızda değerlendirin ve eşiği yalnızca kalite korunuyorsa düşürün.
Sohbete devam edin
Yorumlar
Yöntemle ilgili sorularınız mı var? Donanımınızda farklı bir sonuç mu aldınız? Bulduklarınızı paylaşın. Yorumlar görünmeden önce incelenir.