
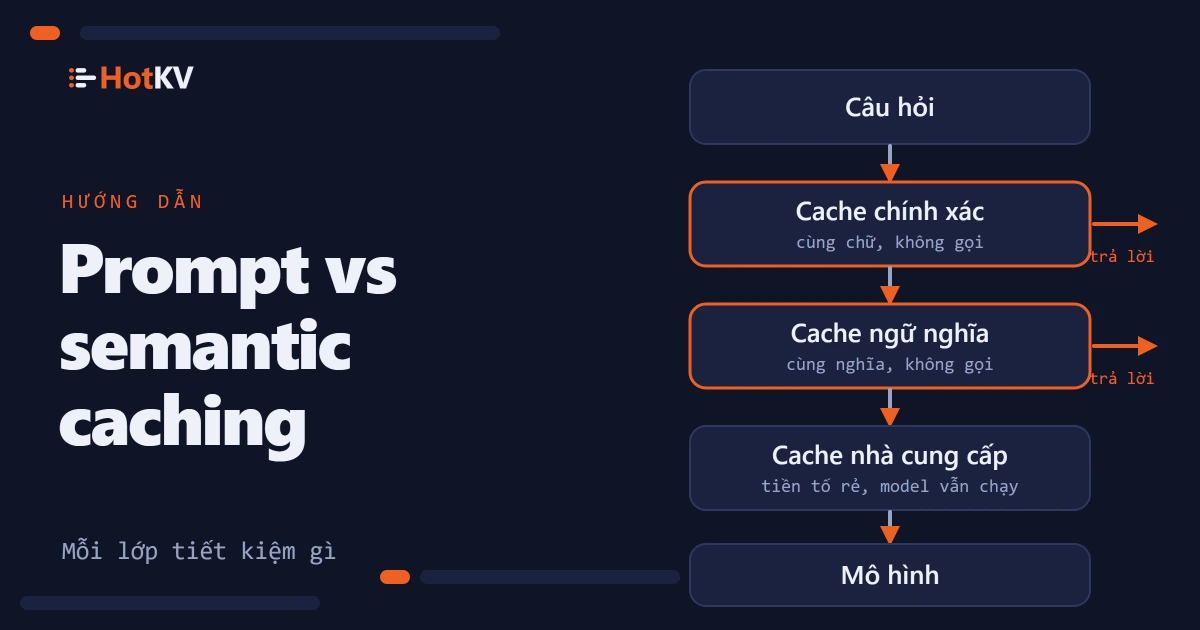
Có hai thứ khác nhau được bán dưới tên caching cho mô hình ngôn ngữ, và các nhóm thường mua thứ này nhưng mong đợi thứ kia. Prompt caching là một tính năng của nhà cung cấp làm cho tiền tố prompt lặp lại rẻ hơn khi đọc. Semantic caching là một tầng bạn tự chạy, trả lời câu hỏi từ bộ nhớ để mô hình không bao giờ được gọi. Chúng giải quyết hai nửa khác nhau của hóa đơn, và chúng hiệu quả nhất khi dùng cùng nhau.
Tóm lại. Prompt caching giảm giá phần đầu lặp lại của một prompt, như một system prompt dài, nhưng mô hình vẫn chạy và bạn vẫn trả tiền cho mọi token đầu ra. Cache khớp chính xác và cache ngữ nghĩa loại bỏ hoàn toàn lần gọi khi một câu hỏi đã được trả lời trước đó. Trong benchmark 3,000 yêu cầu của chúng tôi khi prompt caching của nhà cung cấp đã bật sẵn, việc thêm HotKV phía trước đã cắt giảm số lần gọi mô hình, token và chi phí khoảng 70%, vì token đầu ra vẫn chiếm 73% đến 92% chi phí đường cơ sở.
Prompt caching hoạt động như thế nào
Prompt caching nằm ở phía nhà cung cấp mô hình. Bạn đánh dấu phần đầu ổn định của một yêu cầu, thường là các công cụ và system prompt, và nhà cung cấp lưu dạng đã xử lý của nó trong một thời gian ngắn. Yêu cầu tiếp theo bắt đầu bằng đúng văn bản đó được tính phí ở mức giảm cho phần ấy. Ở đây chúng tôi mô tả phiên bản của Anthropic vì đó là phiên bản chúng tôi đã đo. Các chi tiết bên dưới lấy từ tài liệu prompt caching của họ, được kiểm tra vào ngày 18 tháng Mười năm 2026.
Những gì được cache
Một lần trúng cần khớp chính xác. Mọi khối cho đến và bao gồm khối bạn đánh dấu bằng cache_control phải giống hệt, theo thứ tự công cụ, system prompt, rồi tin nhắn. Đổi một ký tự sớm trong prompt và mọi thứ sau đó đều trượt. Bản thân câu hỏi đứng cuối cùng, nên nó không bao giờ là một phần của tiền tố được cache.
Các prompt dưới một độ dài tối thiểu không được cache và không có lỗi nào trả về. Với các mô hình Claude hiện tại chúng tôi đã dùng, Fable 5.1, Opus 5.5, Sonnet 5.5 và Haiku 5.5, mức tối thiểu được ghi trong tài liệu là 512 token. Các mục cache được cô lập theo từng tổ chức, và theo từng workspace trên Claude API.
Nó tốn bao nhiêu
Thời gian sống mặc định là năm phút, và mỗi lần dùng mục đó sẽ làm mới nó mà không tính thêm phí. Có sẵn tùy chọn thời gian sống một giờ. Ghi một mục tốn 1.25 lần giá đầu vào cơ sở cho năm phút và 2 lần cho một giờ. Đọc nó tốn 0.1 lần giá đầu vào cơ sở trên hầu hết các mô hình, 0.05 lần trên Opus 5.5 và Sonnet 5.5, và 0.025 lần trên Fable 5.1, theo trang bảng giá. Các hệ số đó thay đổi, nên hãy đọc trang hiện tại trước khi bạn tính toán gì.
Những gì prompt caching không thể loại bỏ
Prompt caching giảm giá việc đọc tiền tố. Nó không bỏ qua mô hình. Mỗi yêu cầu vẫn tạo ra một câu trả lời mới, bạn vẫn phải chờ nó, và mọi token đầu ra vẫn bị tính theo giá đầu ra đầy đủ.
Benchmark của chúng tôi cho thấy điều đó quan trọng đến mức nào. Chúng tôi gửi 3,000 câu hỏi hỗ trợ khách hàng tới mỗi trong bốn mô hình Claude với một chính sách 2,200 token làm system prompt và caching của nhà cung cấp được bật. Từ 90% đến 93% số token được tính là các lần đọc cache của chính sách đó. Đầu ra chỉ là 6% đến 9% số token, nhưng lại là 73% đến 92% chi phí đường cơ sở. Tiền tố vốn đã rẻ, nên phần chi tiêu còn lại nằm ở các câu trả lời.
Đó là khoảng trống mà các tầng khác lấp đầy. Phương pháp và kết quả đầy đủ nằm trong benchmark tiết kiệm token.
Cache phản hồi khớp chính xác và ngữ nghĩa
Hai tầng trả lời một yêu cầu từ bộ nhớ. Chúng khác nhau ở cách quyết định một yêu cầu mới khớp với một yêu cầu cũ.
Cache phản hồi khớp chính xác
Một cache khớp chính xác lưu câu trả lời cuối cùng dưới một khóa được tạo từ mọi thứ định hình nó. Thông thường đó là mô hình, phiên bản prompt và câu hỏi đã chuẩn hóa. Khi cùng một yêu cầu đến lần nữa, câu trả lời đã lưu được trả về và mô hình không được gọi. Không có điểm tương đồng và không có nguy cơ trả về câu trả lời dành cho một câu hỏi khác.
Trong lần chạy của chúng tôi, cache khớp chính xác đã trả lời khoảng 39% số yêu cầu. Một câu hỏi lặp lại trả về trong trung vị khoảng 0.05 ms. Con số đó được đo bằng một client Python qua loopback trên cùng một máy, nên hãy đọc nó như một số liệu cục bộ chứ không phải qua mạng. Benchmark dùng GET và SET thuần túy cho tầng này. HotKV Enterprise cũng có một prompt cache khớp chính xác chuyên dụng, PCACHE.*, với giới hạn theo từng namespace và theo dõi chi phí.
Cache khớp chính xác không nhìn thấy cách diễn đạt. "How do I reset my password?" và "I forgot my password" là hai khóa khác nhau.
Semantic caching
Một semantic cache tra cứu ý nghĩa của câu hỏi. Nó biến câu hỏi thành một embedding, tìm câu hỏi đã lưu gần nhất và trả về câu trả lời của nó nếu độ tương đồng cosine vượt một ngưỡng. Trong HotKV đó là SCACHE.*, xây trên cùng chỉ mục vector với tìm kiếm vector.
Khoảng 31% số yêu cầu của chúng tôi được trả lời theo cách này. Một câu diễn đạt lại mất trung vị khoảng 130 ms, gần như toàn bộ là lần gọi tới dịch vụ embedding, nên một lần trúng ngữ nghĩa nhanh hơn nhiều so với một lần gọi mô hình nhưng không phải tức thì. Nếu không có tầng ngữ nghĩa, riêng cache khớp chính xác sẽ cần tối đa 1,264 lần gọi mô hình trên 3,000, ít hơn khoảng 58%. Tầng ngữ nghĩa đưa mức tiết kiệm lên khoảng 70%.
Đó cũng là nơi rủi ro nằm. Một câu hỏi tương tự không phải lúc nào cũng là cùng một câu hỏi. Chúng tôi để một mô hình Claude thứ hai chấm mọi lần trúng ngữ nghĩa so với một câu trả lời mới. Ở ngưỡng mặc định 0.81 của chúng tôi, các câu trả lời từ cache phù hợp với đúng câu hỏi ít hơn câu trả lời mới từ 5.8 đến 10.7 điểm phần trăm. Trên Sonnet 5.5, các ngưỡng từ 0.88 trở lên không cho thấy mức thiếu hụt như vậy, với bằng chứng mỏng. Các câu hỏi được viết để khác nhau chỉ ở một chi tiết quyết định vẫn khớp 62% số lần ở 0.81 và 10% ở 0.95.
Prompt caching và semantic caching đặt cạnh nhau
| Prompt caching của nhà cung cấp | Cache phản hồi khớp chính xác | Semantic cache | |
|---|---|---|---|
| Nó loại bỏ gì | Một phần giá đầu vào | Toàn bộ lần gọi mô hình | Toàn bộ lần gọi mô hình |
| Quy tắc khớp | Tiền tố giống hệt | Yêu cầu giống hệt | Ý nghĩa tương tự trên một ngưỡng |
| Token đầu ra bị tính phí | Có, mọi lần | Không, khi trúng | Không, khi trúng |
| Rủi ro câu trả lời sai | Không có | Không có với yêu cầu giống hệt | Có thật, được điều chỉnh bằng ngưỡng |
| Chạy ở đâu | Tại nhà cung cấp | Trong cache của bạn | Trong cache của bạn, cộng một lần gọi embedding |
| Tỷ lệ yêu cầu trong lần chạy của chúng tôi | Luôn bật | Khoảng 39% | Khoảng 31% |
Prompt caching của nhà cung cấp và cache phản hồi không phải là các lựa chọn thay thế nhau. Một cái giảm giá của các lần gọi bạn vẫn thực hiện, và cái kia giảm số lần gọi bạn thực hiện.
Caching làm gì với độ trễ
Bỏ qua mô hình thay đổi cả tốc độ câu trả lời đến lẫn chi phí. Trong lần chạy của chúng tôi, thời gian trung vị để có một câu trả lời hoàn chỉnh giảm từ 2.7 giây xuống 127 ms trên Fable 5.1, từ 2.9 giây xuống 126 ms trên Opus 5.5, từ 1.8 giây xuống 128 ms trên Sonnet 5.5 và từ 1.4 giây xuống 125 ms trên Haiku 5.5. Đó là nhanh hơn 11 đến 23 lần ở trung vị.
Đầu chậm hầu như không đổi. Khoảng 30% số yêu cầu vẫn tới mô hình, và phân vị thứ 99 trên Fable 5.1 là khoảng 6.4 giây khi có HotKV so với 6.6 giây khi không có. Một cache loại bỏ thời gian chờ cho các yêu cầu nó trả lời và không làm gì cho những yêu cầu nó trượt. Nếu điều bạn phàn nàn là trường hợp xấu nhất chậm chứ không phải trường hợp điển hình chậm, riêng caching sẽ không khắc phục được.
Đây là thời gian tới câu trả lời hoàn chỉnh, vì các lệnh gọi không được streaming. Một câu trả lời được streaming hiện những từ đầu tiên sớm hơn. Khoảng cách trong một cửa sổ chat nhỏ hơn khoảng cách trong các con số này.
Chọn một tầng cho lưu lượng của bạn
Tầng phù hợp phụ thuộc vào cách các yêu cầu của bạn lặp lại, và bạn có thể đo điều đó trước khi xây bất cứ thứ gì.
Khớp tầng với lưu lượng
Hãy khớp tầng với cách các yêu cầu của bạn lặp lại.
- Một system prompt hoặc danh sách công cụ dài, ổn định: dùng prompt caching của nhà cung cấp. Bật nó tốn ít và không thay đổi câu trả lời nào.
- Cùng một câu hỏi bằng cùng từ ngữ, như một nút bấm, một mẫu hoặc một lần thử lại: dùng cache phản hồi khớp chính xác. Nó an toàn và nhanh.
- Lưu lượng hỗ trợ, tìm kiếm và FAQ nơi mọi người hỏi cùng một điều bằng từ ngữ khác nhau: thêm một semantic cache, đặt ngưỡng cao và kiểm tra chất lượng câu trả lời trên chính các câu hỏi của bạn trước khi tin tưởng nó.
- Câu trả lời phụ thuộc vào người dùng, đồng hồ hoặc dữ liệu trực tiếp: đừng cache cái nào trong số đó, hoặc định khóa cache theo những dữ kiện làm thay đổi câu trả lời.
Mức tiết kiệm đi theo sự lặp lại. Khi chúng tôi làm cho mọi ý định có khả năng như nhau thay vì lệch, chi phí giảm 56% trên hai mô hình chúng tôi chạy lại, và với 3,000 câu hỏi đều khác nhau thì giảm 38%. Một khối lượng công việc không có câu hỏi lặp lại hay tương tự thì không tiết kiệm được gì.
Đo mức lặp lại của chính bạn trước
Trước khi xây bất cứ thứ gì, hãy tìm hiểu bao nhiêu lưu lượng của bạn lặp lại. Con số đó quyết định liệu một cache khớp chính xác có đáng có không. Mất mười phút với những câu hỏi bạn vốn đã ghi log. Chuẩn hóa từng câu hỏi theo cách khóa cache của bạn sẽ làm, đếm số câu riêng biệt, và xem bao nhiêu lưu lượng là lặp lại.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share là phần các yêu cầu mà một cache khớp chính xác sẽ trả lời được, sau khi nó đã thấy mỗi câu hỏi lần đầu. Tập kiểm thử của chúng tôi có 1,264 câu hỏi riêng biệt trong 3,000 yêu cầu, nên con số là khoảng 58%. Nếu của bạn ra gần 5%, một cache khớp chính xác sẽ làm được ít, và chỉ một tầng ngữ nghĩa mới giúp được.
Có hai lưu ý. Một cache bắt đầu rỗng, nên các yêu cầu đầu luôn tới mô hình. Trong lần chạy của chúng tôi, khoảng 52% trong một nghìn yêu cầu đầu tiên được phục vụ từ cache và khoảng 81% trong một nghìn yêu cầu cuối. Và log lưu lượng tháng trước chỉ cho bạn biết về tháng trước. Nếu bạn sắp ra mắt một tính năng làm thay đổi điều mọi người hỏi, hãy coi con số là một hướng dẫn sơ bộ.
Kết hợp các tầng với nhau
Một yêu cầu nên đi qua các tầng từ rẻ nhất và an toàn nhất đến đắt nhất, và bạn nên thấy được mỗi tầng đã tiết kiệm gì.
Thứ tự tra cứu
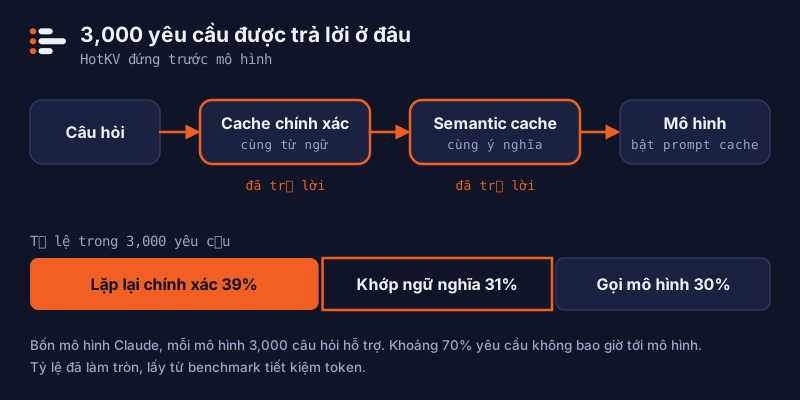
Thứ tự rất quan trọng. Kiểm tra tầng rẻ nhất và an toàn nhất trước và chỉ gọi mô hình khi mọi thứ đều trượt. Đoạn phác thảo này giả định một client kiểu redis-py với decode_responses=True, hai namespace được tạo trước và các hàm embed và llm của riêng bạn.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # same words

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # same meaning

    reply = llm.complete(question)                   # provider prompt caching applies here
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Tạo các namespace một lần bằng PCACHE.CREATE answers_exact và SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, dùng số chiều của mô hình embedding của bạn. Bộ lệnh AI đi kèm các instance HotKV Cloud Performance và Scale, và trang AI liệt kê mỗi engine làm gì. Trang bảng giá cho thấy gói nào bao gồm gì.
Theo dõi điểm số trong production
Một cache bạn không thấy được là một cache bạn không thể tin. HotKV giữ số lần trúng và trượt theo từng namespace. Nếu bạn lưu mức sử dụng token của lần gọi gốc cùng mỗi mục, nó cũng có thể quy cho mỗi lần trúng sau đó số token và chi phí đã tránh được. Khi đó các phản hồi PCACHE.STATS và SCACHE.STATS mang các trường như usage_saved_requests, usage_saved_input_tokens và usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Thay <model> bằng id mô hình của bạn. INPUT đếm các token prompt không được cache và CACHEREAD đếm các token mà nhà cung cấp phục vụ từ cache của chính họ, nên hai thứ không chồng lấp. Mô hình phải nằm trong bảng giá của HotKV thì trường chi phí mới có ý nghĩa. LLMSTATS.PRICE LIST cho thấy những mô hình nào đã biết, và LLMSTATS.PRICE SET thêm mô hình của riêng bạn. Một mô hình không có giá vẫn được đếm token, nhưng chi phí của nó được ghi là không và một bộ đếm riêng cho thấy các yêu cầu chưa được định giá.
Cache giảm chi tiêu, và ngân sách đặt trần cho phần còn lại. LLMBUDGET.SET định nghĩa giới hạn token và đô la trong một cửa sổ thời gian. LLMBUDGET.CONSUME được kiểm tra trước lần gọi mô hình, nên một agent mất kiểm soát bị chặn trước khi nó tiêu tiền, không phải sau. LLMSTATS.RECORD giữ tổng theo từng tenant, hiểu được các token đọc cache và ghi cache của nhà cung cấp. Cả ba dùng một bảng giá khi bạn truyền tên mô hình, nên một khoản tiết kiệm, một ngân sách và một con số trên dashboard không thể mâu thuẫn nhau.
Những sai lầm khiến cache trả về câu trả lời sai
Hầu hết các lần trúng cache tệ đến từ một khóa thiếu một thứ gì đó. Hãy đưa mô hình, phiên bản prompt và mọi phiên bản công cụ hoặc chính sách vào khóa chính xác, để một thay đổi prompt không thể phục vụ các câu trả lời viết cho prompt cũ.
Cho các mục một thời gian sống phù hợp với tốc độ thay đổi của các dữ kiện của bạn. Giữ các tenant tách biệt bằng các namespace riêng để câu trả lời của một khách hàng không bao giờ được đưa cho khách hàng khác. Đừng bao giờ cache một câu trả lời chứa dữ liệu cá nhân trừ khi khóa bao gồm dữ liệu đó của ai.
Cuối cùng, hãy đo trên lưu lượng của chính bạn. Số liệu của chúng tôi đến từ một tập dữ liệu công khai gồm các câu hỏi ngân hàng ngắn, một chính sách hư cấu và một lần chạy cho mỗi điều kiện, và chúng không phải là lời hứa cho khối lượng công việc của bạn.
Câu hỏi thường gặp
Prompt caching là gì?
Prompt caching là một tính năng của nhà cung cấp mô hình lưu phần đầu đã xử lý của một prompt trong một thời gian ngắn. Một yêu cầu sau đó bắt đầu bằng đúng cùng văn bản được tính phí ở mức thấp hơn cho phần ấy. Mô hình vẫn chạy và tạo ra câu trả lời mới, nên bạn vẫn trả tiền cho token đầu ra.
Prompt caching có giống semantic caching không?
Không. Prompt caching tái sử dụng một tiền tố prompt lặp lại và vẫn gọi mô hình. Semantic caching trả về câu trả lời đã lưu cho một câu hỏi có ý nghĩa tương tự và bỏ qua lần gọi mô hình. Chúng nhắm vào các chi phí khác nhau và có thể dùng cùng nhau.
Prompt caching có giảm chi phí token đầu ra không?
Không. Nó chỉ hạ giá việc đọc tiền tố được cache. Trong benchmark của chúng tôi, đầu ra là 6% đến 9% số token nhưng là 73% đến 92% chi phí đường cơ sở khi prompt caching đã bật sẵn, đó là lý do cache cả câu trả lời tiết kiệm nhiều hơn rất nhiều.
Prompt cache của Anthropic kéo dài bao lâu?
Mặc định là năm phút, được làm mới mỗi khi mục được dùng. Có tùy chọn một giờ với giá ghi cao hơn. Hãy kiểm tra tài liệu hiện tại, vì giới hạn và giá thay đổi.
Tôi có thể dùng prompt caching và semantic caching cùng nhau không?
Có, và benchmark của chúng tôi đã làm đúng như vậy. Prompt caching của nhà cung cấp vẫn bật trong cả hai lần chạy, và các tầng ngữ nghĩa và khớp chính xác đứng trước mô hình. Các lần trúng cache bỏ qua lệnh gọi, và các lần trượt vẫn được hưởng tiền tố giảm giá.
Semantic cache nên dùng ngưỡng tương đồng nào?
Không có giá trị chung cho mọi trường hợp. Chúng tôi chọn 0.81 trên một tập huấn luyện riêng, và trên Sonnet 5.5 các câu trả lời từ cache không cho thấy mức thiếu hụt chất lượng so với câu trả lời mới từ 0.88 trở lên, với bằng chứng mỏng. Hãy bắt đầu cao, chấm các câu trả lời từ cache so với câu trả lời mới trên chính các câu hỏi của bạn, và chỉ hạ ngưỡng nếu chất lượng vẫn giữ được.
Tiếp tục cuộc trò chuyện
Bình luận
Có câu hỏi về phương pháp? Kết quả khác trên phần cứng của bạn? Hãy chia sẻ những gì bạn tìm thấy. Bình luận được duyệt trước khi hiển thị.