
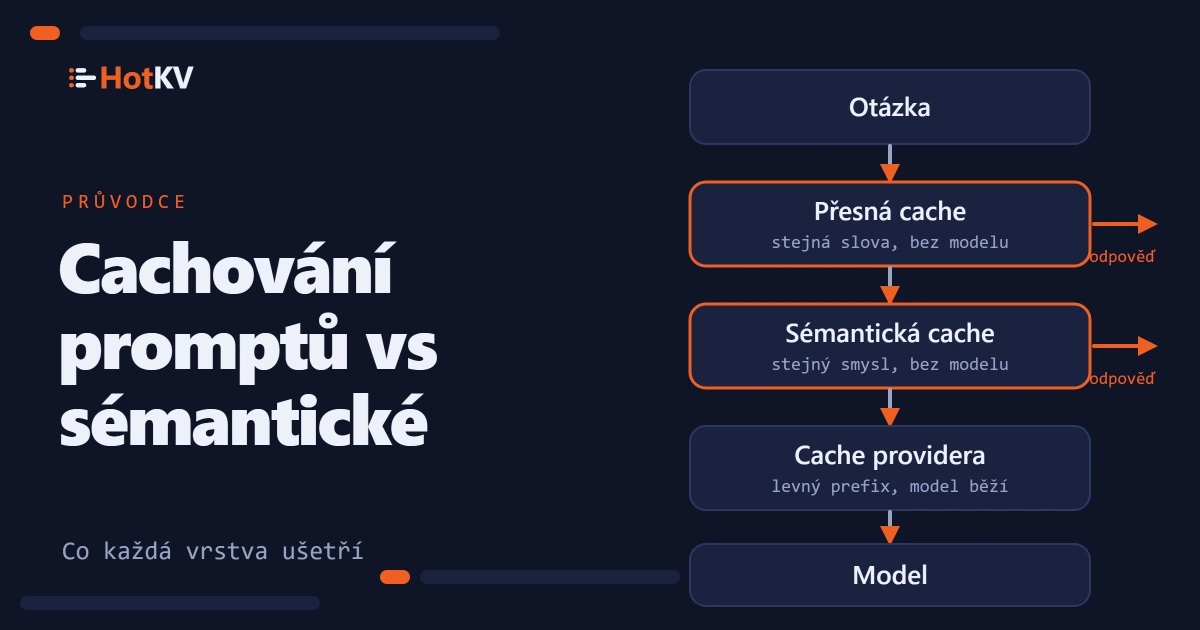
Pod názvem cachování pro jazykové modely se prodávají dvě různé věci a týmy si pravidelně koupí jednu a čekají druhou. Cachování promptů je funkce poskytovatele, která zlevní čtení opakovaného prefixu promptu. Sémantické cachování je vrstva, kterou provozujete sami a která odpoví na otázku z paměti, takže se model nikdy nevolá. Řeší různé poloviny účtu a nejlépe fungují společně.
Stručně. Cachování promptů zlevňuje opakovaný začátek promptu, například dlouhý systémový prompt, ale model se stále spouští a za každý výstupní token stále platíte. Cachování s přesnou shodou a sémantické cachování volání zcela odstraní, když na otázku už bylo odpovězeno. V našem benchmarku s 3 000 požadavky, s už zapnutým cachováním promptů poskytovatele, snížilo předsazení HotKV počet volání modelu, tokenů i náklady zhruba o 70 %, protože výstupní tokeny tvořily stále 73 % až 92 % základních nákladů.
Jak funguje cachování promptů
Cachování promptů žije u poskytovatele modelu. Označíte stabilní začátek požadavku, obvykle nástroje a systémový prompt, a poskytovatel jeho zpracovanou podobu na krátkou dobu uloží. Další požadavek, který začíná identickým textem, se u této části účtuje se sníženou sazbou. Popisujeme tady verzi od Anthropicu, protože právě tu jsme měřili. Podrobnosti níže pocházejí z její dokumentace cachování promptů, ověřené 18. října 2026.
Co se cachuje
Zásah vyžaduje přesnou shodu. Každý blok až po ten, který jste označili pomocí cache_control, včetně něj, musí být identický, v pořadí nástroje, systémový prompt, pak zprávy. Změňte jediný znak brzy v promptu a všechno za ním je minutí. Samotná otázka je až poslední, takže nikdy není součástí cachovaného prefixu.
Prompty pod minimální délkou se necachují a žádná chyba se nevrací. U aktuálních modelů Claude, které jsme použili, Fable 5.1, Opus 5.5, Sonnet 5.5 a Haiku 5.5, je zdokumentované minimum 512 tokenů. Položky cache jsou izolované pro každou organizaci a v Claude API pro každý workspace.
Kolik to stojí
Výchozí životnost je pět minut a každé použití položky ji bez dalšího poplatku obnoví. K dispozici je jednohodinová životnost. Zápis položky stojí 1,25násobek základní vstupní ceny na pět minut a 2násobek na jednu hodinu. Čtení stojí 0,1násobek základní vstupní ceny u většiny modelů, 0,05násobek u Opus 5.5 a Sonnet 5.5 a 0,025násobek u Fable 5.1, podle stránky s ceníkem. Tyto násobky se mění, proto si před jakýmkoli počítáním přečtěte aktuální stránku.
Co cachování promptů odstranit neumí
Cachování promptů zlevňuje čtení prefixu. Model nepřeskakuje. Každý požadavek stále vytváří novou odpověď, stále na ni čekáte a každý výstupní token se účtuje plnou výstupní cenou.
Náš benchmark ukazuje, jak moc na tom záleží. Poslali jsme 3 000 otázek zákaznické podpory každému ze čtyř modelů Claude se 2 200 tokeny politiky jako systémovým promptem a s cachováním poskytovatele zapnutým. Mezi 90 % a 93 % započtených tokenů tvořila čtení této politiky z cache. Výstup byl jen 6 % až 9 % tokenů, přesto tvořil 73 % až 92 % základních nákladů. Prefix už byl levný, takže zbylé výdaje seděly v odpovědích.
To je mezera, kterou vyplňují ostatní vrstvy. Úplná metodika a výsledky jsou v benchmarku úspor tokenů.
Cachování odpovědí s přesnou a sémantickou shodou
Dvě vrstvy odpovídají na požadavek z paměti. Liší se tím, jak rozhodují, že nový požadavek odpovídá starému.
Cachování odpovědí s přesnou shodou
Cache s přesnou shodou ukládá konečnou odpověď pod klíčem sestaveným ze všeho, co ji ovlivňuje. Normálně to je model, verze promptu a normalizovaná otázka. Když stejný požadavek přijde znovu, vrátí se uložená odpověď a model se nevolá. Neexistuje skóre podobnosti ani riziko, že se vrátí odpověď určená pro jinou otázku.
V našem běhu odpověděla cache s přesnou shodou na zhruba 39 % požadavků. Opakovaná otázka se vrátila za mediánových zhruba 0,05 ms. To bylo změřeno klientem v Pythonu přes loopback na stejném stroji, takže to berte jako lokální číslo, ne síťové. Benchmark pro tuto vrstvu používal prosté GET a SET. HotKV Enterprise má také vyhrazenou cache promptů s přesnou shodou, PCACHE.*, s limity pro každý jmenný prostor a sledováním nákladů.
Cachování s přesnou shodou je slepé k formulaci. „Jak si resetuji heslo?“ a „Zapomněl jsem heslo“ jsou dva různé klíče.
Sémantické cachování
Sémantická cache vyhledává podle významu otázky. Převede otázku na embedding, najde nejbližší uloženou otázku a vrátí její odpověď, pokud kosinová podobnost překročí práh. V HotKV je to SCACHE.*, postavené na stejném vektorovém indexu jako vektorové vyhledávání.
Tímto způsobem se odpovědělo na zhruba 31 % našich požadavků. Přeformulování trvalo mediánově zhruba 130 ms, téměř celé to bylo volání služby embeddingů, takže sémantický zásah je mnohem rychlejší než volání modelu, ale ne okamžitý. Bez sémantické vrstvy by samotná cache s přesnou shodou potřebovala nanejvýš 1 264 volání modelu ze 3 000, tedy zhruba o 58 % méně. Sémantická vrstva zvedla úsporu na zhruba 70 %.
Je to také místo, kde sídlí riziko. Podobná otázka není vždy stejná otázka. Nechali jsme druhý model Claude posoudit každý sémantický zásah proti čerstvé odpovědi. Při našem výchozím prahu 0,81 seděly odpovědi z cache na přesnou otázku o 5,8 až 10,7 procentního bodu méně často než čerstvé. U Sonnet 5.5 ukázaly prahy 0,88 a vyšší žádný takový deficit, s tenkými důkazy. Otázky napsané tak, aby se lišily jedním rozhodujícím detailem, se při 0,81 stále shodovaly v 62 % případů a při 0,95 v 10 %.
Cachování promptů vs sémantické cachování vedle sebe
| Cachování promptů u poskytovatele | Cache odpovědí s přesnou shodou | Sémantická cache | |
|---|---|---|---|
| Co odstraní | Část vstupní ceny | Celé volání modelu | Celé volání modelu |
| Pravidlo shody | Identický prefix | Identický požadavek | Podobný význam nad prahem |
| Účtované výstupní tokeny | Ano, pokaždé | Ne, při zásahu | Ne, při zásahu |
| Riziko špatné odpovědi | Žádné | Žádné u identických požadavků | Skutečné, ladí se prahem |
| Kde běží | U poskytovatele | Ve vaší cache | Ve vaší cache, plus volání embeddingu |
| Podíl požadavků v našem běhu | Vždy zapnuto | Zhruba 39 % | Zhruba 31 % |
Cachování promptů u poskytovatele a cachování odpovědí nejsou alternativy. Jedno snižuje cenu volání, která stále provádíte, a druhé snižuje jejich počet.
Co cachování dělá s latencí
Přeskočení modelu mění nejen cenu, ale i to, jak rychle odpovědi přicházejí. V našem běhu klesl mediánový čas do úplné odpovědi z 2,7 sekundy na 127 ms u Fable 5.1, z 2,9 sekundy na 126 ms u Opus 5.5, z 1,8 sekundy na 128 ms u Sonnet 5.5 a z 1,4 sekundy na 125 ms u Haiku 5.5. To je 11 až 23krát rychleji v mediánu.
Pomalý konec se téměř nepohnul. Zhruba 30 % požadavků stále dorazilo k modelu a 99. percentil u Fable 5.1 byl s HotKV zhruba 6,4 sekundy proti 6,6 sekundy bez něj. Cache odstraní čekání u požadavků, na které odpoví, a u těch, které mine, nedělá nic. Pokud si stěžujete na pomalý nejhorší případ, a ne na pomalý typický případ, samotné cachování to nespraví.
Jsou to časy do úplné odpovědi, protože volání nebyla streamována. Streamovaná odpověď ukáže první slova dřív. Rozdíl v chatovacím okně je menší než rozdíl v těchto číslech.
Výběr vrstvy pro váš provoz
Správná vrstva závisí na tom, jak se vaše požadavky opakují, a můžete to změřit, než cokoli postavíte.
Přizpůsobte vrstvu provozu
Přizpůsobte vrstvu tomu, jak se vaše požadavky opakují.
- Dlouhý, stabilní systémový prompt nebo seznam nástrojů: použijte cachování promptů u poskytovatele. Zapnutí stojí málo a žádné odpovědi nemění.
- Stejná otázka stejnými slovy, například tlačítko, šablona nebo opakování: použijte cache odpovědí s přesnou shodou. Je bezpečná a rychlá.
- Provoz podpory, vyhledávání a FAQ, kde se lidé ptají na totéž různými slovy: přidejte sémantickou cache, nastavte práh vysoko a než jí uvěříte, ověřte kvalitu odpovědí na vlastních otázkách.
- Odpovědi, které závisejí na uživateli, hodinách nebo živých datech: necachujte žádnou z nich, nebo klíč cache sestavte z faktů, které odpověď mění.
Úspory sledují opakování. Když jsme místo zešikmeného rozdělení udělali všechny záměry stejně pravděpodobné, náklady klesly o 56 % u dvou modelů, které jsme spustili znovu, a se 3 000 zcela odlišnými otázkami klesly o 38 %. Zátěž bez opakovaných nebo podobných otázek neušetří nic.
Nejdřív změřte vlastní opakování
Než cokoli postavíte, zjistěte, kolik vašeho provozu se opakuje. Toto číslo rozhoduje, zda se cache s přesnou shodou vyplatí. S otázkami, které už logujete, to zabere deset minut. Normalizujte každou otázku tak, jak ji bude normalizovat klíč vaší cache, spočítejte odlišné a podívejte se, kolik provozu bylo opakováním.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share je podíl požadavků, na které by odpověděla cache s přesnou shodou, jakmile by každou otázku jednou viděla. Naše testovací sada měla 1 264 odlišných otázek ve 3 000 požadavcích, takže číslo bylo zhruba 58 %. Pokud vám vyjde okolo 5 %, cache s přesnou shodou udělá málo a pomoci může jen sémantická vrstva.
Platí dvě upozornění. Cache začíná prázdná, takže první požadavky vždy dorazí k modelu. V našem běhu bylo z cache obslouženo zhruba 52 % z prvního tisíce požadavků a zhruba 81 % z posledního tisíce. A log provozu z minulého měsíce vypovídá o minulém měsíci. Pokud se chystáte spustit funkci, která změní, na co se lidé ptají, berte číslo jako hrubé vodítko.
Spojení vrstev dohromady
Požadavek by měl procházet vrstvami od nejlevnější a nejbezpečnější po nejdražší a měli byste vidět, co každá ušetřila.
Pořadí vyhledávání
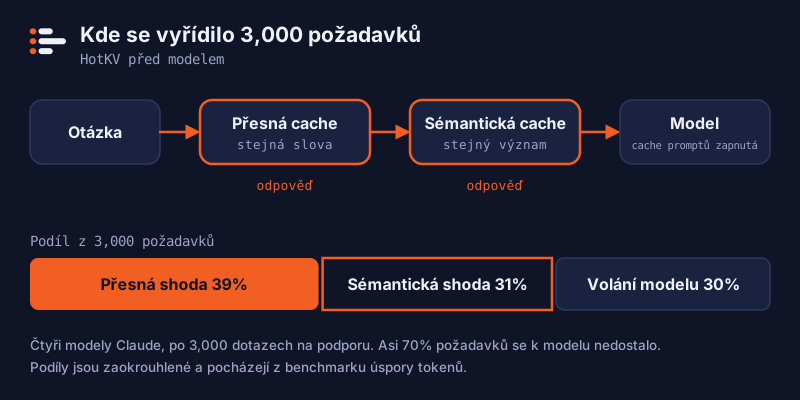
Na pořadí záleží. Nejdřív zkontrolujte nejlevnější a nejbezpečnější vrstvu a model volejte, jen když všechno mine. Tento náčrt předpokládá klienta ve stylu redis-py s decode_responses=True, dva předem vytvořené jmenné prostory a vaše vlastní funkce embed a llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # stejná slova

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # stejný význam

    reply = llm.complete(question)                   # tady se uplatní cachování promptů poskytovatele
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Jmenné prostory vytvořte jednou pomocí PCACHE.CREATE answers_exact a SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, s dimenzí svého modelu pro embeddingy. Sada příkazů pro AI je součástí instancí HotKV Cloud Performance a Scale a stránka o AI uvádí, co které jádro dělá. Ceník ukazuje, který plán co zahrnuje.
Vedení skóre v produkci
Cache, kterou nevidíte, je cache, které nemůžete věřit. HotKV vede počty zásahů a minutí pro každý jmenný prostor. Pokud ke každé položce uložíte spotřebu tokenů původního volání, dokáže také přiřadit tokeny a náklady, které každý další zásah ušetřil. Odpovědi PCACHE.STATS a SCACHE.STATS pak nesou pole jako usage_saved_requests, usage_saved_input_tokens a usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Nahraďte <model> id svého modelu. INPUT počítá necachované tokeny promptu a CACHEREAD tokeny, které poskytovatel obsloužil z vlastní cache, takže se nepřekrývají. Model musí být v tabulce cen HotKV, aby pole nákladů něco znamenalo. LLMSTATS.PRICE LIST ukáže, které modely jsou známé, a LLMSTATS.PRICE SET přidá vaše vlastní. Model bez ceny má své tokeny přesto započítané, ale jeho náklady se zaznamenají jako nula a samostatný čítač ukáže, že požadavky zůstaly neoceněné.
Cache snižují výdaje a rozpočet omezuje to, co zbývá. LLMBUDGET.SET definuje limit tokenů a dolarů v časovém okně. LLMBUDGET.CONSUME se kontroluje před voláním modelu, takže splašený agent se zastaví dřív, než utratí peníze, ne potom. LLMSTATS.RECORD uchovává součty pro každého tenanta, které rozumějí tokenům čtení a zápisu cache poskytovatele. Všechny tři používají jednu tabulku cen, když předáte název modelu, takže úspora, rozpočet a číslo na dashboardu si nemohou odporovat.
Chyby, kvůli kterým cache vrací špatné odpovědi
Většina špatných zásahů cache pochází z klíče, kterému něco chybí. Do klíče s přesnou shodou dejte model, verzi promptu a verzi případných nástrojů či zásad, aby změna promptu nemohla poskytovat odpovědi napsané pro ten starý.
Dejte položkám životnost, která odpovídá tomu, jak rychle se vaše fakta mění. Tenanty držte odděleně samostatnými jmennými prostory, aby se odpověď jednoho zákazníka nikdy nenabídla jinému. Nikdy necachujte odpověď, která obsahuje osobní údaje, pokud klíč nezahrnuje, čí údaje to jsou.
Nakonec měřte na vlastním provozu. Naše čísla pocházejí z jedné veřejné datové sady krátkých bankovních otázek, fiktivní politiky a jednoho běhu pro každou podmínku a nejsou příslibem pro vaši zátěž.
Často kladené otázky
Co je cachování promptů?
Cachování promptů je funkce poskytovatele modelu, která na krátkou dobu uloží zpracovaný začátek promptu. Pozdější požadavek, který začíná přesně stejným textem, se u této části účtuje nižší sazbou. Model se stále spouští a vytváří novou odpověď, takže za výstupní tokeny stále platíte.
Je cachování promptů totéž co sémantické cachování?
Ne. Cachování promptů znovu využívá opakovaný prefix promptu a model stále volá. Sémantické cachování vrací uloženou odpověď na otázku s podobným významem a volání modelu přeskakuje. Řeší různé náklady a lze je používat společně.
Snižuje cachování promptů náklady na výstupní tokeny?
Ne. Snižuje pouze cenu čtení cachovaného prefixu. V našem benchmarku byl výstup 6 % až 9 % tokenů, ale 73 % až 92 % základních nákladů s už zapnutým cachováním promptů, a proto cachování celých odpovědí ušetřilo mnohem víc.
Jak dlouho cache promptů u Anthropicu vydrží?
Výchozí hodnota je pět minut, obnovovaných při každém použití položky. K dispozici je jednohodinová možnost za vyšší cenu zápisu. Ověřte si aktuální dokumentaci, protože limity a ceny se mění.
Mohu cachování promptů a sémantické cachování používat společně?
Ano, a náš benchmark to přesně dělal. Cachování promptů poskytovatele zůstalo zapnuté v obou bězích a vrstvy s přesnou i sémantickou shodou stály před modelem. Zásahy cache volání přeskočí a minutí stále těží ze zlevněného prefixu.
Jaký práh podobnosti by sémantická cache měla používat?
Univerzální hodnota neexistuje. My jsme zvolili 0,81 na samostatné trénovací části a u Sonnet 5.5 nevykazovaly odpovědi z cache od 0,88 výše oproti čerstvým žádný deficit kvality, s tenkými důkazy. Začněte vysoko, posuzujte odpovědi z cache proti čerstvým na vlastních otázkách a práh snižujte, jen pokud kvalita drží.
Pokračujte v diskusi
Komentáře
Máte otázky k metodě? Na vašem hardwaru vám vyšel jiný výsledek? Podělte se o to, co jste zjistili. Komentáře se před zveřejněním kontrolují.