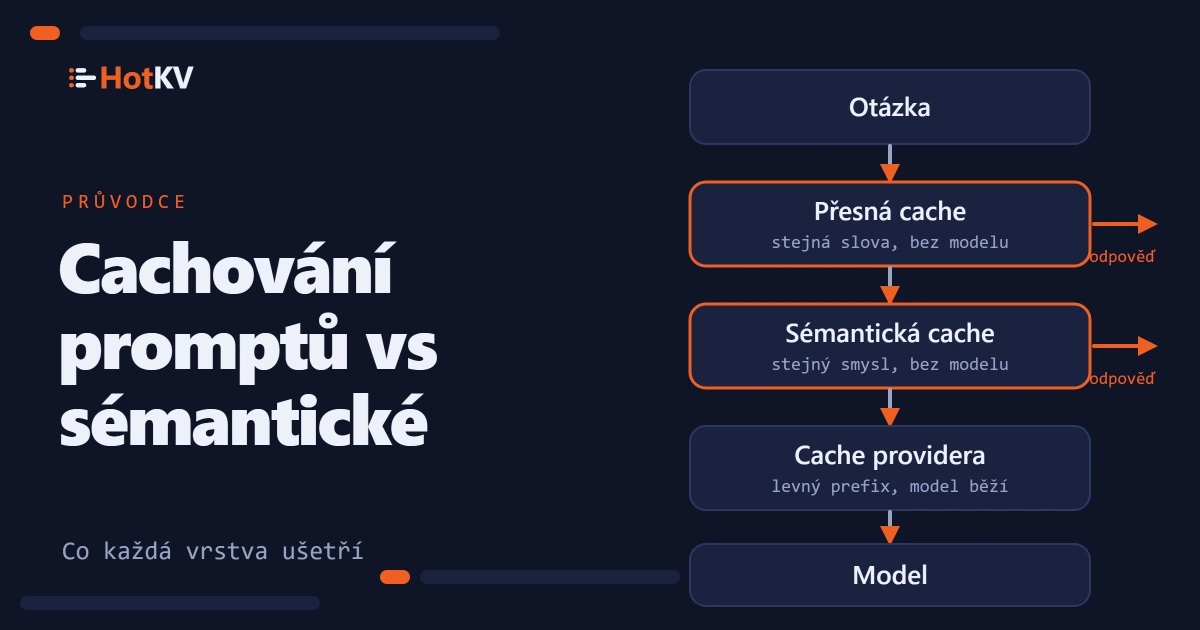
Cachování promptů vs sémantické cachování: co každé ušetří
Cachování promptů zlevní opakovaný prefix. Sémantické cachování odstraní volání modelu. Jak každé funguje, co jsme změřili a které kdy použít.
Štítek
Cachování promptů u poskytovatele a cachování odpovědí pro aplikace s LLM: co každé ušetří na tokenech a nákladech a kde přestává pomáhat.
2 články v Cachování promptů
Cachování promptů zlevní opakovaný prefix. Sémantické cachování odstraní volání modelu. Jak každé funguje, co jsme změřili a které kdy použít.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Následujte svou zvědavost