
HotKV הוא מאגר נתונים רב-תהליכוני התואם ל-Redis, שנכתב מאפס ב-C++ מודרני ונבנה כדי להוציא את המהירות המרבית משרתים מודרניים עם הרבה ליבות, בעלות הנמוכה ביותר האפשרית. אני Norbert E. Boros, מייסד ומנכ״ל HotKV Ltd. הפוסט הזה מסביר למה בניתי אותו, מה הוא עושה היום ואיך הוא נמדד.
בקצרה. HotKV מריץ פקודות על הרבה תהליכונים בבת אחת בתוך תהליך יחיד, ומדבר RESP2 ו-RESP3, פרוטוקול Redis. במדד הביצועים שלנו מאוקטובר 2026 למופע יחיד על 160 vCPU, הייתה לו התפוקה הגבוהה ביותר ב-11 מתוך 12 הפקודות שמדדנו, ו-Dragonfly היה שווה לו בפקודה השתים-עשרה. ההגדרות והמגבלות מתוארות בהמשך.
למה בניתי את HotKV
אכפת לי ממהירות בכל מה שאני בונה. אתר, כלי או שרת צריכים להגיב מיד, וכשהם לא מגיבים אני רוצה לדעת למה. ההרגל הזה עיצב את העבודה שלי מאז שאני כותב תוכנה.
C ו-C++ הן שפות העבודה העיקריות שלי כבר שנים רבות. כמעט עשר שנים עבדתי על תוכנת נגד רמאות למשחקים, שרצה על המחשבים של אלפי שחקנים. היא הייתה צריכה לסרוק את הזיכרון בחיפוש אחר רמאויות תוך שימוש מזערי במעבד ובזיכרון, כי כל מחזור שהיא צרכה נלקח מהמשחק. העבודה הזו לימדה אותי למדוד הכול, לתכנן סביב החומרה ולראות בצריכת משאבים נמוכה יכולת בפני עצמה.
במקביל השתמשתי ב-Redis וב-Valkey בהרבה פרויקטים שנזקקו למטמון מהיר: מאגרי סשנים, רשימות של כתובות IP שחסומות בחומת אש ומטמון לפני מאות מיליוני רשומות ב-SQL Server. אלה כלים מצוינים. הם גם גרמו לי לתהות מה מאגר מפתח-ערך יכול לעשות אילו תוכנן מההתחלה לשרתים מרובי ליבות שאנחנו מפעילים היום.
HotKV הוא התשובה שהגעתי אליה. כתבתי אותו מאפס ב-C++ מודרני כדי להוציא מהחומרה כמה שיותר מהירות, בעלות הנמוכה ביותר האפשרית. מדד הביצועים להלן מראה איפה הוא עומד היום, ואני מצפה שיש עוד מה להרוויח.
המחיר של AI
הייתה סיבה שנייה. הפעלת יישומי AI נעשתה יקרה, עבורי ולפי מה שמפתחים שיתפו ברשת, גם עבור רבים אחרים. חלק גדול מהעלות הזו נובע לא פעם מכך ששולחים למודל שאלות שכבר ענה עליהן. מאגר מהיר שמזהה שאלה חוזרת או דומה ועונה עליה מהמטמון הוא אחת הדרכים הישירות ביותר להקטין את החשבון הזה, ולכן מטמון לעומסי עבודה של AI הוא חלק מרכזי ב-HotKV.
למה HotKV נועד
HotKV Ltd קיימת כדי להפוך תוכנה מהסוג הזה לביצועית יותר ולזולה יותר. לשרתים מודרניים יש הרבה ליבות, ומאגר נתונים צריך לנצל אותן, כך שמקבלים כמה שיותר מהירות בעלות הנמוכה ביותר האפשרית.
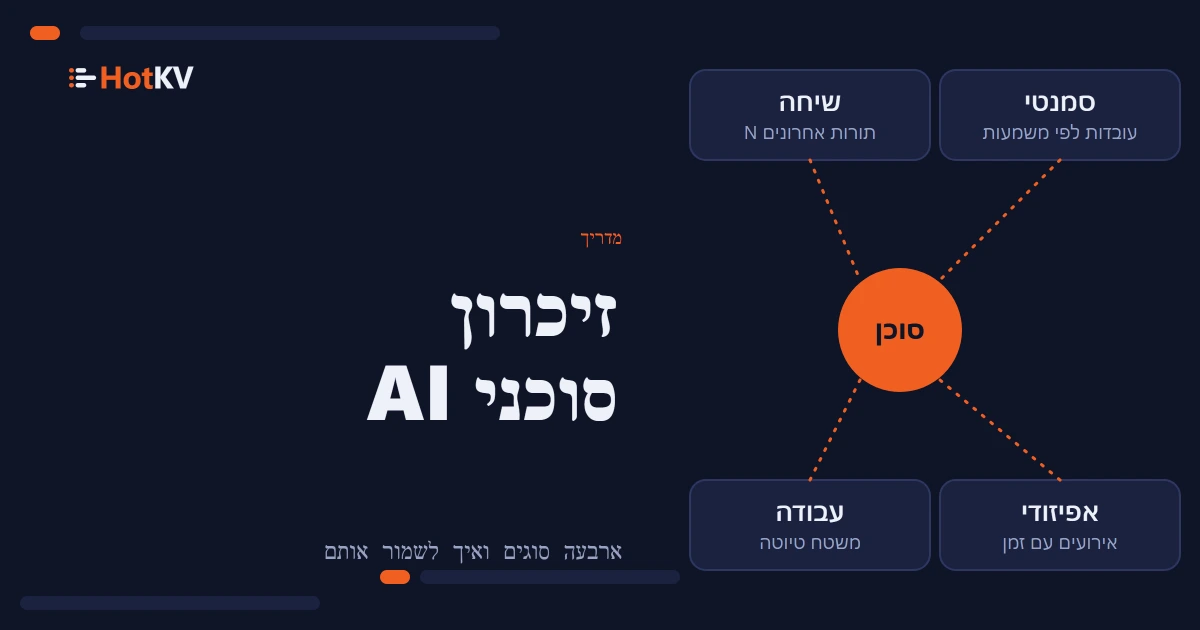
הרעיון השני הוא לשמור יותר מהסטאק במקום אחד. צוותים שבונים על LLM מוצאים את עצמם לא פעם מפעילים מטמון, מסד נתונים וקטורי ומקום לשמירת זיכרון של סוכנים, עם ערימה של קוד הדבקה ביניהם. אני רוצה שמטמון ועבודת ה-AI שסביבו יחיו במנוע אחד, לצד הנתונים שלכם: מטמון מדויק וסמנטי לקריאות למודל, חיפוש וקטורי, זיכרון לסוכנים ותקציבי טוקנים. פחות מערכות להפעיל אמורות להביא פחות חלקים נעים וחשבון נמוך יותר. עמוד ה-AI מפרט מה זמין היום, ומדד חיסכון הטוקנים מראה כמה חסכה שמירת קריאות למודל במטמון בבדיקה שלנו.
HotKV שומר על פרוטוקול Redis ועל ספריות לקוח מוכרות.
הבעיה
תהליכון ביצוע פקודות יחיד יכול להפוך לצוואר בקבוק במכונה עם הרבה ליבות. מאגר נתונים שבנוי סביב תהליכון ביצוע אחד מגיע בדרך כלל לשאר המכונה בהרצת כמה מופעים או אשכול, וזה מביא איתו בחירות פריסה ועבודה תפעולית. רציתי ש-HotKV יתחיל מהקצה השני, עם פקודות שרצות במקביל בתוך מופע אחד, כך שתהליך יחיד יכול לנצל את המכונה כולה.
במה HotKV שונה
HotKV™ כתוב ב-C++20 ותוכנן להריץ פקודות על הרבה ליבות בבת אחת, כך שמופע יחיד יכול לנצל מכונה שלמה. גם Dragonfly, שאנו מודדים להלן, נוקט גישה רב-תהליכונית.
- הרבה ליבות, מופע אחד. פקודות רצות במקביל על ליבות המכונה, כך שמופע אחד יכול לנצל שרת גדול במקום כמה קטנים יותר.
- לקוחות ופרוטוקול מוכרים. HotKV תומך ב-RESP2 וב-RESP3, כך שספריות לקוח מוכרות יכולות להתחבר אליו. טרנזקציות (
MULTI/EXEC) וסקריפטים ב-Lua נתמכים. בתיעוד הפקודות מופיעות הפקודות הנתמכות וכל הבדל.
איך הוא נבנה ונבדק
אני בונה את HotKV בעצמי ומשתמש בעזרת AI במקום שזה עוזר. חשוב יותר מאיך נכתבה שורה הוא אם היא עומדת במבחן, ולכן המנוע נבדק בקפדנות. יש בו יותר מ-2,000 בדיקות אוטומטיות והוא נבנה תחת AddressSanitizer, ThreadSanitizer ו-UndefinedBehaviorSanitizer. יש בו גם יעדי fuzz למפענח הפרוטוקול, לשיגור הפקודות, לטעינת RDB ו-AOF, לזרם השכפול ולאפיק האשכול.
הגדרות מדד הביצועים, המגבלות שלו והתוצאות המלאות נמצאים בעמוד הביצועים, כך שאפשר לשפוט את המספרים בעצמכם.
תמונת מצב של מדד הביצועים
עודכן באוקטובר 2026: המספרים שפורסמו לראשונה בפוסט הזה הגיעו מהרצות מדד שמאוחר יותר התגלה שהן פגומות (בין השאר, כל מחולל העומס השתמש באותו seed אקראי), ולכן החלפנו אותם בתוצאות מהמדד שבנינו מחדש.
אוקטובר 2026: HotKV, Redis, Valkey ו-Dragonfly
HotKV Ltd ערכה את מדד הביצועים הזה. מדדנו את HotKV, שנבנה מקוד המקור, מול Redis 8.10.2, Valkey 9.1.2 ו-Dragonfly 2.0.2. כל שרת רץ לבדו, כמופע יחיד על כל 160 ה-vCPU של Azure D160alds_v7 (AMD EPYC 9V45), כשההתמדה כבויה. שלוש מכונות נפרדות של 64 vCPU יצרו את העומס באמצעות memtier_benchmark: ערכים בני 256 בייטים, עומק pipeline של 30 ו-5,000,000 מפתחות שמולאו מראש. כל מספר הוא החציון של שלוש הרצות של 10 שניות.
ל-HotKV הייתה התפוקה הגבוהה ביותר ב-11 מתוך 12 הפקודות. מול Redis או Valkey הוא נמדד בין 8.6 לפחות מ-69.7 מונים מהתפוקה שלהם, בהתאם לפקודה ולשרת. מול Dragonfly הוא נמדד בין 1.97 ל-4.41 מונים ב-11 הפקודות האלה, וכמה מהן הן רף תחתון. ב-PING Dragonfly נמדד 0.6 אחוז קדימה. אנו סופרים זאת כתיקו, כי מחוללי העומס היו קרובים למגבלה של עצמם. המספר הגבוה ביותר בפקודת נתונים היה 90.8 מיליון פעולות INCR בשנייה. INCR ו-PING מזיזות מעט נתונים ומוגבלות על ידי מחוללי העומס, ולכן המספר של HotKV עצמו עבורן עשוי להיות גבוה יותר.
| פקודה | HotKV (מיליון ops/s) | HotKV מול Redis | HotKV מול Valkey | HotKV מול Dragonfly |
|---|---|---|---|---|
| SET | 50.5 | ≥ 14.80x | ≥ 17.51x | ≥ 3.36x |
| GET | 36.6 | ≥ 32.34x | ≥ 22.46x | ≥ 2.73x |
| MGET | 4.6 | 16.61x | 8.60x | 1.97x |
| SETNX | 55.3 | ≥ 39.58x | ≥ 29.73x | ≥ 3.83x |
| APPEND | 25.1 | 16.37x | 19.41x | 2.83x |
| INCR | 90.8 | 43.15x | 47.33x | 4.41x |
| LPUSH | 31.6 | 25.34x | 37.55x | 2.99x |
| RPUSH | 43.8 | ≥ 69.67x | ≥ 49.83x | ≥ 3.97x |
| SADD | 50.6 | ≥ 24.65x | ≥ 56.60x | ≥ 4.20x |
| HSET | 29.0 | ≥ 54.05x | ≥ 37.09x | ≥ 2.96x |
| MSET | 11.3 | ≥ 29.78x | ≥ 24.26x | ≥ 3.83x |
| PING | 125.2 | ≥ 38.70x | ≥ 35.98x | 0.99x (תיקו) |
איך לקרוא את הטבלה
MGET קורא שמונה מפתחות ו-MSET כותב ארבעה זוגות מפתח-ערך בכל פקודה, והתפוקה סופרת פקודות. הדוח מסמן שבעה מספרים של HotKV (GET ושש פקודות כתיבה) כי הם הגיעו לסף של 85% ניצול רשת שלו, ואת PING כי מחוללי העומס היו מעל 85% CPU. יחסים שנשענים עליהם הם רף תחתון, ומסומנים ב-≥. ב-GET וב-PING אלה המגבלות האמיתיות. בשש פקודות הכתיבה, נתון ניצול הרשת בדוח מחבר תעבורה נכנסת ויוצאת ומשווה אותו לתקרת התעבורה היוצאת, ולכן הוא מגזים בהערכת הקרבה שלהן למגבלה. הכבדה ביותר, SETNX, ניצלה לכל היותר כ-80% מהתקרה הנכנסת שנמדדה. אנו משאירים את ה-≥ עליהן כמוסכמה שמרנית. הטבלאות המלאות, הסימונים והערות השיטה נמצאים בעמוד הביצועים.
היקף מדד הביצועים
- בנייה וכיוונון. HotKV קומפל עם
-march=nativeעבור המעבד שנבדק, בעוד השרתים האחרים היו גרסאות ה-release הרגילות שלהם. - הגדרות תהליכונים. כל שרת קיבל את כל ליבות המכונה: ל-HotKV
--threads 160, ל-Dragonfly 160 תהליכוני proactor, ל-Valkeyio-threads 160ול-Redisio-threads 128, המקסימום שלו. Redis ו-Valkey מריצים פקודות בתהליכון אחד ועשויים להגיע לתפוקה גבוהה יותר עם פחות תהליכוני קלט/פלט, ולכן המספרים שלהם עשויים להיות מתחת למיטב שלהם. לא הרצנו אשכולות או כמה מופעים שלהם. - היקף. שתים-עשרה פקודות, גודל ערך אחד, עומק pipeline אחד, בלי TLS ובלי התמדה.
LPOPו-RPOPלא נמדדו, כי בקצבים האלה קריאה הרסנית מרוקנת כל רשימה שנכנסת בזיכרון תוך 10 שניות. הדוח רושם השהיה וצריכת זיכרון, אך איננו משווים אותן כאן. השרתים ביצעו כמויות עבודה שונות מאוד בכל הרצה של 10 שניות, ולכן מספרי הזיכרון אינם ברי השוואה. עומסי עבודה מעורבים לא נמדדו. - שונות. Redis השתנה מאוד בין שלוש ההרצות שלו בכמה פקודות, עד פי 7.2 בין ההרצה המהירה ביותר לאיטית ביותר שלו ב-
HSET, והחציון מסתיר זאת. בהשוואה להרצה המהירה ביותר של כל מתחרה במקום לחציון שלו, HotKV עדיין הוביל בכל 11 הפקודות.
Redis, Valkey ו-Dragonfly הם סימנים מסחריים של בעליהם. הם מוזכרים רק כדי לזהות את התוכנה שמדדנו, ואין בכך משום חסות, תמיכה או זיקה.
מה כבר זמין היום
משפחות פקודות הליבה כוללות מחרוזות, רשימות, קבוצות, hashes, sorted sets, זרמים, אינדקסים גיאו-מרחביים, bitmaps, HyperLogLog, pub/sub וסקריפטים ב-Lua. מודולי ה-AI והיכולות הארגוניות רצים בתוכניות בתשלום. בתמחור מפורט מה כוללת כל תוכנית. את כיסוי הפקודות העדכני אפשר למצוא בתיעוד. מעבר לערכת הפקודות של Redis:
- תיוג מפתחות: מתייגים מפתחות בתגיות חופשיות ושואלים לפי תגית (
TAG.SET,TAG.MEMBERSוחמש פקודות נוספות). - TTL בננו-שניות:
NEXPIRE,NTTLו-NEXPIREATקובעים וקוראים תפוגה בננו-שניות, כך שמועדים יכולים להיות עדינים יותר מאלפית שנייה. מפתחות שפג תוקפם נאספים בסריקת רקע וכשניגשים אליהם. - דחיסת ערכים אופציונלית: לערכים שמעל סף גודל (512 בייטים כברירת מחדל), כבויה אלא אם מפעילים אותה.
- צילומי מצב בלי fork:
BGSAVEכותב בתהליכון רקע במקום בתהליך שנוצר ב-fork. צילום מצב אינו העתק בנקודת זמן אחת. כל מפתח נשמר כפי שהיה כשצילום המצב הגיע אליו. שכתוב קובץ ההוספה בלבד כן משתמש ב-fork. - מדדי Prometheus: נקודת קצה HTTP מובנית, כבויה כברירת מחדל ומופעלת עם
metrics-port, כך שאין צורך ב-exporter חיצוני.
ל-HotKV יש גם חיפוש וקטורי מובנה עם אינדקסי HNSW (VSIM.CREATEINDEX, VSIM.SET, VSIM.SEARCH). מדדנו אותו מול Redis 8 בחיפוש וקטורי: HotKV מול סטי הווקטורים של Redis 8, מ-1 עד 100 לקוחות.
מתחילים ב-HotKV Cloud, או מדברים עם המכירות על הרצת HotKV על השרתים שלכם.
ממשיכים את השיחה
תגובות
שאלות על השיטה? תוצאה אחרת על החומרה שלכם? שתפו את מה שמצאתם. התגובות נבדקות לפני שהן מופיעות.