

La memoria degli agenti IA è ciò che permette a un agente di portare qualcosa da un passaggio, o da una sessione, alla successiva. Un modello linguistico da solo non ricorda nulla tra una chiamata e l'altra. Tutto ciò che sembra ricordare è stato rimesso nel prompt dal tuo codice. Il modo in cui archivi e recuperi quel materiale decide che cosa l'agente può richiamare, con quale rapidità e a quale costo per turno.
In breve. Gli agenti hanno bisogno di quattro tipi di memoria: una breve finestra di conversazione, fatti a lungo termine trovati per significato, un blocco appunti per il compito in corso e un registro di ciò che è successo. Ciascuno ha una forma, una durata e una ricerca diverse, quindi una sola tabella di memoria non si adatta bene a nessuno. HotKV archivia tutti e quattro in un unico motore in memoria con i comandi
AMEM.*. Abbiamo misurato con benchmark il caching e la ricerca vettoriale di HotKV, non la memoria degli agenti, quindi questo articolo spiega la progettazione e non dichiara alcun aumento di velocità.
Perché una finestra di contesto non è memoria
Una finestra di contesto è il testo che invii con ogni richiesta. Ha un limite di dimensione, paghi token di input per tutto ciò che contiene a ogni turno e sparisce quando la sessione finisce. Inoltre non si può cercare al suo interno. Se un agente ha bisogno di un fatto di tre settimane fa, incollare l'intera cronologia non è una risposta.
La memoria è lo strato che decide che cosa entra nella finestra successiva. Conserva i turni recenti e trova i pochi fatti più vecchi che contano. Contiene lo stato del compito corrente e registra ciò che l'agente ha fatto. I ricercatori descrivono gli agenti in termini simili. Il framework CoALA di Sumers, Yao, Narasimhan e Griffiths distingue la memoria di lavoro dalla memoria a lungo termine episodica, semantica e procedurale.
I quattro tipi di memoria degli agenti IA
I quattro archivi di HotKV coprono in gran parte lo stesso terreno, adattato a ciò che un'applicazione deve costruire. La memoria procedurale, il know-how contenuto nel codice e nei prompt dell'agente, vive normalmente nel tuo repository o in un registro dei prompt e non è un archivio a sé.
Memoria di conversazione
È la trascrizione a breve termine di una sessione. I messaggi hanno un ruolo (system, user, assistant o tool). Stanno in una finestra scorrevole con un limite, quindi i turni più vecchi cadono una volta raggiunto il limite. Risponde a una sola domanda. Che cosa è stato detto di recente? In HotKV sono AMEM.CONV.CREATE, AMEM.CONV.APPEND e AMEM.CONV.WINDOW.
Memoria semantica
La memoria semantica è conoscenza a lungo termine archiviata come fatti con un vettore di embedding. L'agente li richiama per significato e non per chiave. È sostenuta da un indice vettoriale HNSW, dello stesso tipo che alimenta la ricerca vettoriale. AMEM.SEM.STORE salva un fatto e AMEM.SEM.RECALL restituisce le corrispondenze migliori con un punteggio di similarità. Qui vanno documenti, preferenze degli utenti e correzioni apprese.
Memoria di lavoro
La memoria di lavoro è il blocco appunti per un compito in corso, un insieme piatto di chiavi e valori legato a una sessione. Contiene il passaggio corrente, il ticket in gestione o un risultato parziale. Dovrebbe sparire quando il compito finisce. AMEM.WORK.SET accetta un time to live proprio per questo motivo.
Memoria episodica
La memoria episodica è un registro di eventi con marca temporale, in sola aggiunta, come un'azione compiuta, un'osservazione fatta o una decisione presa. Permette a un agente, o a una persona che lo esamina, di chiedere che cosa è successo e quando. AMEM.EPIS.LOG scrive un evento e AMEM.EPIS.QUERY li rilegge per tipo e intervallo di tempo.
La memoria degli agenti IA in pratica
In pratica contano due cose. Come scrivi nella memoria e che cosa rileggi a ogni turno.
Archiviare la memoria con i comandi
Ecco un agente di assistenza che gestisce una conversazione. Il testo della policy, fittizio, e i vettori di tre numeri servono solo come illustrazione. Un vero modello di embedding produce vettori di 768 o 1.536 numeri, e tu crei il namespace con quella dimensione.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
A ogni turno l'agente legge la finestra recente e richiama i pochi fatti che corrispondono alla domanda. Controlla il suo appunto di lavoro e costruisce il prompt con questi pezzi. Dopo aver agito, registra l'evento. Niente in questo ciclo richiede l'intera cronologia.
Leggere la memoria a ogni turno
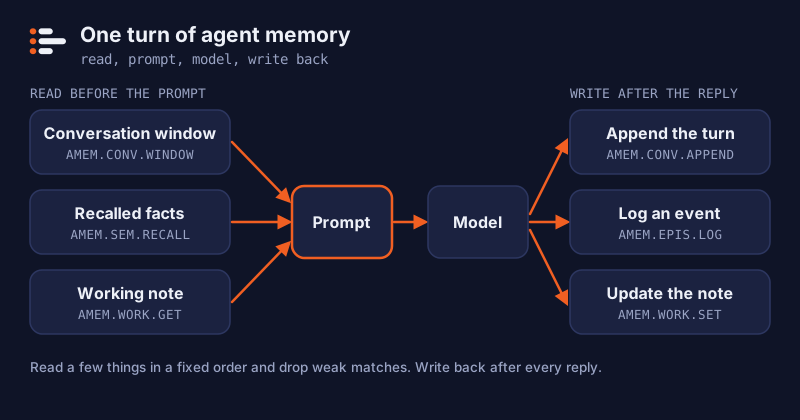
Archiviare la memoria è la metà facile. L'abilità sta nel decidere che cosa rileggere, perché tutto ciò che leggi finisce nel prompt e costa token di input. Un ciclo ragionevole legge poche cose in un ordine fisso. Prima i turni recenti, poi i pochi fatti che corrispondono alla domanda, poi lo stato del compito. Ecco il ciclo con il client Python ufficiale, con la tua funzione di embedding e il tuo template di prompt.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # da regolare sui tuoi dati

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # crea una sola volta, prima del primo append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # il tuo template di prompt

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
La soglia di similarità sta a te regolarla. Un valore adatto a un modello di embedding e a un insieme di fatti sarà sbagliato per un altro, quindi verifica il recall su domande di cui conosci le risposte. Scartare le corrispondenze deboli conta più di quanto sembri, perché un fatto scadente nel prompt è peggio di nessun fatto.
Le parti stabili di questo prompt, come le istruzioni di sistema, sono anche quelle che il prompt caching lato provider rende più economiche. Metti la memoria che leggi alla fine, dopo il testo stabile, così cambiarla non invalida quella cache.
Riassunti al posto di finestre sempre più lunghe
Una finestra scarta del tutto i turni vecchi. Va bene per le chiacchiere e male per un compito lungo, in cui il turno 3 può contare ancora al turno 300. Il rimedio abituale è un riassunto progressivo. Dopo ogni tratto di conversazione l'agente, o un modello più economico, annota ciò che ha appreso, e il riassunto sostituisce i turni vecchi nel prompt.
HotKV conserva un riassunto per agente con AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND e AMEM.SUMMARY.GET. SET sostituisce il testo e APPEND aggiunge una riga. Ogni aggiornamento incrementa un numero di versione, così un altro componente può accorgersi a basso costo che il riassunto è cambiato e quando.
Un riassunto perde informazioni, e riassumere un riassunto ne perde sempre di più. Tieni valori esatti come identificatori, importi e date fuori dalla prosa, nella memoria di lavoro o nei fatti semantici, dove sopravvivono. Usa il riassunto per la forma del lavoro, come preferenze, decisioni prese e ciò che resta da fare.
Regole di progettazione e conservazione
La memoria cresce senza limite se non la fermi, quindi fissa i limiti prima della prima scrittura.
Regole che mantengono utile la memoria
- Limita tutto. Imposta una
WINDOWsulle conversazioni e unTTLsu sessioni e valori di lavoro. Per conversazioni, valori di lavoro e fatti, HotKV registra l'ora di scadenza per l'append-only file e per le repliche, quindi una voce scaduta non ricompare quando il file viene riletto dopo un riavvio. - Archivia fatti, non trascrizioni. Riassumi prima di scrivere nella memoria semantica. Un fatto è più facile da richiamare di una pagina di dialogo.
- Tieni separati gli agenti. Usa un identificatore o un namespace distinto per ogni agente e per ogni tenant, così la memoria di un cliente non viene mai richiamata per un altro.
- Richiama pochi risultati, non molti. Prendi le prime tre o cinque corrispondenze e scarta quelle deboli in base al punteggio di similarità prima che entrino nel prompt.
- Tieni fuori i segreti. La memoria viene riletta nei prompt, quindi non archiviare mai password, chiavi o dati che non mostreresti al modello.
Per quanto tempo conservare ciascun tipo
Queste durate sono suggerimenti nostri, non valori predefiniti. Scegli le tue in base alla rapidità con cui cambiano i fatti sottostanti e a ciò che ti è consentito conservare.
| Tipo di memoria | Durata suggerita | Controlli in HotKV |
|---|---|---|
| Conversazione | La sessione, o un periodo fisso come un giorno | WINDOW e TTL su AMEM.CONV.CREATE |
| Di lavoro | Il compito, poi svuotata | TTL su AMEM.WORK.SET e AMEM.WORK.CLEAR |
| Semantica | Finché il fatto smette di essere vero | TTL su AMEM.SEM.STORE e AMEM.SEM.FORGET |
| Episodica | Per tutto il tempo che richiedono le tue esigenze di audit o assistenza | AMEM.EPIS.QUERY per intervallo di tempo e AMEM.EPIS.CLEAR (gli eventi non hanno un time to live) |
La conservazione è anche una questione di privacy. Se la memoria contiene qualcosa su una persona, la durata che scegli fa parte di ciò che le prometti, quindi mettila per iscritto.
Come va storta la memoria degli agenti
La maggior parte dei bug della memoria è lenta. L'agente funziona bene per una settimana e poi comincia a peggiorare. Sono i guasti da prevedere in fase di progettazione.
Guasti comuni
- Fatti obsoleti. Un fatto vero a marzo viene richiamato a ottobre. Dai ai fatti un time to live, oppure archiviali con una chiave per entità, così il nuovo valore sovrascrive il vecchio.
- Contraddizioni. Due fatti archiviati sono in disaccordo e l'agente ne sceglie uno a caso. Preferisci un fatto per chiave ad aggiungere nuove note accanto alle vecchie.
- Richiamo eccessivo. Troppe corrispondenze riempiono il prompt di testo vagamente correlato. Richiama poco e scarta le corrispondenze deboli.
- Fughe tra utenti. La memoria di un cliente viene richiamata per un altro. Usa identificatori o namespace separati per ogni tenant, controllati nel codice prima di ogni lettura.
- Crescita illimitata. Niente scade mai, quindi le ricerche rallentano e i costi salgono. Ogni tipo ha bisogno di una durata. Dove HotKV non ha un time to live, come per il registro episodico, pianifica tu uno svuotamento o un'esportazione.
- Deriva del riassunto. Il riassunto di un riassunto smette lentamente di corrispondere a ciò che è accaduto. Tieni il registro degli eventi come fonte di verità e rigenera i riassunti da esso.
Tratta il testo archiviato come non attendibile
L'ultimo punto merita più attenzione. Qualsiasi cosa un agente scriva nella memoria può essere riletta in un prompt in seguito. Questo include testo proveniente da una pagina web, da un'email o da un utente. È la forma indiretta di prompt injection che OWASP elenca come LLM01. Salva la fonte con ogni fatto. Fidati meno della memoria scritta a partire da contenuti esterni e non lasciare mai che una nota richiamata prevalga sul tuo prompt di sistema.
Cosa abbiamo e non abbiamo misurato
I benchmark pubblicati di HotKV riguardano il throughput dei comandi, la ricerca vettoriale e il risparmio di token del caching delle risposte. La memoria degli agenti non ha ancora un benchmark proprio. Non facciamo alcuna affermazione sulla sua latenza né su quanto migliori la qualità degli agenti. Ciò che possiamo dire riguarda l'architettura. I quattro archivi girano nello stesso processo della cache e dell'indice vettoriale. Una ricerca in memoria è una sola chiamata a un sistema che già gestisci.
Il benchmark sul risparmio di token e il confronto tra prompt caching e caching semantico mostrano il lato misurato. Il caso d'uso della memoria degli agenti mostra i comandi in uno scenario completo.
Usare la memoria degli agenti da Claude Code o Cursor
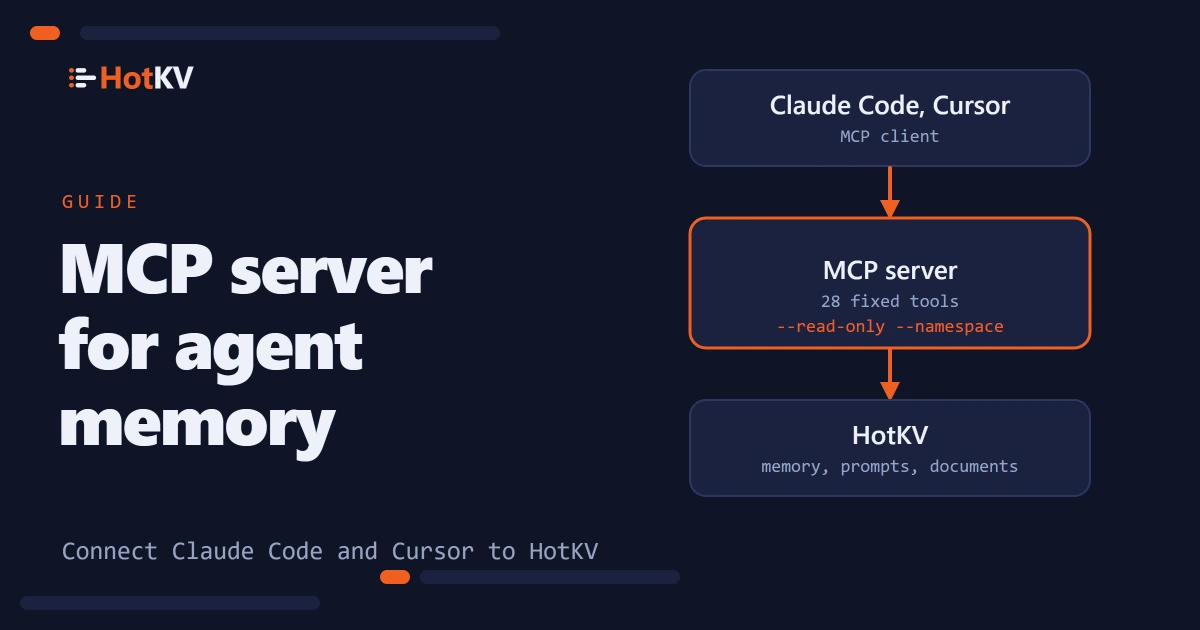
Un assistente che supporta il Model Context Protocol può usare una parte di questa memoria senza codice personalizzato. Il server open source hotkv-mcp espone come strumenti la memoria di conversazione, gli appunti di lavoro, un registro degli eventi e un riassunto progressivo. Ha una modalità di sola lettura e un namespace che confina l'agente. Non espone la memoria semantica e i suoi strumenti non possono impostare una finestra o un time to live, quindi per questi usa la libreria client. Il prossimo articolo, un server MCP per la memoria degli agenti, mostra come collegarlo e che cosa coprono le sue protezioni.
Domande frequenti
Che cos'è la memoria degli agenti IA?
La memoria degli agenti IA è lo strato di archiviazione e recupero che permette a un agente di conservare informazioni tra passaggi e sessioni. Di solito combina una finestra di conversazione recente, fatti a lungo termine trovati per significato, un blocco appunti per il compito corrente e un registro degli eventi.
Qual è la differenza tra memoria dell'agente a breve e a lungo termine?
La memoria a breve termine contiene ciò che accade adesso, come i turni recenti e lo stato del compito, ed è limitata e temporanea. La memoria a lungo termine contiene conoscenza che dovrebbe sopravvivere a una sessione, come fatti, preferenze ed eventi passati, e viene cercata quando serve.
Che cos'è un riassunto progressivo nella memoria degli agenti?
Un riassunto progressivo è una breve descrizione continua di ciò che un agente ha appreso o deciso finora, aggiornata mentre il lavoro prosegue. Sostituisce i turni vecchi nel prompt, così il prompt non continua a crescere. HotKV ne conserva uno per agente e incrementa un numero di versione a ogni aggiornamento.
Mi serve un database vettoriale per la memoria degli agenti?
Solo per la memoria semantica, in cui i fatti si trovano per significato. Le finestre di conversazione, lo stato di lavoro e i registri degli eventi non richiedono vettori. HotKV tiene tutti e quattro in un unico motore, quindi l'indice vettoriale e gli altri archivi non sono sistemi separati.
Per quanto tempo va conservata la memoria degli agenti?
Dipende dal tipo. La memoria di lavoro dovrebbe scadere quando il compito finisce, le conversazioni dopo la sessione o un periodo stabilito e i registri episodici per tutto il tempo che richiedono le tue esigenze di audit. I fatti nella memoria semantica vanno rivisti e rimossi quando smettono di essere veri.
La memoria degli agenti può essere attaccata?
Sì. Il testo scritto nella memoria viene poi riletto nei prompt, quindi una nota avvelenata può orientare l'agente. Registra da dove viene ogni fatto, fidati meno dei contenuti esterni e tieni la memoria richiamata al di sotto del tuo prompt di sistema in termini di autorità.
HotKV archivia la memoria degli agenti nella RAM?
HotKV è un motore in memoria, quindi le letture vengono servite dalla memoria. Le scritture nei quattro archivi vengono registrate per l'append-only file e per le repliche, con i tempi di scadenza trasportati, secondo la documentazione del prodotto.

Continua la conversazione
Commenti
Domande sul metodo? Un risultato diverso sul tuo hardware? Condividi ciò che hai trovato. I commenti vengono revisionati prima di comparire.