

Con il nome di caching per i modelli linguistici si vendono due cose diverse, e i team ne comprano spesso una aspettandosi l'altra. Il prompt caching è una funzione del provider che rende più economica la lettura di un prefisso di prompt ripetuto. Il caching semantico è uno strato che gestisci tu e che risponde a una domanda dalla memoria, così il modello non viene mai chiamato. Risolvono metà diverse del conto e funzionano meglio insieme.
In breve. Il prompt caching sconta l'inizio ripetuto di un prompt, come un lungo prompt di sistema, ma il modello viene comunque eseguito e paghi comunque ogni token di output. Il caching esatto e quello semantico eliminano del tutto la chiamata quando a una domanda è già stata data risposta. Nel nostro benchmark da 3.000 richieste, con il prompt caching del provider già attivo, aggiungere HotKV davanti ha ridotto di circa il 70% le chiamate al modello, i token e il costo, perché i token di output pesavano ancora dal 73% al 92% del costo di baseline.
Come funziona il prompt caching
Il prompt caching vive presso il provider del modello. Contrassegni l'inizio stabile di una richiesta, di solito gli strumenti e il prompt di sistema, e il provider ne conserva per breve tempo la forma elaborata. La richiesta successiva che inizia con lo stesso identico testo viene fatturata a una tariffa ridotta per quella parte. Qui descriviamo la versione di Anthropic perché è quella che abbiamo misurato. I dettagli che seguono vengono dalla sua documentazione sul prompt caching, consultata il 18 ottobre 2026.
Cosa viene messo in cache
Un hit richiede una corrispondenza esatta. Ogni blocco fino a quello che hai contrassegnato con cache_control, compreso, deve essere identico, nell'ordine strumenti, prompt di sistema e poi messaggi. Cambia un solo carattere all'inizio del prompt e tutto ciò che segue è un miss. La domanda vera e propria viene per ultima, quindi non fa mai parte del prefisso in cache.
I prompt sotto una lunghezza minima non vengono messi in cache e non viene restituito alcun errore. Per i modelli Claude attuali che abbiamo usato, Fable 5.1, Opus 5.5, Sonnet 5.5 e Haiku 5.5, il minimo documentato è di 512 token. Le voci della cache sono isolate per organizzazione e, sull'API di Claude, per workspace.
Quanto costa
La durata predefinita è di cinque minuti, e ogni uso della voce la rinnova senza costi aggiuntivi. È disponibile anche una durata di un'ora. Scrivere una voce costa 1,25 volte il prezzo base dell'input per cinque minuti e 2 volte per un'ora. Leggerla costa 0,1 volte il prezzo base dell'input sulla maggior parte dei modelli, 0,05 volte su Opus 5.5 e Sonnet 5.5 e 0,025 volte su Fable 5.1, secondo la pagina dei prezzi. Questi moltiplicatori cambiano, quindi leggi la pagina aggiornata prima di fare qualsiasi calcolo.
Cosa il prompt caching non può eliminare
Il prompt caching sconta la lettura del prefisso. Non salta il modello. Ogni richiesta produce comunque una risposta nuova, devi comunque attenderla e ogni token di output viene fatturato al prezzo pieno dell'output.
Il nostro benchmark mostra quanto conta. Abbiamo inviato 3.000 domande di assistenza clienti a ciascuno di quattro modelli Claude, con una policy da 2.200 token come prompt di sistema e il caching del provider attivo. Tra il 90% e il 93% dei token conteggiati erano letture dalla cache di quella policy. L'output era solo dal 6% al 9% dei token, eppure pesava dal 73% al 92% del costo di baseline. Il prefisso era già economico, quindi la spesa rimasta stava nelle risposte.
È il vuoto che riempiono gli altri strati. Il metodo completo e i risultati sono nel benchmark sul risparmio di token.
Caching esatto e semantico delle risposte
Due strati rispondono a una richiesta dalla memoria. Si differenziano per il modo in cui decidono che una richiesta nuova corrisponde a una vecchia.
Caching esatto delle risposte
Una cache esatta conserva la risposta finale sotto una chiave costruita con tutto ciò che la determina. Normalmente sono il modello, la versione del prompt e la domanda normalizzata. Quando arriva di nuovo la stessa richiesta, viene restituita la risposta salvata e il modello non viene chiamato. Non c'è alcun punteggio di similarità e nessun rischio di restituire una risposta pensata per un'altra domanda.
Nella nostra esecuzione la cache esatta ha risposto a circa il 39% delle richieste. Una domanda ripetuta è tornata in una mediana di circa 0,05 ms. È stato misurato con un client Python in loopback sulla stessa macchina, quindi vale come dato locale e non di rete. Il benchmark ha usato semplici GET e SET per questo strato. HotKV Enterprise ha anche una cache dei prompt a corrispondenza esatta dedicata, PCACHE.*, con limiti per namespace e tracciamento dei costi.
Il caching esatto non vede le differenze di formulazione. "Come reimposto la password?" e "Ho dimenticato la password" sono due chiavi diverse.
Caching semantico
Una cache semantica cerca il significato della domanda. Trasforma la domanda in un embedding, trova la domanda salvata più vicina e ne restituisce la risposta se la similarità coseno supera una soglia. In HotKV è SCACHE.*, costruito sullo stesso indice vettoriale della ricerca vettoriale.
Circa il 31% delle nostre richieste ha avuto risposta in questo modo. Una parafrasi ha richiesto una mediana di circa 130 ms, quasi tutti per la chiamata al servizio di embedding, quindi un hit semantico è molto più rapido di una chiamata al modello ma non istantaneo. Senza lo strato semantico, la sola cache esatta avrebbe richiesto al massimo 1.264 chiamate al modello su 3.000, circa il 58% in meno. Lo strato semantico ha portato il risparmio a circa il 70%.
È anche il punto in cui sta il rischio. Una domanda simile non è sempre la stessa domanda. Abbiamo fatto giudicare a un secondo modello Claude ogni hit semantico, confrontandolo con una risposta nuova. Alla nostra soglia predefinita di 0,81, le risposte in cache erano adeguate alla domanda esatta con una frequenza inferiore, tra 5,8 e 10,7 punti percentuali, rispetto a quelle nuove. Su Sonnet 5.5, le soglie da 0,88 in su non hanno mostrato questo scarto, con prove scarse. Le domande scritte per differire in un dettaglio decisivo hanno comunque trovato corrispondenza nel 62% dei casi a 0,81 e nel 10% a 0,95.
Prompt caching e caching semantico a confronto
| Prompt caching del provider | Cache esatta delle risposte | Cache semantica | |
|---|---|---|---|
| Cosa elimina | Una parte del prezzo dell'input | L'intera chiamata al modello | L'intera chiamata al modello |
| Regola di corrispondenza | Prefisso identico | Richiesta identica | Significato simile oltre una soglia |
| Token di output fatturati | Sì, ogni volta | No, in caso di hit | No, in caso di hit |
| Rischio di risposta sbagliata | Nessuno | Nessuno per richieste identiche | Reale, regolato dalla soglia |
| Dove viene eseguito | Presso il provider | Nella tua cache | Nella tua cache, più una chiamata di embedding |
| Quota di richieste nella nostra esecuzione | Sempre attivo | Circa il 39% | Circa il 31% |
Il prompt caching del provider e il caching delle risposte non sono alternative. Uno riduce il prezzo delle chiamate che continui a fare, l'altro riduce il numero di chiamate.
Cosa fa il caching alla latenza
Saltare il modello cambia la rapidità con cui arrivano le risposte, oltre a quanto costano. Nella nostra esecuzione il tempo mediano per una risposta completa è sceso da 2,7 secondi a 127 ms su Fable 5.1, da 2,9 secondi a 126 ms su Opus 5.5, da 1,8 secondi a 128 ms su Sonnet 5.5 e da 1,4 secondi a 125 ms su Haiku 5.5. Alla mediana è da 11 a 23 volte più veloce.
La coda lenta si è mossa appena. Circa il 30% delle richieste arrivava comunque al modello, e il 99º percentile su Fable 5.1 era di circa 6,4 secondi con HotKV contro 6,6 secondi senza. Una cache elimina l'attesa per le richieste a cui risponde e non fa nulla per quelle che manca. Se il tuo problema è un caso peggiore lento e non un caso tipico lento, il solo caching non lo risolverà.
Questi sono tempi fino alla risposta completa, perché le chiamate non erano in streaming. Una risposta in streaming mostra prima le sue prime parole. In una finestra di chat il divario è più piccolo di quello che emerge da questi numeri.
Scegliere uno strato per il tuo traffico
Lo strato giusto dipende da come si ripetono le tue richieste, e puoi misurarlo prima di costruire qualsiasi cosa.
Abbina lo strato al traffico
Abbina lo strato al modo in cui si ripetono le tue richieste.
- Un prompt di sistema o un elenco di strumenti lungo e stabile: usa il prompt caching del provider. Costa poco attivarlo e non cambia nessuna risposta.
- La stessa domanda con le stesse parole, come un pulsante, un template o un nuovo tentativo: usa una cache esatta delle risposte. È sicura e veloce.
- Traffico di assistenza, ricerca e FAQ in cui le persone chiedono la stessa cosa con parole diverse: aggiungi una cache semantica, imposta la soglia alta e verifica la qualità delle risposte sulle tue domande prima di fidartene.
- Risposte che dipendono dall'utente, dall'orologio o da dati in tempo reale: non metterne in cache nessuna, oppure costruisci la chiave della cache sui fatti che cambiano la risposta.
Il risparmio segue la ripetizione. Quando abbiamo reso ogni intent ugualmente probabile invece che asimmetrico, il costo è sceso del 56% sui due modelli che abbiamo rieseguito, e con 3.000 domande tutte diverse è sceso del 38%. Un workload senza domande ripetute o simili non fa risparmiare nulla.
Misura prima la tua ripetizione
Prima di costruire qualsiasi cosa, scopri quanta parte del tuo traffico si ripete. Il numero decide se vale la pena avere una cache esatta. Servono dieci minuti, con le domande che già registri. Normalizza ogni domanda come farà la chiave della tua cache, conta quelle distinte e guarda quanta parte del traffico era una ripetizione.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share è la frazione di richieste a cui avrebbe risposto una cache esatta, una volta vista ciascuna domanda una prima volta. Il nostro set di test aveva 1.264 domande distinte su 3.000 richieste, quindi il valore era di circa il 58%. Se il tuo risulta vicino al 5%, una cache esatta farà poco e solo uno strato semantico può aiutare.
Valgono due avvertenze. Una cache parte vuota, quindi le prime richieste arrivano sempre al modello. Nella nostra esecuzione circa il 52% delle prime mille richieste è stato servito dalla cache e circa l'81% delle ultime mille. Inoltre, un log del traffico del mese scorso ti parla del mese scorso. Se stai per lanciare una funzionalità che cambia ciò che le persone chiedono, considera il valore solo una guida approssimativa.
Mettere insieme gli strati
Una richiesta dovrebbe attraversare gli strati dal più economico e sicuro al più costoso, e dovresti poter vedere quanto ha fatto risparmiare ciascuno.
L'ordine di ricerca
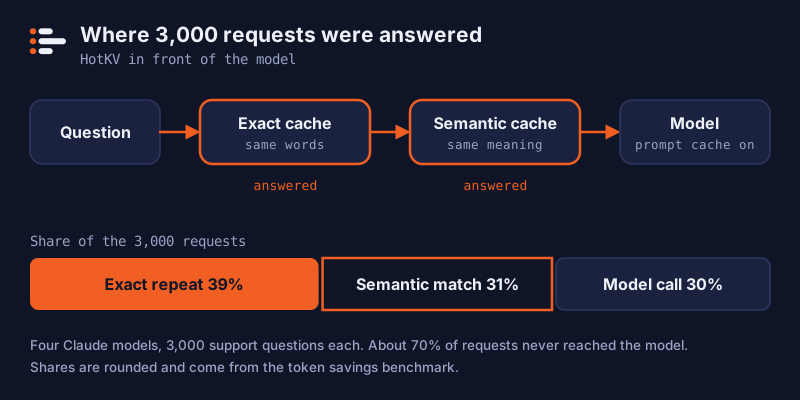
L'ordine conta. Controlla prima lo strato più economico e sicuro e chiama il modello solo quando tutto dà un miss. Questo schema presuppone un client in stile redis-py con decode_responses=True, due namespace creati in precedenza e le tue funzioni embed e llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # stesse parole

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # stesso significato

    reply = llm.complete(question)                   # qui si applica il prompt caching del provider
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Crea i namespace una sola volta con PCACHE.CREATE answers_exact e SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, usando la dimensione del tuo modello di embedding. Il set di comandi di IA è incluso nelle istanze HotKV Cloud Performance e Scale, e la pagina sull'IA elenca cosa fa ciascun motore. La pagina dei prezzi mostra cosa include ciascun piano.
Tenere il conto in produzione
Una cache che non puoi vedere è una cache di cui non puoi fidarti. HotKV conserva i conteggi di hit e miss per namespace. Se salvi con ogni voce l'uso di token della chiamata originale, può anche attribuire i token e il costo che ogni hit successivo ha evitato. Le risposte di PCACHE.STATS e SCACHE.STATS contengono allora campi come usage_saved_requests, usage_saved_input_tokens e usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Sostituisci <model> con l'id del tuo modello. INPUT conta i token di prompt non in cache e CACHEREAD i token che il provider ha servito dalla propria cache, quindi i due non si sovrappongono. Il modello deve essere nella tabella dei prezzi di HotKV perché il campo del costo abbia significato. LLMSTATS.PRICE LIST mostra quali modelli sono noti e LLMSTATS.PRICE SET aggiunge i tuoi. Un modello senza prezzo ha comunque i token conteggiati, ma il suo costo viene registrato come zero e un contatore separato indica che alcune richieste non avevano un prezzo.
Le cache riducono la spesa e un budget limita ciò che resta. LLMBUDGET.SET definisce un limite di token e di dollari su una finestra di tempo. LLMBUDGET.CONSUME viene controllato prima della chiamata al modello, quindi un agente fuori controllo viene fermato prima che spenda il denaro e non dopo. LLMSTATS.RECORD conserva i totali per tenant e comprende i token di lettura e scrittura della cache del provider. Tutti e tre usano un'unica tabella dei prezzi quando passi il nome del modello, quindi un risparmio, un budget e un valore della dashboard non possono contraddirsi.
Errori che fanno restituire risposte sbagliate a una cache
La maggior parte dei cattivi hit nasce da una chiave a cui manca qualcosa. Inserisci nella chiave esatta il modello, la versione del prompt e qualsiasi versione di strumenti o policy, così una modifica al prompt non può servire risposte scritte per il vecchio.
Dai alle voci una durata in linea con la velocità con cui cambiano i tuoi fatti. Tieni separati i tenant con namespace distinti, così la risposta di un cliente non viene mai proposta a un altro. Non mettere mai in cache una risposta che contiene dati personali, a meno che la chiave non includa di chi sono i dati.
Infine, misura sul tuo traffico. I nostri valori vengono da un solo dataset pubblico di brevi domande bancarie, da una policy fittizia e da un'esecuzione per condizione, e non sono una promessa per il tuo workload.
Domande frequenti
Che cos'è il prompt caching?
Il prompt caching è una funzione del provider di modelli che conserva per breve tempo l'inizio elaborato di un prompt. Una richiesta successiva che inizia con esattamente lo stesso testo viene fatturata a una tariffa più bassa per quella parte. Il modello viene comunque eseguito e produce una risposta nuova, quindi paghi comunque i token di output.
Il prompt caching è la stessa cosa del caching semantico?
No. Il prompt caching riusa un prefisso di prompt ripetuto e chiama comunque il modello. Il caching semantico restituisce una risposta salvata a una domanda di significato simile e salta la chiamata al modello. Affrontano costi diversi e possono essere usati insieme.
Il prompt caching riduce i costi dei token di output?
No. Abbassa solo il prezzo della lettura del prefisso in cache. Nel nostro benchmark l'output era dal 6% al 9% dei token ma dal 73% al 92% del costo di baseline con il prompt caching già attivo, ed è per questo che mettere in cache le risposte intere ha fatto risparmiare molto di più.
Quanto dura la cache dei prompt di Anthropic?
La durata predefinita è di cinque minuti, rinnovata a ogni uso della voce. È disponibile un'opzione da un'ora a un prezzo di scrittura più alto. Controlla la documentazione aggiornata, perché limiti e prezzi cambiano.
Posso usare insieme prompt caching e caching semantico?
Sì, ed è esattamente ciò che ha fatto il nostro benchmark. Il prompt caching del provider è rimasto attivo in entrambe le esecuzioni, e gli strati semantico ed esatto stavano davanti al modello. Gli hit della cache saltano la chiamata, e i miss beneficiano comunque del prefisso scontato.
Quale soglia di similarità dovrebbe usare una cache semantica?
Non esiste un valore universale. Noi abbiamo scelto 0,81 su uno split di train separato, e su Sonnet 5.5 le risposte in cache non hanno mostrato scarti di qualità rispetto a quelle nuove da 0,88 in su, con prove scarse. Parti alto, confronta le risposte in cache con quelle nuove sulle tue domande e abbassa la soglia solo se la qualità regge.

Continua la conversazione
Commenti
Domande sul metodo? Un risultato diverso sul tuo hardware? Condividi ciò che hai trovato. I commenti vengono revisionati prima di comparire.