Questo benchmark di latenza di Redis misura quanto tempo impiegano HotKV, Redis, Valkey e Dragonfly a rispondere a una frequenza di richieste fissa. I nostri benchmark precedenti misuravano il throughput, e un lettore ha giustamente osservato che il throughput non è tutto. Abbiamo quindi mantenuto il carico costante, lo abbiamo aumentato a gradini e registrato la mediana (p50) e il 99° percentile (p99) a ogni gradino. Abbiamo misurato anche il tempo di consegna del pub/sub.
In breve. In questo benchmark di latenza di Redis su AWS, HotKV e Dragonfly hanno sostenuto entrambi 1,6 milioni di GET al secondo, Redis con 8 thread di I/O circa 0,8 milioni, Valkey con 8 thread di I/O circa 0,4 milioni, e Redis e Valkey a thread singolo circa 0,2 milioni. Da 200.000 a 1,6 milioni di richieste al secondo il p99 di HotKV è rimasto tra 0,59 e 0,76 ms, contro 0,71 e 1,48 ms di Dragonfly. A carico leggero i prodotti multithread hanno pareggiato sul p99, e anche la consegna pub/sub è stata un pareggio.
Perché abbiamo fatto un benchmark di latenza di Redis a frequenza fissa
Un test di throughput spinge il server al massimo e riporta quanto ha servito. Questo dice poco su quanto aspetta una singola richiesta. Un test di latenza fissa quante richieste al secondo inviano i client e misura il tempo di ciascuna. Il server è allora sotto lo stesso carico di ogni altro prodotto, e i tempi si possono confrontare.
Questo tipo di test ha un tranello. memtier_benchmark è uno strumento a ciclo chiuso: un client attende la risposta prima di inviare la richiesta successiva. Se un server non regge, il client invia semplicemente meno richieste, e la latenza di quelle inviate sembra migliore di quanto sia. Contiamo quindi un gradino come sostenuto solo quando la frequenza ottenuta è almeno il 97 per cento di quella richiesta. I gradini che non superano la prova sono indicati come «NS» (non sostenuto) nelle tabelle e la loro latenza non viene mostrata.
Cosa abbiamo testato
Macchine
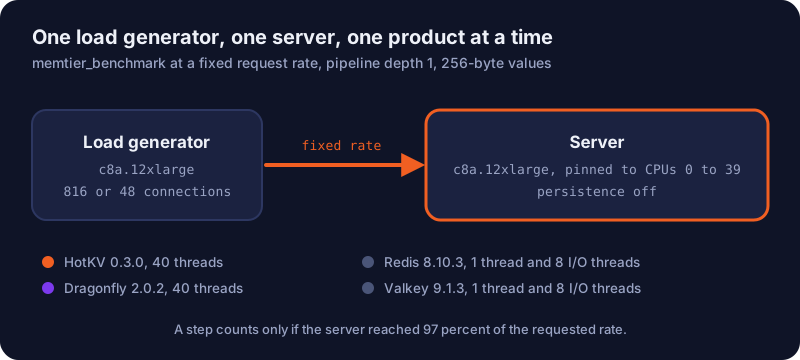
- Server e generatore di carico. Istanze
c8a.12xlarge(AMD EPYC 9R45, 48 core, senza SMT, 96 GiB, rete a 22,5 Gbit/s) in un cluster placement group AWS in eu-south-2a, con Ubuntu 24.04. Un’istanza eseguiva il generatore di carico e una il server. - Un prodotto alla volta. Ogni prodotto è stato eseguito da solo sul server, quindi nulla si sovrapponeva e nulla condivideva la rete. Ogni processo server era vincolato alle CPU da 0 a 39, con persistenza e modalità protetta disattivate.
Prodotti
- HotKV 0.3.0 con 40 thread.
- Dragonfly 2.0.2 con 40 thread proactor.
- Redis 8.10.3 e Valkey 9.1.3, ciascuno eseguito due volte, una con la configurazione predefinita a thread singolo e una con
--io-threads 8.
La riga di avvio e l’output dal vivo di CONFIG GET di ogni esecuzione sono salvati con i suoi risultati.
Carico e procedura
Il dataset era di 1.000.000 di chiavi con valori da 256 byte, e la profondità di pipeline era 1, quindi ogni richiesta attende la propria risposta. Il carico era solo GET e un mix di 1 scrittura ogni 10 letture. Ogni gradino è durato 20 secondi, due volte, e riportiamo la media delle due esecuzioni. memtier_benchmark ha usato un limite di frequenza per connessione e ha registrato un istogramma HDR. Abbiamo provato due numeri di connessioni.
- 816 connessioni (24 thread da 34 connessioni), per frequenze da 20.000 a 2,4 milioni di richieste al secondo.
- 48 connessioni (4 thread da 12 connessioni), per frequenze fino a 300.000 richieste al secondo. Oltre, 48 connessioni non possono raggiungere la frequenza, perché ogni connessione può inviare solo tanto in fretta quanto riceve risposte.
Risultati
Prima vengono le tabelle GET, una per ogni numero di connessioni, poi il pub/sub.
Con 816 connessioni
Ogni cella mostra p50 / p99 in millisecondi, per GET. «NS» significa non sostenuto, e tra parentesi c’è la frequenza raggiunta. Un trattino significa che la scansione per quel prodotto si era già fermata.
| Richieste/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 thread di I/O | Valkey 1 thread | Valkey 8 thread di I/O |
|---|---|---|---|---|---|---|
| 19.584 | 0,38 / 1,81 | 0,48 / 1,90 | 1,63 / 5,29 | 0,68 / 2,07 | 1,59 / 5,13 | 0,76 / 2,63 |
| 99.552 | 0,24 / 0,76 | 0,27 / 1,76 | 2,60 / 5,12 | 0,40 / 0,98 | 2,65 / 5,13 | 1,71 / 3,19 |
| 199.920 | 0,25 / 0,59 | 0,25 / 1,34 | 2,91 / 5,60 | 0,55 / 1,11 | 3,02 / 5,81 | 1,11 / 2,15 |
| 399.840 | 0,27 / 0,63 | 0,27 / 1,48 | NS (258k) | 0,62 / 1,23 | NS (259k) | 1,24 / 1,49 |
| 799.680 | 0,28 / 0,75 | 0,28 / 1,26 | - | 0,68 / 1,18 | - | NS (670k) |
| 1.199.520 | 0,28 / 0,67 | 0,28 / 1,05 | - | NS (1.078k) | - | - |
| 1.599.360 | 0,28 / 0,64 | 0,28 / 0,71 | - | - | - | - |
| 2.399.856 | NS (2.284k) | NS (2.281k) | - | - | - | - |
Il carico misto ha dato lo stesso quadro. Il p99 di HotKV è stato compreso tra 0,54 e 0,75 ms da 200.000 a 1,6 milioni di richieste al secondo, e i punti che ogni prodotto poteva sostenere sono stati gli stessi di GET. Tutto è nella cartella dei risultati.
Come leggere le righe a thread singolo
Le mediane tra 1,6 e 3 ms di Redis e Valkey a thread singolo con 816 connessioni non sono la loro latenza a regime. Con un limite di frequenza, memtier_benchmark fa partire tutte le 816 connessioni nello stesso istante. Un server a thread singolo deve smaltire quella raffica di 816 richieste una dopo l’altra, quindi la mediana di una richiesta include il suo posto in coda. Abbiamo eseguito il test a 48 connessioni qui sotto per eliminare questo effetto.
Con 48 connessioni
Le celle hanno lo stesso significato di sopra, solo per GET.
| Richieste/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 thread di I/O | Valkey 1 thread | Valkey 8 thread di I/O |
|---|---|---|---|---|---|---|
| 9.984 | 0,14 / 0,54 | 0,14 / 0,37 | 0,21 / 0,89 | 0,17 / 0,92 | 0,21 / 0,91 | 0,20 / 0,81 |
| 49.968 | 0,10 / 0,28 | 0,11 / 0,28 | 0,21 / 0,41 | 0,13 / 0,28 | 0,21 / 0,43 | 0,21 / 0,44 |
| 99.984 | 0,09 / 0,28 | 0,10 / 0,28 | 0,20 / 0,40 | 0,13 / 0,28 | 0,20 / 0,38 | 0,19 / 0,35 |
| 199.968 | 0,08 / 0,27 | 0,08 / 0,27 | 0,20 / 0,35 | 0,10 / 0,27 | 0,21 / 0,36 | 0,11 / 0,28 |
| 300.000 | 0,08 / 0,27 | 0,08 / 0,27 | NS (231k) | 0,09 / 0,26 | NS (233k) | 0,09 / 0,26 |
Tempo di consegna del pub/sub
Abbiamo misurato il tempo dalla pubblicazione alla consegna a un sottoscrittore, con 64 publisher, 100 sottoscrittori e un payload di 128 byte, usando pubsub-sub-bench. Ogni messaggio andava a un sottoscrittore. Le celle mostrano p50 / p99 in millisecondi.
| Consegne/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 thread di I/O | Valkey 1 thread | Valkey 8 thread di I/O |
|---|---|---|---|---|---|---|
| circa 21.000 | 0,10 / 0,71 | 0,10 / 0,65 | 0,11 / 0,74 | 0,11 / 0,62 | 0,11 / 0,76 | 0,12 / 0,78 |
| circa 107.000 | 0,10 / 1,02 | 0,12 / 0,92 | 0,10 / 0,80 | 0,11 / 0,63 | 0,10 / 0,82 | 0,10 / 0,86 |
| circa 215.000 | 0,11 / 1,20 | 0,13 / 1,13 | 0,51 / 1,03 | 0,20 / 0,73 | 0,57 / 1,07 | 0,12 / 1,22 |
Tutti i prodotti hanno consegnato nello stesso intervallo. Al carico più alto i prodotti a thread singolo hanno avuto una mediana più alta, 0,51 e 0,57 ms contro 0,11 ms di HotKV.
Abbiamo anche dovuto correggere pubsub-sub-bench. Confrontava un tempo di pubblicazione in millisecondi con un tempo di ricezione in microsecondi. La patch è nella cartella dei risultati.
Cosa mostrano i risultati
Le tabelle mostrano un vantaggio per HotKV e Dragonfly a carico alto, un pareggio a carico leggero e un limite massimo per Redis e Valkey a thread singolo.
HotKV e Dragonfly hanno mantenuto una coda bassa fino a 1,6 milioni di richieste al secondo
Entrambi hanno sostenuto 1,6 milioni di GET al secondo con 816 connessioni, con una mediana di 0,28 ms. Il p99 di HotKV è stato tra 0,59 e 0,76 ms da 200.000 richieste al secondo in su. Quello di Dragonfly è stato tra 0,71 e 1,48 ms, e a 1,6 milioni i due erano vicini (0,64 contro 0,71 ms). Redis e Valkey con thread di I/O hanno smesso di sostenere la frequenza a carichi più bassi, e Redis e Valkey a thread singolo intorno a 260.000.
A carico leggero i prodotti multithread pareggiano
Con 48 connessioni, fino a 300.000 richieste al secondo, HotKV, Dragonfly e Redis con 8 thread di I/O hanno avuto tutti un p99 di circa 0,27 ms. HotKV ha avuto la mediana più bassa, da 0,08 a 0,09 ms da 100.000 richieste al secondo, con Dragonfly tra 0,08 e 0,10 ms. Una differenza di 0,01 ms rientra in ciò che altre parti della configurazione possono causare, quindi non la rivendichiamo come vittoria.
Redis e Valkey a thread singolo si sono fermati a circa 230.000 al secondo
Con 48 connessioni avevano una mediana di circa 0,2 ms e un p99 tra 0,35 e 0,43 ms, e non hanno sostenuto 300.000 richieste al secondo (circa 231.000 e 233.000). È il limite di un singolo thread su questo hardware e con questo carico. Per questo Redis e Valkey vengono di solito eseguiti come molti processi o come cluster, come nel nostro benchmark del cluster.
Limiti
Sono misure di HotKV Ltd sulle versioni e sulla configurazione indicate sopra. Non sono un’affermazione su altre versioni, configurazioni o carichi di questi prodotti.
La configurazione del test
- Un server, un generatore di carico. Due ripetizioni per gradino, su un insieme di macchine in una data. Non abbiamo misurato la variazione tra macchine o tra giorni.
- Configurazioni scelte da noi. Redis e Valkey sono stati eseguiti con la configurazione predefinita a thread singolo e con
--io-threads 8, e non abbiamo ottimizzato nessuno dei due oltre questo. Altre impostazioni potrebbero cambiare le loro cifre. Se ritenete che un’impostazione qui svantaggi un prodotto, scriveteci e la verificheremo e pubblicheremo il risultato. - L’effetto raffica dello strumento. Con 816 connessioni, le mediane dei prodotti a thread singolo sono gonfiate dal modo in cui funziona il limite di frequenza di
memtier_benchmark, come spiegato sopra.
Cosa non è stato misurato
- Dati. Valori più grandi o sbilanciati, memoria per chiave e persistenza. La persistenza era disattivata su tutti i server.
- Modalità. Modalità cluster, pub/sub con shard, TLS, replica e failover.
- Fan-out pub/sub. Un messaggio a molti sottoscrittori.
Redis, Valkey e Dragonfly sono marchi dei rispettivi proprietari. Sono nominati solo per identificare il software misurato, e questo non implica sponsorizzazione, approvazione o affiliazione.
Riproducilo
Gli script di scansione, la riga di avvio e la configurazione dal vivo di ogni server, la patch di pubsub-sub-bench e tutti i risultati grezzi sono nel repository dei benchmark. Lo script di latenza è harness/lat_sweep.sh e quello del pub/sub è harness/ps_sweep.sh. La cartella raw contiene un archivio per test con il JSON di memtier_benchmark, gli istogrammi HDR e l’uso della CPU del server per ogni esecuzione.
Provalo tu stesso
HotKV Cloud gestisce HotKV per te. Inizia su HotKV Cloud oppure parla con le vendite per confrontare HotKV con il tuo carico.
Domande frequenti
HotKV è più veloce di Redis in latenza?
Sotto carico, alle frequenze che abbiamo testato, sì. Con 816 connessioni e 200.000 richieste al secondo HotKV ha avuto un p99 di 0,59 ms, Redis con 8 thread di I/O 1,11 ms e Redis a thread singolo 5,60 ms. A carico leggero con 48 connessioni i prodotti multithread hanno pareggiato sul p99, intorno a 0,27 ms.
Perché avete tenuto fissa la frequenza di richieste?
A frequenza fissa ogni prodotto porta lo stesso carico, quindi le latenze si possono confrontare. Un test di throughput mostra quanto serve un server al suo limite, il che dice poco su quanto aspetta una singola richiesta.
Che cosa significa «non sostenuto»?
Il prodotto ha raggiunto meno del 97 per cento della frequenza di richieste che avevamo chiesto. memtier_benchmark è uno strumento a ciclo chiuso, quindi un server sovraccarico fa inviare meno richieste ai client e la latenza delle richieste restanti sembra migliore di quanto sia. Per quei gradini non mostriamo la latenza.
Come si è confrontato il tempo di consegna del pub/sub?
Ai tre carichi testati tutti i prodotti hanno consegnato nello stesso intervallo, con una mediana di circa 0,1 ms ai due carichi più bassi. La tabella sopra riporta ogni cifra.
Posso riprodurre questo benchmark di latenza di Redis?
Sì. Gli script, le configurazioni e tutti i risultati grezzi sono nel repository dei benchmark. Servono due server sulla stessa rete, un generatore di carico e i quattro prodotti.
Continua la conversazione
Commenti
Domande sul metodo? Un risultato diverso sul tuo hardware? Condividi ciò che hai trovato. I commenti vengono revisionati prima di comparire.