
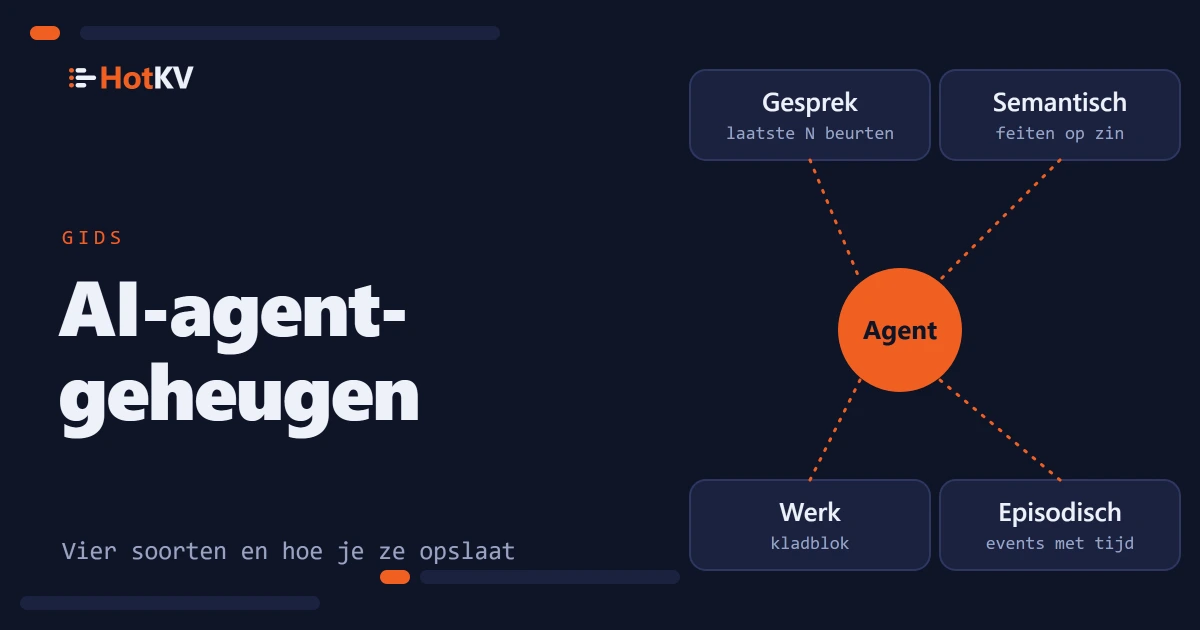
AI-agentgeheugen is wat een agent in staat stelt iets van de ene stap, of de ene sessie, mee te nemen naar de volgende. Een taalmodel onthoudt zelf niets tussen aanroepen. Wat het lijkt te onthouden, is door jouw code teruggezet in de prompt. Hoe je dat materiaal opslaat en ophaalt, bepaalt wat de agent zich kan herinneren, hoe snel en tegen welke kosten per beurt.
Kort samengevat. Agents hebben vier soorten geheugen nodig: een kort gespreksvenster, langetermijnfeiten die op betekenis worden gevonden, een kladblok voor de lopende taak en een logboek van wat er is gebeurd. Elk heeft een andere vorm, levensduur en opzoeking, dus één enkele geheugentabel past bij geen van allen goed. HotKV slaat alle vier op in één in-memory engine met de
AMEM.*-commando's. We hebben de caching en het vectorzoeken van HotKV gebenchmarkt, niet het agentgeheugen, dus dit artikel legt het ontwerp uit en claimt geen versnelling.
Waarom een contextvenster geen geheugen is
Een contextvenster is de tekst die je bij elk verzoek meestuurt. Het heeft een groottelimiet, je betaalt elke beurt invoertokens voor alles erin, en het verdwijnt wanneer de sessie eindigt. Het is ook niet doorzoekbaar. Als een agent één feit van drie weken geleden nodig heeft, is de hele geschiedenis erin plakken geen antwoord.
Geheugen is de laag die bepaalt wat er als volgende in het venster komt. Het bewaart de recente beurten en vindt de paar oudere feiten die ertoe doen. Het houdt de status van de huidige taak vast en legt vast wat de agent heeft gedaan. Onderzoekers beschrijven agents in vergelijkbare termen. Het CoALA-framework van Sumers, Yao, Narasimhan en Griffiths scheidt werkgeheugen van episodisch, semantisch en procedureel langetermijngeheugen.
De vier soorten AI-agentgeheugen
De vier opslagen van HotKV bestrijken grotendeels hetzelfde terrein, aangepast aan wat een applicatie moet bouwen. Procedureel geheugen, de knowhow in de code en prompts van de agent, leeft normaal in je repository of een promptregister en is geen eigen opslag.
Gespreksgeheugen
Dit is het kortetermijntranscript van één sessie. Berichten dragen een rol (system, user, assistant of tool). Ze staan in een begrensd schuivend venster, dus de oudste beurten vallen weg zodra de limiet is bereikt. Het beantwoordt één vraag. Wat is er recent gezegd? In HotKV zijn dat AMEM.CONV.CREATE, AMEM.CONV.APPEND en AMEM.CONV.WINDOW.
Semantisch geheugen
Semantisch geheugen is langetermijnkennis, opgeslagen als feiten met een embeddingvector. De agent haalt ze op betekenis op, niet op sleutel. Het wordt ondersteund door een HNSW-vectorindex, hetzelfde type dat het vectorzoeken aandrijft. AMEM.SEM.STORE slaat een feit op en AMEM.SEM.RECALL geeft de beste treffers terug met een gelijkenisscore. Hier horen documenten, gebruikersvoorkeuren en geleerde correcties thuis.
Werkgeheugen
Werkgeheugen is het kladblok voor een lopende taak, een platte set sleutels en waarden die tot een sessie is beperkt. Het bevat de huidige stap, het ticket dat wordt afgehandeld of een tussenresultaat. Het moet verdwijnen wanneer de taak eindigt. AMEM.WORK.SET accepteert een time-to-live juist daarom.
Episodisch geheugen
Episodisch geheugen is een append-only logboek van gebeurtenissen met tijdstempel, zoals een ondernomen actie, een gedane observatie of een genomen beslissing. Het laat een agent, of een persoon die hem beoordeelt, vragen wat er wanneer is gebeurd. AMEM.EPIS.LOG schrijft een gebeurtenis en AMEM.EPIS.QUERY leest ze terug op type en tijdsbereik.
AI-agentgeheugen in de praktijk
In de praktijk zijn twee dingen belangrijk. Hoe je naar het geheugen schrijft, en wat je bij elke beurt terugleest.
Geheugen opslaan met commando's
Hier is een supportagent die één gesprek afhandelt. De fictieve beleidstekst en de vectoren van drie getallen dienen alleen ter illustratie. Een echt embeddingmodel produceert vectoren van 768 of 1.536 getallen, en je maakt de namespace aan met die dimensie.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
Bij elke beurt leest de agent het recente venster en haalt hij de paar feiten op die bij de vraag passen. Hij controleert zijn werknotitie en bouwt de prompt uit die stukken op. Nadat hij heeft gehandeld, logt hij de gebeurtenis. Niets in die lus heeft de hele geschiedenis nodig.
Het geheugen bij elke beurt lezen
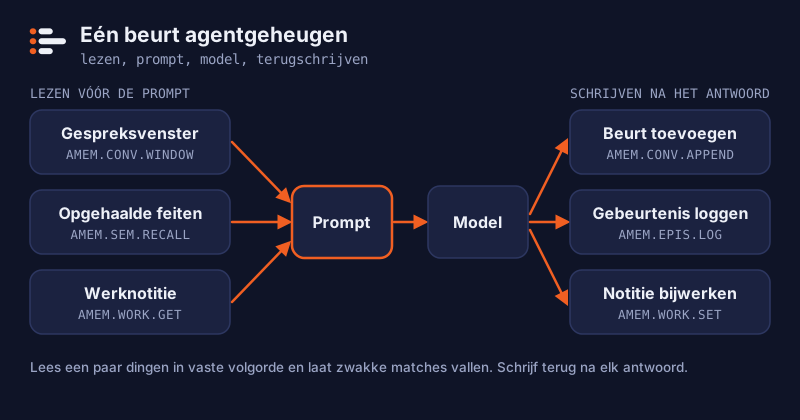
Geheugen opslaan is de makkelijke helft. De kunst is bepalen wat je terugleest, want alles wat je leest gaat de prompt in en kost invoertokens. Een redelijke lus leest een handvol dingen in een vaste volgorde. Eerst komen de recente beurten, dan de paar feiten die bij de vraag passen, dan de status van de taak. Hier staat ze met de officiële Python-client, met je eigen embeddingfunctie en promptsjabloon.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # afstellen op je eigen data

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # eenmalig aanmaken, vóór de eerste append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # je promptsjabloon

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
De afkapwaarde voor gelijkenis stel je zelf af. Een waarde die bij het ene embeddingmodel en de ene set feiten past, is verkeerd voor een ander, dus controleer de recall op vragen waarvan je de antwoorden kent. Zwakke treffers weglaten is belangrijker dan het lijkt, want een slecht feit in de prompt is erger dan geen feit.
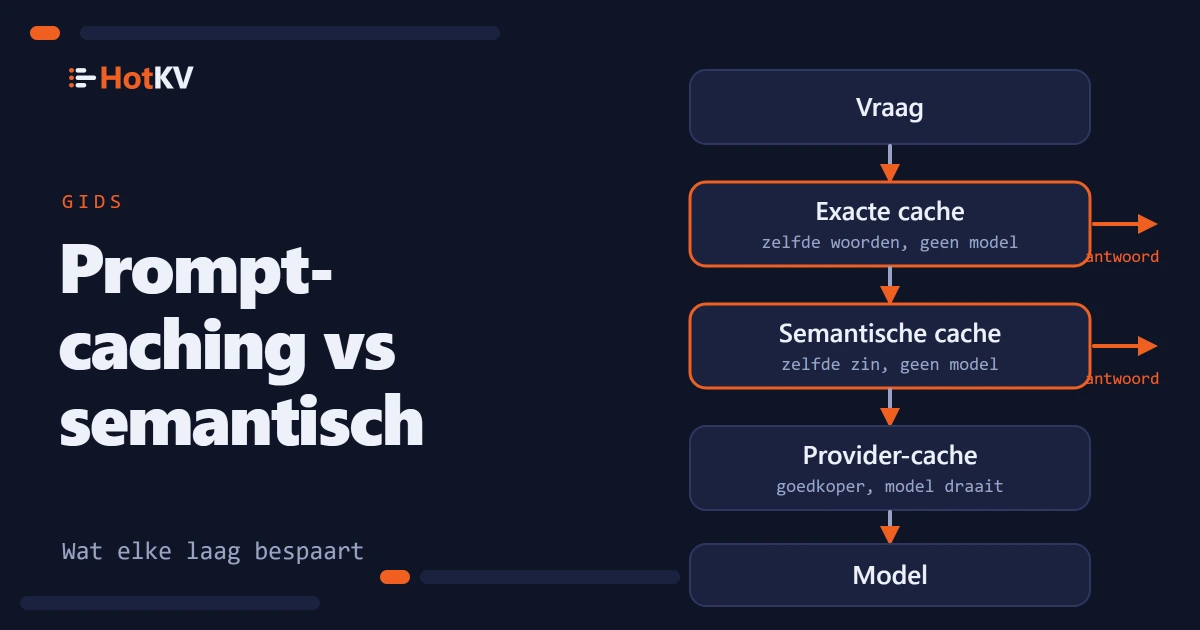
De stabiele delen van deze prompt, zoals de systeeminstructies, zijn ook het deel dat prompt-caching aan de kant van de provider goedkoper maakt. Zet het geheugen dat je leest aan het einde, na de stabiele tekst, zodat wijzigingen die cache niet ongeldig maken.
Samenvattingen in plaats van steeds langere vensters
Een venster laat oude beurten volledig vallen. Dat is prima voor kletspraat en slecht voor een lange taak, waar beurt 3 bij beurt 300 nog kan tellen. Een doorlopende samenvatting is het gebruikelijke antwoord. Na elk stuk gesprek schrijft de agent, of een goedkoper model, op wat er is geleerd, en de samenvatting vervangt de oude beurten in de prompt.
HotKV bewaart één samenvatting per agent met AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND en AMEM.SUMMARY.GET. SET vervangt de tekst en APPEND voegt een regel toe. Elke update verhoogt een versienummer, zodat een ander onderdeel goedkoop kan zien dat de samenvatting is veranderd en wanneer.
Een samenvatting is verliesgevend, en een samenvatting van een samenvatting verliest elke keer meer. Houd exacte waarden zoals identifiers, bedragen en datums uit de lopende tekst en in werkgeheugen of semantische feiten, waar ze behouden blijven. Gebruik de samenvatting voor de vorm van het werk, zoals voorkeuren, genomen beslissingen en wat er nog resteert.
Ontwerpregels en bewaartermijnen
Geheugen groeit zonder limiet tenzij je het stopt, dus stel de limieten in vóór de eerste schrijfactie.
Regels die het geheugen bruikbaar houden
- Begrens alles. Stel een
WINDOWin op gesprekken en eenTTLop sessies en werkwaarden. Voor gesprekken, werkwaarden en feiten legt HotKV de verlooptijd vast voor de append-only file en replica's, zodat een item dat is verlopen niet terugkomt wanneer het bestand na een herstart opnieuw wordt afgespeeld. - Sla feiten op, geen transcripties. Vat samen voordat je naar semantisch geheugen schrijft. Een feit is makkelijker op te halen dan een pagina dialoog.
- Houd agents gescheiden. Gebruik een aparte identifier of namespace per agent en per tenant, zodat het geheugen van de ene klant nooit voor een andere wordt opgehaald.
- Haal er een paar op, niet veel. Neem de beste drie tot vijf treffers en laat zwakke weg op gelijkenisscore voordat ze de prompt binnenkomen.
- Houd geheimen eruit. Geheugen wordt teruggelezen in prompts, dus sla nooit wachtwoorden, sleutels of data op die je het model niet zou laten zien.
Hoe lang elk type wordt bewaard
Deze levensduren zijn onze suggesties, geen standaardwaarden. Kies de jouwe op basis van hoe snel de onderliggende feiten veranderen en wat je mag bewaren.
| Geheugentype | Voorgestelde levensduur | Besturing in HotKV |
|---|---|---|
| Gesprek | De sessie, of een vaste periode zoals een dag | WINDOW en TTL op AMEM.CONV.CREATE |
| Werkgeheugen | De taak, daarna gewist | TTL op AMEM.WORK.SET, en AMEM.WORK.CLEAR |
| Semantisch | Tot het feit niet meer waar is | TTL op AMEM.SEM.STORE, en AMEM.SEM.FORGET |
| Episodisch | Zo lang als je audit- of supportbehoeften vereisen | AMEM.EPIS.QUERY op tijdsbereik, en AMEM.EPIS.CLEAR (gebeurtenissen hebben geen time-to-live) |
Bewaartermijn is ook een privacykwestie. Als het geheugen iets over een persoon bevat, is de levensduur die je kiest onderdeel van wat je hem belooft, dus leg die vast.
Hoe agentgeheugen misgaat
De meeste geheugenbugs zijn trage. De agent werkt een week goed en gaat dan slechter presteren. Dit zijn de fouten waartegen je moet ontwerpen.
Veelvoorkomende fouten
- Verouderde feiten. Een feit dat in maart waar was, wordt in oktober opgehaald. Geef feiten een time-to-live, of sla ze op onder een sleutel per entiteit zodat de nieuwe waarde de oude overschrijft.
- Tegenstrijdigheden. Twee opgeslagen feiten spreken elkaar tegen, en de agent kiest er willekeurig een. Geef de voorkeur aan één feit per sleutel boven nieuwe notities naast oude toevoegen.
- Te veel ophalen. Te veel treffers vullen de prompt met losjes verwante tekst. Haal er weinig op en laat zwakke treffers weg.
- Lekken tussen gebruikers. Het geheugen van de ene klant wordt voor een andere opgehaald. Aparte identifiers of namespaces voor elke tenant, in code gecontroleerd vóór elke read.
- Onbegrensde groei. Niets verloopt ooit, dus opzoekingen vertragen en kosten sluipen omhoog. Elk type heeft een levensduur nodig. Waar HotKV geen time-to-live heeft, zoals bij het episodische logboek, plan je zelf een wisbeurt of export.
- Drift in samenvattingen. Een samenvatting van een samenvatting komt langzaam niet meer overeen met wat er is gebeurd. Houd het gebeurtenislogboek als bron van waarheid en genereer samenvattingen daaruit opnieuw.
Behandel opgeslagen tekst als onbetrouwbaar
Het laatste punt verdient meer aandacht. Alles wat een agent naar het geheugen schrijft, kan later in een prompt worden gelezen. Dat omvat tekst die van een webpagina, een e-mail of een gebruiker kwam. Dat is de indirecte vorm van prompt injection die OWASP als LLM01 noemt. Sla de bron bij elk feit op. Vertrouw geheugen dat uit externe content is geschreven minder, en laat een opgehaalde notitie je systeemprompt nooit overrulen.
Wat we wel en niet hebben gemeten
De gepubliceerde benchmarks van HotKV bestrijken commandodoorvoer, vectorzoeken en de tokenbesparing van antwoordcaching. Agentgeheugen heeft nog geen eigen benchmark. We doen geen claim over de latentie ervan of over hoeveel het de kwaliteit van agents verbetert. Wat we wel kunnen zeggen is architecturaal. De vier opslagen draaien in hetzelfde proces als de cache en de vectorindex. Een geheugenopzoeking is één aanroep naar een systeem dat je al beheert.
De benchmark voor tokenbesparing en de vergelijking van prompt-caching en semantische cache tonen de gemeten kant. De use case voor agentgeheugen toont de commando's in een volledig scenario.
Agentgeheugen gebruiken vanuit Claude Code of Cursor
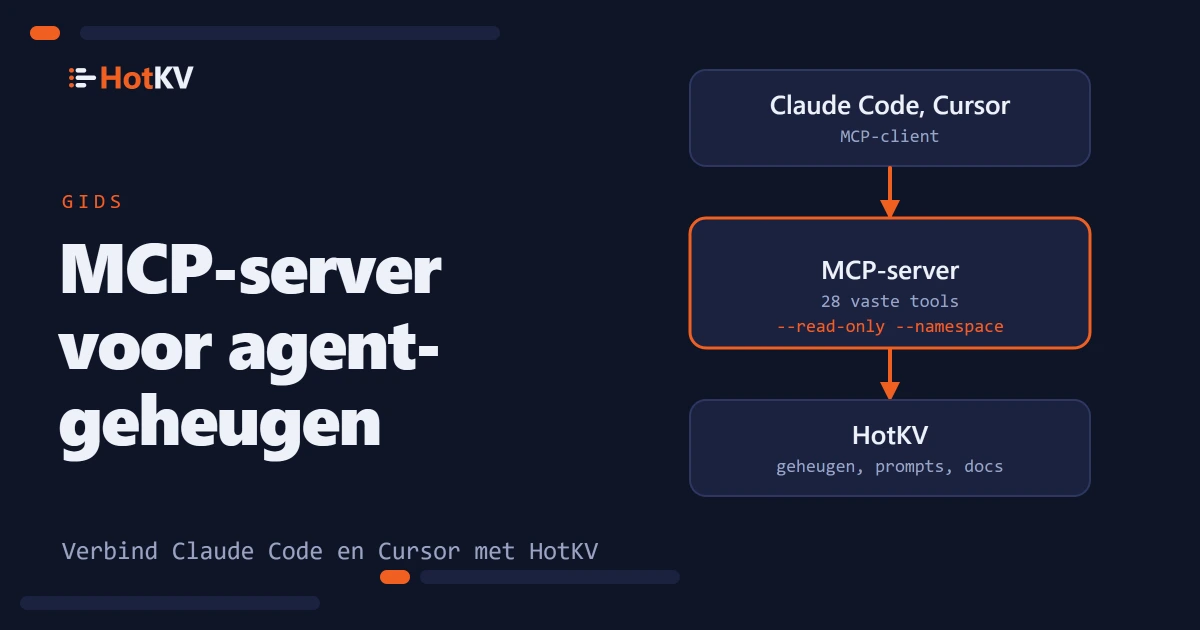
Een assistent die het Model Context Protocol ondersteunt, kan een deel van dit geheugen gebruiken zonder eigen code. De open-source hotkv-mcp-server stelt gespreksgeheugen, werknotities, een gebeurtenislogboek en een doorlopende samenvatting beschikbaar als tools. Hij heeft een alleen-lezenmodus en een namespace die de agent beperkt. Hij biedt geen semantisch geheugen aan, en zijn tools kunnen geen venster of time-to-live instellen, dus gebruik daarvoor de clientbibliotheek. Het volgende artikel, een MCP-server voor agentgeheugen, laat zien hoe je hem verbindt en wat zijn beveiligingen dekken.
Veelgestelde vragen
Wat is AI-agentgeheugen?
AI-agentgeheugen is de opslag- en ophaallaag waarmee een agent informatie bewaart over stappen en sessies heen. Het combineert meestal een recent gespreksvenster, langetermijnfeiten die op betekenis worden gevonden, een kladblok voor de huidige taak en een gebeurtenislogboek.
Wat is het verschil tussen kortetermijn- en langetermijnagentgeheugen?
Kortetermijngeheugen bevat wat nu gebeurt, zoals de recente beurten en de taakstatus, en is begrensd en tijdelijk. Langetermijngeheugen bevat kennis die een sessie moet overleven, zoals feiten, voorkeuren en eerdere gebeurtenissen, en wordt doorzocht wanneer dat nodig is.
Wat is een doorlopende samenvatting in agentgeheugen?
Een doorlopende samenvatting is een korte lopende beschrijving van wat een agent tot nu toe heeft geleerd of besloten, bijgewerkt naarmate het werk doorgaat. Ze vervangt oude beurten in de prompt zodat de prompt niet blijft groeien. HotKV slaat er één per agent op en verhoogt bij elke update een versienummer.
Heb ik een vectordatabase nodig voor agentgeheugen?
Alleen voor semantisch geheugen, waar feiten op betekenis worden gevonden. Gespreksvensters, werkstatus en gebeurtenislogboeken hebben geen vectoren nodig. HotKV houdt alle vier in één engine, dus de vectorindex en de andere opslagen zijn geen aparte systemen.
Hoe lang moet agentgeheugen worden bewaard?
Dat hangt van het type af. Werkgeheugen moet verlopen wanneer de taak eindigt, gesprekken na de sessie of een vaste periode, en episodische logboeken zo lang als je auditbehoeften vereisen. Feiten in semantisch geheugen moeten worden beoordeeld en verwijderd wanneer ze niet meer waar zijn.
Kan agentgeheugen worden aangevallen?
Ja. Tekst die naar het geheugen wordt geschreven, wordt later in prompts gelezen, dus een vergiftigde notitie kan de agent sturen. Leg vast waar elk feit vandaan komt, vertrouw externe content minder en houd opgehaald geheugen qua autoriteit onder je systeemprompt.
Slaat HotKV agentgeheugen op in RAM?
HotKV is een in-memory engine, dus reads worden uit het geheugen bediend. Schrijfacties naar de vier opslagen worden vastgelegd voor de append-only file en voor replica's, met verlooptijden doorgegeven, volgens de productdocumentatie.
Zet het gesprek voort
Reacties
Vragen over de methode? Een ander resultaat op jouw hardware? Deel wat je hebt gevonden. Reacties worden beoordeeld voordat ze verschijnen.