
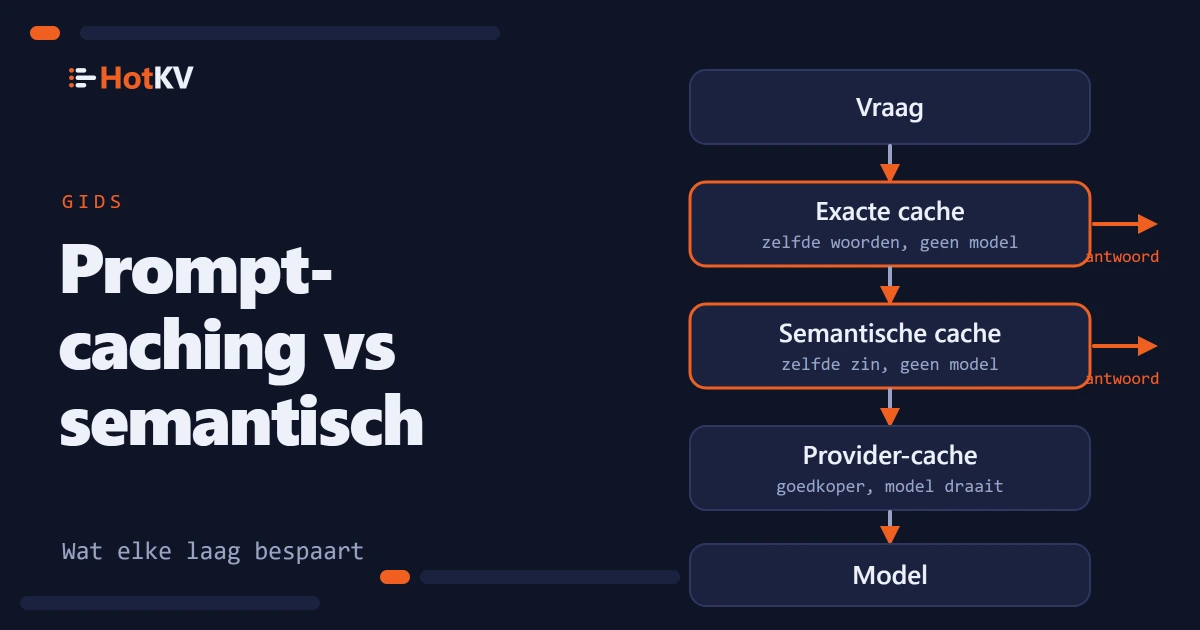
Er worden twee verschillende dingen als caching voor taalmodellen verkocht, en teams kopen regelmatig het ene terwijl ze het andere verwachten. Prompt-caching is een functie van de provider die een herhaald promptvoorvoegsel goedkoper te lezen maakt. Semantische cache is een laag die je zelf draait en die een vraag uit het geheugen beantwoordt, zodat het model nooit wordt aangeroepen. Ze lossen verschillende helften van de rekening op, en ze werken het best samen.
Kort samengevat. Prompt-caching geeft korting op het herhaalde begin van een prompt, zoals een lange systeemprompt, maar het model draait nog steeds en je betaalt nog steeds voor elk uitvoertoken. Exacte en semantische cache verwijderen de aanroep helemaal wanneer een vraag al eerder is beantwoord. In onze benchmark met 3.000 verzoeken, met de prompt-caching van de provider al aan, verlaagde HotKV ervoor de modelaanroepen, tokens en kosten met ongeveer 70%, omdat uitvoertokens nog steeds 73% tot 92% van de basiskosten uitmaakten.
Hoe prompt-caching werkt
Prompt-caching leeft bij de modelprovider. Je markeert het stabiele begin van een verzoek, meestal de tools en de systeemprompt, en de provider bewaart de verwerkte vorm ervan voor korte tijd. Het volgende verzoek dat met identieke tekst begint, wordt voor dat deel tegen een gereduceerd tarief gefactureerd. We beschrijven hier de versie van Anthropic omdat we die hebben gemeten. De onderstaande details komen uit de documentatie over prompt-caching, gecontroleerd op 18 oktober 2026.
Wat wordt gecachet
Een hit vereist een exacte match. Elk blok tot en met het blok dat je met cache_control hebt gemarkeerd moet identiek zijn, in de volgorde tools, systeemprompt, daarna berichten. Verander één teken vroeg in de prompt en alles erna is een miss. De vraag zelf komt als laatste, dus hij maakt nooit deel uit van het gecachete voorvoegsel.
Prompts onder een minimale lengte worden niet gecachet en er wordt geen fout teruggegeven. Voor de actuele Claude-modellen die we gebruikten, Fable 5.1, Opus 5.5, Sonnet 5.5 en Haiku 5.5, is het gedocumenteerde minimum 512 tokens. Cache-items zijn per organisatie geïsoleerd, en op de Claude API per workspace.
Wat het kost
De standaardlevensduur is vijf minuten, en elk gebruik van het item ververst hem zonder extra kosten. Een levensduur van een uur is beschikbaar. Een item schrijven kost 1,25 keer de basisprijs voor invoer bij vijf minuten en 2 keer bij een uur. Lezen kost 0,1 keer de basisprijs voor invoer bij de meeste modellen, 0,05 keer bij Opus 5.5 en Sonnet 5.5 en 0,025 keer bij Fable 5.1, volgens de prijzenpagina. Die vermenigvuldigers veranderen, dus lees de actuele pagina voordat je gaat rekenen.
Wat prompt-caching niet kan verwijderen
Prompt-caching geeft korting op het lezen van het voorvoegsel. Het slaat het model niet over. Elk verzoek levert nog steeds een vers antwoord op, je wacht er nog steeds op en elk uitvoertoken wordt tegen de volle uitvoerprijs gefactureerd.
Onze benchmark laat zien hoeveel dat uitmaakt. We stuurden 3.000 klantenservicevragen naar elk van vier Claude-modellen met een beleid van 2.200 tokens als systeemprompt en provider-caching aan. Tussen 90% en 93% van de getelde tokens waren cache-reads van dat beleid. Uitvoer was slechts 6% tot 9% van de tokens, maar toch 73% tot 92% van de basiskosten. Het voorvoegsel was al goedkoop, dus de resterende uitgaven zaten in de antwoorden.
Dat is het gat dat de andere lagen vullen. De volledige methode en resultaten staan in de benchmark voor tokenbesparing.
Exacte en semantische antwoordcache
Twee lagen beantwoorden een verzoek uit het geheugen. Ze verschillen in hoe ze beslissen dat een nieuw verzoek bij een oud past.
Exacte antwoordcache
Een exacte cache slaat het uiteindelijke antwoord op onder een sleutel die is opgebouwd uit alles wat het bepaalt. Normaal zijn dat het model, de promptversie en de genormaliseerde vraag. Wanneer hetzelfde verzoek opnieuw binnenkomt, wordt het opgeslagen antwoord teruggegeven en wordt het model niet aangeroepen. Er is geen gelijkenisscore en geen risico dat een antwoord voor een andere vraag wordt teruggegeven.
In onze run beantwoordde de exacte cache ongeveer 39% van de verzoeken. Een herhaalde vraag kwam terug in een mediaan van ongeveer 0,05 ms. Dat is gemeten met een Python-client via loopback op dezelfde machine, dus lees het als een lokaal cijfer en niet als een netwerkcijfer. De benchmark gebruikte voor deze laag gewone GET en SET. HotKV Enterprise heeft ook een speciale promptcache met exacte match, PCACHE.*, met limieten per namespace en kostentracking.
Exacte cache is blind voor formulering. "How do I reset my password?" en "I forgot my password" zijn twee verschillende sleutels.
Semantische cache
Een semantische cache zoekt op de betekenis van de vraag. Hij zet de vraag om in een embedding, vindt de dichtstbijzijnde opgeslagen vraag en geeft het antwoord ervan terug als de cosinusgelijkenis een drempel haalt. In HotKV is dat SCACHE.*, gebouwd op dezelfde vectorindex als het vectorzoeken.
Ongeveer 31% van onze verzoeken werd zo beantwoord. Een parafrase duurde een mediaan van ongeveer 130 ms, bijna helemaal de aanroep naar de embeddingservice, dus een semantische hit is veel sneller dan een modelaanroep maar niet instant. Zonder de semantische laag had een exacte cache alleen hooguit 1.264 modelaanroepen van de 3.000 nodig gehad, ongeveer 58% minder. De semantische laag bracht de besparing naar ongeveer 70%.
Daar zit ook het risico. Een vergelijkbare vraag is niet altijd dezelfde vraag. We lieten een tweede Claude-model elke semantische hit beoordelen tegen een vers antwoord. Bij onze standaarddrempel van 0,81 pasten gecachete antwoorden 5,8 tot 10,7 procentpunten minder vaak bij de exacte vraag dan verse. Op Sonnet 5.5 lieten drempels van 0,88 en hoger zo'n tekort niet zien, met dun bewijs. Vragen die zo waren geschreven dat ze door één beslissend detail verschilden, matchten nog steeds 62% van de tijd bij 0,81 en 10% bij 0,95.
Prompt-caching vs semantische cache naast elkaar
| Prompt-caching van de provider | Exacte antwoordcache | Semantische cache | |
|---|---|---|---|
| Wat het verwijdert | Een deel van de invoerprijs | De hele modelaanroep | De hele modelaanroep |
| Matchregel | Identiek voorvoegsel | Identiek verzoek | Vergelijkbare betekenis boven een drempel |
| Gefactureerde uitvoertokens | Ja, elke keer | Nee, bij een hit | Nee, bij een hit |
| Risico op verkeerde antwoorden | Geen | Geen voor identieke verzoeken | Reëel, afgesteld met de drempel |
| Draait waar | Bij de provider | In je cache | In je cache, plus een embedding-aanroep |
| Aandeel van de verzoeken in onze run | Altijd aan | Ongeveer 39% | Ongeveer 31% |
Prompt-caching van de provider en antwoordcache zijn geen alternatieven. De ene verlaagt de prijs van de aanroepen die je nog doet, en de andere verlaagt het aantal aanroepen dat je doet.
Wat caching met latentie doet
Het model overslaan verandert hoe snel antwoorden aankomen, en niet alleen wat ze kosten. In onze run daalde de mediane tijd tot een volledig antwoord van 2,7 seconden naar 127 ms op Fable 5.1, van 2,9 seconden naar 126 ms op Opus 5.5, van 1,8 seconden naar 128 ms op Sonnet 5.5 en van 1,4 seconden naar 125 ms op Haiku 5.5. Dat is 11 tot 23 keer sneller op de mediaan.
Het trage einde bewoog nauwelijks. Ongeveer 30% van de verzoeken bereikte nog steeds het model, en het 99e percentiel op Fable 5.1 was ongeveer 6,4 seconden met HotKV tegen 6,6 seconden zonder. Een cache neemt het wachten weg voor de verzoeken die hij beantwoordt en doet niets voor de verzoeken die hij mist. Als je klacht een trage slechtste situatie is in plaats van een trage typische situatie, lost caching alleen het niet op.
Dit zijn tijden tot het volledige antwoord, omdat de aanroepen niet werden gestreamd. Een gestreamd antwoord toont zijn eerste woorden eerder. Het verschil in een chatvenster is kleiner dan het verschil in deze cijfers.
Een laag kiezen voor jouw verkeer
De juiste laag hangt af van hoe je verzoeken zich herhalen, en dat kun je meten voordat je iets bouwt.
Stem de laag af op het verkeer
Stem de laag af op hoe je verzoeken zich herhalen.
- Een lange, stabiele systeemprompt of toollijst: gebruik prompt-caching van de provider. Het kost weinig om aan te zetten en verandert geen antwoorden.
- Dezelfde vraag in dezelfde woorden, zoals een knop, een template of een retry: gebruik een exacte antwoordcache. Het is veilig en snel.
- Support-, zoek- en FAQ-verkeer waar mensen hetzelfde in andere woorden vragen: voeg een semantische cache toe, stel de drempel hoog in en controleer de antwoordkwaliteit op je eigen vragen voordat je hem vertrouwt.
- Antwoorden die afhangen van de gebruiker, de klok of live data: cache ze niet, of sleutel de cache op de feiten die het antwoord veranderen.
Besparingen volgen herhaling. Toen we elke intentie even waarschijnlijk maakten in plaats van scheef verdeeld, daalden de kosten met 56% op de twee modellen die we opnieuw draaiden, en met 3.000 volledig verschillende vragen daalden ze met 38%. Een workload zonder herhaalde of vergelijkbare vragen bespaart niets.
Meet eerst je eigen herhaling
Zoek uit hoeveel van je verkeer zich herhaalt voordat je iets bouwt. Dat getal bepaalt of een exacte cache de moeite waard is. Het kost tien minuten met de vragen die je al logt. Normaliseer elke vraag zoals je cachesleutel dat zal doen, tel de afzonderlijke vragen en kijk hoeveel van het verkeer een herhaling was.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share is de fractie van de verzoeken die een exacte cache zou hebben beantwoord, zodra hij elke vraag een eerste keer had gezien. Onze testset had 1.264 afzonderlijke vragen onder 3.000 verzoeken, dus het cijfer was ongeveer 58%. Als het jouwe rond 5% uitkomt, doet een exacte cache weinig, en kan alleen een semantische laag helpen.
Twee waarschuwingen gelden. Een cache begint leeg, dus de eerste verzoeken bereiken altijd het model. In onze run werd ongeveer 52% van de eerste duizend verzoeken uit de cache bediend en ongeveer 81% van de laatste duizend. En een log van het verkeer van vorige maand vertelt je over vorige maand. Als je op het punt staat een functie te lanceren die verandert wat mensen vragen, behandel het cijfer dan als een grove richtlijn.
De lagen samenvoegen
Een verzoek moet door de lagen gaan van de goedkoopste en veiligste naar de duurste, en je moet kunnen zien wat elk heeft bespaard.
De volgorde van opzoeken
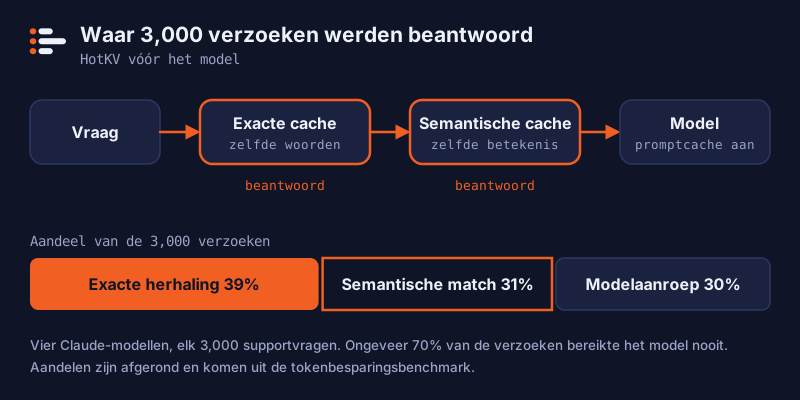
De volgorde doet ertoe. Controleer eerst de goedkoopste en veiligste laag en roep het model alleen aan wanneer alles mist. Dit schetsje gaat uit van een client in redis-py-stijl met decode_responses=True, twee van tevoren aangemaakte namespaces en je eigen functies embed en llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # dezelfde woorden

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # dezelfde betekenis

    reply = llm.complete(question)                   # prompt-caching van de provider geldt hier
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Maak de namespaces eenmalig aan met PCACHE.CREATE answers_exact en SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, met de dimensie van je embeddingmodel. De AI-commandoset wordt meegeleverd met HotKV Cloud-instanties van Performance en Scale, en de AI-pagina toont wat elke engine doet. De prijzenpagina toont welk plan wat bevat.
De score bijhouden in productie
Een cache die je niet kunt zien, is een cache die je niet kunt vertrouwen. HotKV houdt hit- en misstellers per namespace bij. Als je het tokengebruik van de oorspronkelijke aanroep bij elk item opslaat, kan het ook de tokens en kosten toerekenen die elke latere hit heeft vermeden. De antwoorden van PCACHE.STATS en SCACHE.STATS bevatten dan velden zoals usage_saved_requests, usage_saved_input_tokens en usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Vervang <model> door de id van je model. INPUT telt de niet-gecachete prompttokens en CACHEREAD de tokens die de provider uit zijn eigen cache serveerde, dus de twee overlappen niet. Het model moet in de prijstabel van HotKV staan om het kostenveld betekenis te geven. LLMSTATS.PRICE LIST toont welke modellen bekend zijn en LLMSTATS.PRICE SET voegt je eigen toe. Een model zonder prijs heeft zijn tokens nog steeds geteld, maar zijn kosten worden als nul vastgelegd en een aparte teller toont dat verzoeken ongeprijsd bleven.
Caches verlagen de uitgaven en een budget begrenst wat overblijft. LLMBUDGET.SET definieert een token- en dollarlimiet over een tijdvenster. LLMBUDGET.CONSUME wordt gecontroleerd vóór de modelaanroep, dus een op hol geslagen agent wordt gestopt voordat hij het geld uitgeeft, niet erna. LLMSTATS.RECORD houdt totalen per tenant bij die de cache-read- en cache-writetokens van de provider begrijpen. Alle drie gebruiken één prijstabel wanneer je de modelnaam meegeeft, zodat een besparing, een budget en een dashboardcijfer elkaar niet kunnen tegenspreken.
Fouten waardoor een cache verkeerde antwoorden teruggeeft
De meeste slechte cachehits komen van een sleutel waar iets aan ontbreekt. Zet het model, de promptversie en elke tool- of beleidsversie in de exacte sleutel, zodat een promptwijziging geen antwoorden kan serveren die voor de oude zijn geschreven.
Geef items een levensduur die past bij hoe snel je feiten veranderen. Houd tenants gescheiden met aparte namespaces zodat het antwoord van de ene klant nooit aan een andere wordt aangeboden. Cache nooit een antwoord dat persoonsgegevens bevat, tenzij de sleutel bevat van wie de gegevens zijn.
Meet ten slotte op je eigen verkeer. Onze cijfers komen uit één openbare dataset van korte bankvragen, een fictief beleid en één run per conditie, en ze zijn geen belofte voor jouw workload.
Veelgestelde vragen
Wat is prompt-caching?
Prompt-caching is een functie van de modelprovider die het verwerkte begin van een prompt voor korte tijd bewaart. Een later verzoek dat met exact dezelfde tekst begint, wordt voor dat deel tegen een lager tarief gefactureerd. Het model draait nog steeds en produceert een nieuw antwoord, dus je betaalt nog steeds voor uitvoertokens.
Is prompt-caching hetzelfde als semantische cache?
Nee. Prompt-caching hergebruikt een herhaald promptvoorvoegsel en roept het model nog steeds aan. Semantische cache geeft een opgeslagen antwoord terug op een vraag met vergelijkbare betekenis en slaat de modelaanroep over. Ze pakken verschillende kosten aan en kunnen samen worden gebruikt.
Verlaagt prompt-caching de kosten van uitvoertokens?
Nee. Het verlaagt alleen de prijs van het lezen van het gecachete voorvoegsel. In onze benchmark was uitvoer 6% tot 9% van de tokens maar 73% tot 92% van de basiskosten met prompt-caching al aan, en daarom bespaarde het cachen van hele antwoorden veel meer.
Hoe lang duurt de prompt-cache van Anthropic?
De standaard is vijf minuten, ververst telkens wanneer het item wordt gebruikt. Een optie van een uur is beschikbaar tegen een hogere schrijfprijs. Controleer de actuele documentatie, want limieten en prijzen veranderen.
Kan ik prompt-caching en semantische cache samen gebruiken?
Ja, en onze benchmark deed precies dat. Prompt-caching van de provider bleef in beide runs aan, en de semantische en exacte lagen stonden voor het model. Cachehits slaan de aanroep over, en misses profiteren nog steeds van het voorvoegsel met korting.
Welke gelijkenisdrempel moet een semantische cache gebruiken?
Er is geen universele waarde. Wij kozen 0,81 op een aparte trainsplit, en op Sonnet 5.5 lieten gecachete antwoorden vanaf 0,88 geen kwaliteitstekort zien ten opzichte van verse, met dun bewijs. Begin hoog, beoordeel gecachete antwoorden tegen verse op je eigen vragen en verlaag de drempel alleen als de kwaliteit standhoudt.
Zet het gesprek voort
Reacties
Vragen over de methode? Een ander resultaat op jouw hardware? Deel wat je hebt gevonden. Reacties worden beoordeeld voordat ze verschijnen.