Este benchmark de latência do Redis mede quanto tempo HotKV, Redis, Valkey e Dragonfly levam para responder a uma taxa de requisições fixa. Nossos benchmarks anteriores mediam a vazão, e um leitor observou, com razão, que a vazão não é tudo. Por isso mantivemos a carga constante, aumentamos passo a passo e registramos a mediana (p50) e o percentil 99 (p99) em cada passo. Também medimos o tempo de entrega do pub/sub.
Em resumo. Neste benchmark de latência do Redis na AWS, HotKV e Dragonfly sustentaram 1,6 milhão de GETs por segundo, o Redis com 8 threads de E/S cerca de 0,8 milhão, o Valkey com 8 threads de E/S cerca de 0,4 milhão, e Redis e Valkey com uma thread cerca de 0,2 milhão. De 200.000 a 1,6 milhão de requisições por segundo, o p99 do HotKV ficou entre 0,59 e 0,76 ms, contra 0,71 a 1,48 ms do Dragonfly. Com carga leve, os produtos multithread empataram no p99, e a entrega de pub/sub também foi um empate.
Por que fizemos um benchmark de latência do Redis com taxa fixa
Um teste de vazão leva o servidor ao máximo e informa quanto ele atendeu. Isso diz pouco sobre quanto uma requisição espera. Um teste de latência fixa quantas requisições por segundo os clientes enviam e mede o tempo de cada uma. O servidor fica então sob a mesma carga que qualquer outro produto, e os tempos podem ser comparados.
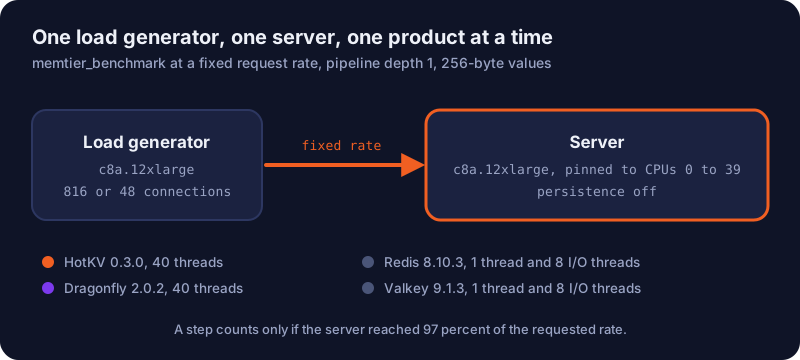
Esse tipo de teste tem uma armadilha. O memtier_benchmark é uma ferramenta de laço fechado, então um cliente espera a resposta antes de enviar a próxima requisição. Se um servidor não acompanha, o cliente simplesmente envia menos requisições, e a latência das que enviou parece melhor do que é. Por isso só contamos um passo como sustentado quando a taxa alcançada é de pelo menos 97 por cento da taxa pedida. Os passos que falham nesse teste aparecem como «NS» (não sustentado) nas tabelas e sua latência não é mostrada.
O que testamos
Máquinas
- Servidores e gerador de carga. Instâncias
c8a.12xlarge(AMD EPYC 9R45, 48 núcleos, sem SMT, 96 GiB, rede de 22,5 Gbit/s) em um grupo de posicionamento de cluster da AWS em eu-south-2a, com Ubuntu 24.04. Uma instância executou o gerador de carga e outra o servidor. - Um produto de cada vez. Cada produto rodou sozinho no servidor, de modo que nada se sobrepôs e nada compartilhou a rede. Cada processo do servidor foi fixado nas CPUs 0 a 39, com persistência e modo protegido desativados.
Produtos
- HotKV 0.3.0 com 40 threads.
- Dragonfly 2.0.2 com 40 threads proactor.
- Redis 8.10.3 e Valkey 9.1.3, cada um executado duas vezes, uma na configuração padrão de uma thread e outra com
--io-threads 8.
A linha de inicialização e a saída ao vivo de CONFIG GET de cada execução ficam guardadas com seus resultados.
Carga e procedimento
O conjunto de dados tinha 1.000.000 de chaves com valores de 256 bytes, e a profundidade de pipeline era 1, então cada requisição espera sua própria resposta. A carga foi só GET e uma mistura de 1 escrita para 10 leituras. Cada passo durou 20 segundos, duas vezes, e informamos a média das duas execuções. O memtier_benchmark usou um limite de taxa por conexão e registrou um histograma HDR. Testamos dois números de conexões.
- 816 conexões (24 threads de 34 conexões), para taxas de 20.000 a 2,4 milhões de requisições por segundo.
- 48 conexões (4 threads de 12 conexões), para taxas de até 300.000 requisições por segundo. Acima disso, 48 conexões não conseguem atingir a taxa, porque cada conexão só envia tão rápido quanto recebe respostas.
Resultados
Primeiro vêm as tabelas de GET, uma para cada número de conexões, e depois o pub/sub.
Com 816 conexões
Cada célula mostra p50 / p99 em milissegundos, para GET. «NS» significa não sustentado, e entre parênteses está a taxa que foi de fato atingida. Um traço significa que a varredura desse produto já havia parado.
| Requisições/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 threads de E/S | Valkey 1 thread | Valkey 8 threads de E/S |
|---|---|---|---|---|---|---|
| 19.584 | 0,38 / 1,81 | 0,48 / 1,90 | 1,63 / 5,29 | 0,68 / 2,07 | 1,59 / 5,13 | 0,76 / 2,63 |
| 99.552 | 0,24 / 0,76 | 0,27 / 1,76 | 2,60 / 5,12 | 0,40 / 0,98 | 2,65 / 5,13 | 1,71 / 3,19 |
| 199.920 | 0,25 / 0,59 | 0,25 / 1,34 | 2,91 / 5,60 | 0,55 / 1,11 | 3,02 / 5,81 | 1,11 / 2,15 |
| 399.840 | 0,27 / 0,63 | 0,27 / 1,48 | NS (258k) | 0,62 / 1,23 | NS (259k) | 1,24 / 1,49 |
| 799.680 | 0,28 / 0,75 | 0,28 / 1,26 | - | 0,68 / 1,18 | - | NS (670k) |
| 1.199.520 | 0,28 / 0,67 | 0,28 / 1,05 | - | NS (1.078k) | - | - |
| 1.599.360 | 0,28 / 0,64 | 0,28 / 0,71 | - | - | - | - |
| 2.399.856 | NS (2.284k) | NS (2.281k) | - | - | - | - |
A carga mista deu o mesmo quadro. O p99 do HotKV ficou entre 0,54 e 0,75 ms de 200.000 a 1,6 milhão de requisições por segundo, e os pontos que cada produto conseguiu sustentar foram os mesmos do GET. Tudo está na pasta de resultados.
Como ler as linhas de uma thread
As medianas de 1,6 a 3 ms de Redis e Valkey com uma thread e 816 conexões não são a latência deles em regime estável. Com um limite de taxa, o memtier_benchmark faz as 816 conexões dispararem no mesmo instante. Um servidor de uma thread precisa processar essa rajada de 816 requisições uma após a outra, então a mediana de uma requisição inclui seu lugar na fila. Fizemos o teste com 48 conexões abaixo para remover esse efeito.
Com 48 conexões
As células têm o mesmo significado de antes, só para GET.
| Requisições/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 threads de E/S | Valkey 1 thread | Valkey 8 threads de E/S |
|---|---|---|---|---|---|---|
| 9.984 | 0,14 / 0,54 | 0,14 / 0,37 | 0,21 / 0,89 | 0,17 / 0,92 | 0,21 / 0,91 | 0,20 / 0,81 |
| 49.968 | 0,10 / 0,28 | 0,11 / 0,28 | 0,21 / 0,41 | 0,13 / 0,28 | 0,21 / 0,43 | 0,21 / 0,44 |
| 99.984 | 0,09 / 0,28 | 0,10 / 0,28 | 0,20 / 0,40 | 0,13 / 0,28 | 0,20 / 0,38 | 0,19 / 0,35 |
| 199.968 | 0,08 / 0,27 | 0,08 / 0,27 | 0,20 / 0,35 | 0,10 / 0,27 | 0,21 / 0,36 | 0,11 / 0,28 |
| 300.000 | 0,08 / 0,27 | 0,08 / 0,27 | NS (231k) | 0,09 / 0,26 | NS (233k) | 0,09 / 0,26 |
Tempo de entrega do pub/sub
Medimos o tempo entre a publicação e a entrega a um assinante, com 64 publicadores, 100 assinantes e carga de 128 bytes, usando o pubsub-sub-bench. Cada mensagem foi para um assinante. As células mostram p50 / p99 em milissegundos.
| Entregas/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 threads de E/S | Valkey 1 thread | Valkey 8 threads de E/S |
|---|---|---|---|---|---|---|
| cerca de 21.000 | 0,10 / 0,71 | 0,10 / 0,65 | 0,11 / 0,74 | 0,11 / 0,62 | 0,11 / 0,76 | 0,12 / 0,78 |
| cerca de 107.000 | 0,10 / 1,02 | 0,12 / 0,92 | 0,10 / 0,80 | 0,11 / 0,63 | 0,10 / 0,82 | 0,10 / 0,86 |
| cerca de 215.000 | 0,11 / 1,20 | 0,13 / 1,13 | 0,51 / 1,03 | 0,20 / 0,73 | 0,57 / 1,07 | 0,12 / 1,22 |
Todos os produtos entregaram na mesma faixa. Na carga mais alta, os produtos de uma thread tiveram mediana maior, 0,51 e 0,57 ms contra 0,11 ms do HotKV.
Também tivemos de corrigir o pubsub-sub-bench. Ele comparava um tempo de publicação em milissegundos com um tempo de recebimento em microssegundos. O patch está na pasta de resultados.
O que os resultados mostram
As tabelas mostram uma vantagem do HotKV e do Dragonfly com carga alta, um empate com carga leve e um teto para Redis e Valkey com uma thread.
HotKV e Dragonfly mantiveram uma cauda baixa até 1,6 milhão de requisições por segundo
Ambos sustentaram 1,6 milhão de GETs por segundo com 816 conexões, com mediana de 0,28 ms. O p99 do HotKV ficou entre 0,59 e 0,76 ms a partir de 200.000 requisições por segundo. O do Dragonfly ficou entre 0,71 e 1,48 ms, e com 1,6 milhão os dois ficaram próximos (0,64 contra 0,71 ms). Redis e Valkey com threads de E/S deixaram de sustentar a taxa em cargas menores, e Redis e Valkey com uma thread, em cerca de 260.000.
Com carga leve, os produtos multithread empatam
Com 48 conexões, até 300.000 requisições por segundo, HotKV, Dragonfly e Redis com 8 threads de E/S tiveram todos um p99 de cerca de 0,27 ms. O HotKV teve a menor mediana, de 0,08 a 0,09 ms a partir de 100.000 requisições por segundo, com o Dragonfly entre 0,08 e 0,10 ms. Uma diferença de 0,01 ms está dentro do que outras partes da configuração podem causar, então não a apresentamos como vitória.
Redis e Valkey com uma thread chegaram ao limite em cerca de 230.000 por segundo
Com 48 conexões, tiveram mediana de cerca de 0,2 ms e p99 de 0,35 a 0,43 ms, e não sustentaram 300.000 requisições por segundo (cerca de 231.000 e 233.000). Esse é o teto de uma thread neste hardware e nesta carga. É por isso que Redis e Valkey costumam ser executados como muitos processos ou como cluster, como no nosso benchmark de cluster.
Limitações
São medições da HotKV Ltd das versões e da configuração acima. Não são uma afirmação sobre outra versão, configuração ou carga desses produtos.
A configuração do teste
- Um servidor, um gerador de carga. Duas repetições por passo, em um conjunto de máquinas em uma data. Não medimos a variação entre máquinas ou dias.
- Configurações que escolhemos. Redis e Valkey rodaram na configuração padrão de uma thread e com
--io-threads 8, e não ajustamos nenhum dos dois além disso. Outras configurações poderiam mudar os números. Se você acha que alguma configuração aqui prejudica um produto, avise-nos e vamos verificar e publicar o resultado. - O efeito de rajada da ferramenta. Com 816 conexões, as medianas dos produtos de uma thread estão infladas pela forma como funciona o limite de taxa do
memtier_benchmark, como explicado acima.
O que não foi medido
- Dados. Valores maiores ou desbalanceados, memória por chave e persistência. A persistência estava desativada em todos os servidores.
- Modos. Modo cluster, pub/sub fragmentado, TLS, replicação e failover.
- Fan-out de pub/sub. Uma mensagem para muitos assinantes.
Redis, Valkey e Dragonfly são marcas de seus respectivos proprietários. Eles são citados apenas para identificar o software que medimos, e isso não implica patrocínio, endosso nem afiliação.
Reproduza
Os scripts de varredura, a linha de inicialização e a configuração ao vivo de cada servidor, o patch do pubsub-sub-bench e todos os resultados brutos estão no repositório de benchmarks. O script de latência é harness/lat_sweep.sh e o de pub/sub é harness/ps_sweep.sh. A pasta raw contém um arquivo por teste com o JSON do memtier_benchmark, os histogramas HDR e o uso de CPU do servidor de cada execução.
Experimente você mesmo
O HotKV Cloud executa o HotKV para você. Comece no HotKV Cloud ou fale com as vendas para comparar o HotKV com a sua própria carga.
Perguntas frequentes
O HotKV é mais rápido que o Redis em latência?
Sob carga, nas taxas que testamos, sim. Com 816 conexões e 200.000 requisições por segundo, o HotKV teve p99 de 0,59 ms, o Redis com 8 threads de E/S 1,11 ms e o Redis com uma thread 5,60 ms. Com carga leve e 48 conexões, os produtos multithread empataram no p99, em cerca de 0,27 ms.
Por que vocês mantiveram a taxa de requisições fixa?
Com taxa fixa, todo produto carrega a mesma carga, então as latências podem ser comparadas. Um teste de vazão mostra quanto um servidor atende no limite, o que diz pouco sobre quanto uma requisição espera.
O que significa «não sustentado»?
O produto atingiu menos de 97 por cento da taxa de requisições pedida. O memtier_benchmark é uma ferramenta de laço fechado, então um servidor sobrecarregado faz os clientes enviarem menos, e a latência das requisições restantes parece melhor do que é. Não mostramos latência para esses passos.
Como foi o tempo de entrega do pub/sub?
Nas três cargas que testamos, todos os produtos entregaram na mesma faixa, com mediana de cerca de 0,1 ms nas duas cargas mais baixas. A tabela acima tem todos os números.
Posso reproduzir este benchmark de latência do Redis?
Sim. Os scripts, as configurações e todos os resultados brutos estão no repositório de benchmarks. Você precisa de dois servidores na mesma rede, um gerador de carga e os quatro produtos.
Continue a conversa
Comentários
Dúvidas sobre o método? Um resultado diferente no seu hardware? Compartilhe o que você encontrou. Os comentários são revisados antes de aparecer.