
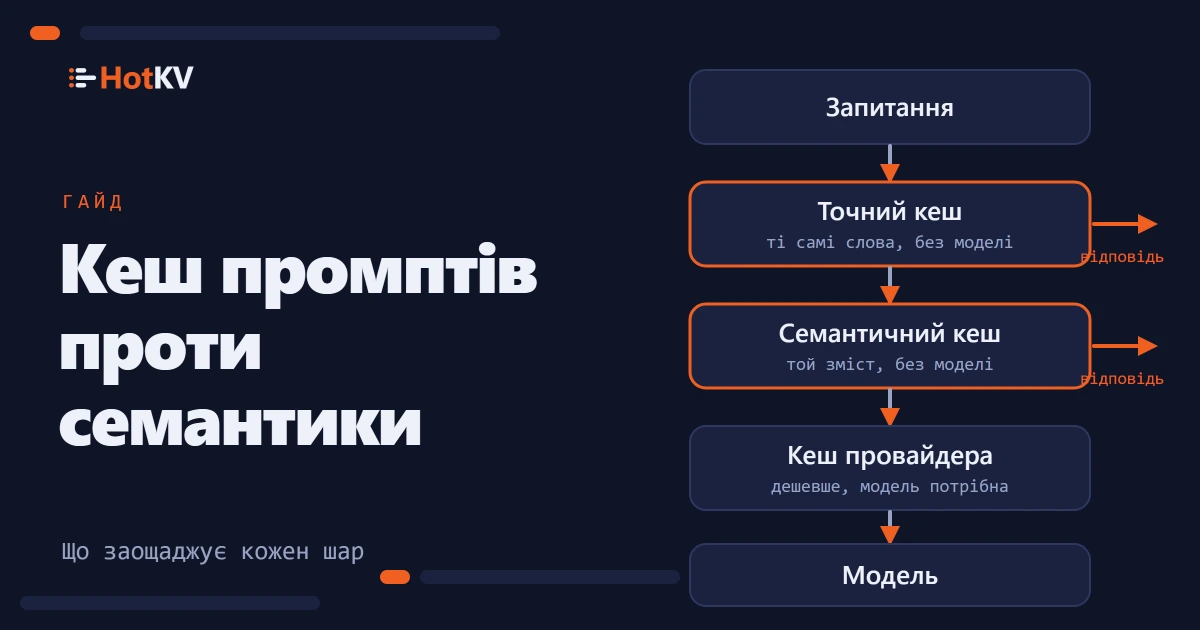
Під назвою кешування для мовних моделей продають дві різні речі, і команди регулярно купують одну, очікуючи іншу. Кешування промптів це функція провайдера, що здешевлює читання повторюваного префікса промпту. Семантичне кешування це шар, який ви запускаєте самі, що відповідає на запитання з пам'яті, тож модель не викликається взагалі. Вони розв'язують різні половини рахунку й найкраще працюють разом.
Коротко. Кешування промптів дає знижку на повторюваний початок промпту, як-от довгий системний промпт, але модель усе одно виконується, і ви все одно платите за кожен вихідний токен. Точне й семантичне кешування повністю прибирають виклик, коли на запитання вже відповідали. У нашому бенчмарку з 3 000 запитів, коли кешування промптів провайдера вже було ввімкнено, додавання HotKV перед моделлю скоротило виклики моделі, токени й вартість приблизно на 70%, бо вихідні токени все одно становили від 73% до 92% базової вартості.
Як працює кешування промптів
Кешування промптів живе в провайдера моделі. Ви позначаєте стабільний початок запиту, зазвичай інструменти й системний промпт, і провайдер на короткий час зберігає його оброблену форму. Наступний запит, що починається з ідентичного тексту, тарифікується за зниженою ставкою за цю частину. Тут ми описуємо версію Anthropic, бо саме її ми вимірювали. Подробиці нижче походять з її документації щодо кешування промптів, перевіреної 18 жовтня 2026 року.
Що кешується
Для влучання потрібен точний збіг. Кожен блок до позначеного вами через cache_control включно має бути ідентичним, у порядку інструменти, системний промпт, потім повідомлення. Змініть один символ на початку промпту, і все після нього буде промахом. Саме запитання йде останнім, тож воно ніколи не входить у кешований префікс.
Промпти коротші за мінімальну довжину не кешуються, і помилка не повертається. Для актуальних моделей Claude, які ми використовували, Fable 5.1, Opus 5.5, Sonnet 5.5 і Haiku 5.5, задокументований мінімум становить 512 токенів. Записи кешу ізольовані для кожної організації, а в Claude API для кожного робочого простору.
Скільки це коштує
Типовий строк життя становить п'ять хвилин, і кожне використання запису продовжує його без додаткової плати. Доступний також строк в одну годину. Запис коштує 1,25 базової вхідної ціни на п'ять хвилин і 2 базові на одну годину. Читання коштує 0,1 базової вхідної ціни на більшості моделей, 0,05 на Opus 5.5 і Sonnet 5.5 та 0,025 на Fable 5.1, згідно зі сторінкою цін. Ці множники змінюються, тож прочитайте актуальну сторінку, перш ніж робити будь-які розрахунки.
Чого кешування промптів не може прибрати
Кешування промптів дає знижку на читання префікса. Воно не пропускає модель. Кожен запит усе одно створює свіжу відповідь, ви все одно на неї чекаєте, а кожен вихідний токен тарифікується за повною вихідною ціною.
Наш бенчмарк показує, наскільки це важливо. Ми надіслали 3 000 запитань клієнтської підтримки кожній із чотирьох моделей Claude, з політикою на 2 200 токенів як системним промптом і ввімкненим кешуванням провайдера. Від 90% до 93% підрахованих токенів були читаннями цієї політики з кешу. Вивід становив лише від 6% до 9% токенів, але від 73% до 92% базової вартості. Префікс уже був дешевим, тож решта витрат припадала на відповіді.
Саме цю прогалину заповнюють інші шари. Повний метод і результати є в бенчмарку економії токенів.
Точне й семантичне кешування відповідей
Два шари відповідають на запит з пам'яті. Вони відрізняються тим, як вирішують, що новий запит збігається зі старим.
Точне кешування відповідей
Точний кеш зберігає остаточну відповідь під ключем, побудованим з усього, що її формує. Зазвичай це модель, версія промпту й нормалізоване запитання. Коли той самий запит надходить знову, повертається збережена відповідь, а модель не викликається. Немає оцінки подібності й немає ризику повернути відповідь, призначену для іншого запитання.
У нашому запуску точний кеш відповів приблизно на 39% запитів. Повторне запитання поверталося за медіанних приблизно 0,05 мс. Це вимірювали клієнтом Python через loopback на тій самій машині, тож сприймайте це як локальну цифру, а не мережеву. Бенчмарк використовував для цього шару звичайні GET і SET. HotKV Enterprise також має окремий кеш промптів із точним збігом, PCACHE.*, з лімітами на простір імен та обліком вартості.
Точне кешування сліпе до формулювання. «How do I reset my password?» і «I forgot my password» це два різні ключі.
Семантичне кешування
Семантичний кеш шукає за змістом запитання. Він перетворює запитання на ембединг, знаходить найближче збережене запитання й повертає його відповідь, якщо косинусна подібність перевищує поріг. У HotKV це SCACHE.*, збудований на тому самому векторному індексі, що й векторний пошук.
Близько 31% наших запитів було оброблено так. Перефразування займало медіанні приблизно 130 мс, майже все це був виклик сервісу ембедингів, тож семантичне влучання набагато швидше за виклик моделі, але не миттєве. Без семантичного шару самому точному кешу знадобилося б щонайбільше 1 264 викликів моделі з 3 000, тобто приблизно на 58% менше. Семантичний шар довів економію приблизно до 70%.
Саме тут і живе ризик. Схоже запитання не завжди те саме запитання. Ми попросили другу модель Claude оцінити кожне семантичне влучання порівняно зі свіжою відповіддю. За нашого типового порога 0,81 кешовані відповіді підходили до точного запитання на 5,8-10,7 відсоткових пункту рідше, ніж свіжі. На Sonnet 5.5 пороги 0,88 і вище не показали такого дефіциту, але доказів мало. Запитання, написані так, щоб відрізнятися однією вирішальною деталлю, усе одно збігалися в 62% випадків за 0,81 і в 10% за 0,95.
Кешування промптів і семантичне кешування поруч
| Кешування промптів провайдера | Точний кеш відповідей | Семантичний кеш | |
|---|---|---|---|
| Що він прибирає | Частину вхідної ціни | Увесь виклик моделі | Увесь виклик моделі |
| Правило збігу | Ідентичний префікс | Ідентичний запит | Схожий зміст вище порога |
| Вихідні токени тарифікуються | Так, щоразу | Ні, при влучанні | Ні, при влучанні |
| Ризик неправильної відповіді | Жодного | Жодного для ідентичних запитів | Реальний, налаштовується порогом |
| Де працює | У провайдера | У вашому кеші | У вашому кеші, плюс виклик ембедингу |
| Частка запитів у нашому запуску | Завжди ввімкнено | Близько 39% | Близько 31% |
Кешування промптів провайдера й кешування відповідей не є альтернативами. Одне знижує ціну викликів, які ви все одно робите, а інше знижує кількість викликів.
Що кешування робить із затримкою
Пропуск моделі змінює не лише вартість, а й швидкість надходження відповідей. У нашому запуску медіанний час до повної відповіді впав з 2,7 секунди до 127 мс на Fable 5.1, з 2,9 секунди до 126 мс на Opus 5.5, з 1,8 секунди до 128 мс на Sonnet 5.5 і з 1,4 секунди до 125 мс на Haiku 5.5. Це в 11-23 раза швидше за медіаною.
Повільний кінець майже не зрушив. Близько 30% запитів усе одно доходили до моделі, а 99-й перцентиль на Fable 5.1 становив близько 6,4 секунди з HotKV проти 6,6 секунди без нього. Кеш прибирає очікування для запитів, на які відповідає, і нічого не дає для тих, які пропускає. Якщо ваша скарга стосується повільного найгіршого випадку, а не повільного типового, самого кешування не вистачить.
Це час до повної відповіді, бо виклики не були потоковими. Потокова відповідь показує перші слова раніше. Розрив у вікні чату менший за розрив у цих числах.
Вибір шару для вашого трафіку
Правильний шар залежить від того, як повторюються ваші запити, і це можна виміряти, перш ніж щось будувати.
Підберіть шар до трафіку
Підберіть шар до того, як повторюються ваші запити.
- Довгий стабільний системний промпт або список інструментів: використовуйте кешування промптів провайдера. Його дешево ввімкнути, і воно не змінює відповідей.
- Те саме запитання тими самими словами, як-от кнопка, шаблон чи повторна спроба: використовуйте точний кеш відповідей. Він безпечний і швидкий.
- Трафік підтримки, пошуку та FAQ, де люди питають те саме різними словами: додайте семантичний кеш, задайте високий поріг і перевірте якість відповідей на власних запитаннях, перш ніж йому довіряти.
- Відповіді, що залежать від користувача, годинника чи живих даних: не кешуйте жодну з них або будуйте ключ кешу з фактів, що змінюють відповідь.
Економія слідує за повторюваністю. Коли ми зробили кожен намір однаково ймовірним замість перекошеного розподілу, вартість впала на 56% на двох моделях, які ми запустили заново, а з 3 000 цілком різних запитань вона впала на 38%. Навантаження без повторних чи схожих запитань нічого не заощаджує.
Спершу виміряйте власну повторюваність
Перш ніж щось будувати, з'ясуйте, яка частина вашого трафіку повторюється. Це число визначає, чи варто мати точний кеш. Це займає десять хвилин з запитаннями, які ви вже логуєте. Нормалізуйте кожне запитання так, як це робитиме ваш ключ кешу, порахуйте різні й подивіться, яка частина трафіку була повтором.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share це частка запитів, на які відповів би точний кеш, коли побачив кожне запитання вперше. Наш тестовий набір мав 1 264 різні запитання серед 3 000 запитів, тож цифра становила близько 58%. Якщо у вас виходить близько 5%, точний кеш мало допоможе, і лише семантичний шар може допомогти.
Діють два застереження. Кеш починається порожнім, тож перші запити завжди доходять до моделі. У нашому запуску близько 52% перших тисячі запитів було обслужено з кешу і близько 81% останньої тисячі. І журнал трафіку минулого місяця розповідає про минулий місяць. Якщо ви збираєтеся запустити функцію, що змінює, про що питають люди, сприймайте цифру як приблизний орієнтир.
Поєднання шарів
Запит має проходити шарами від найдешевшого й найбезпечнішого до найдорожчого, і ви маєте бачити, що заощадив кожен.
Порядок пошуку
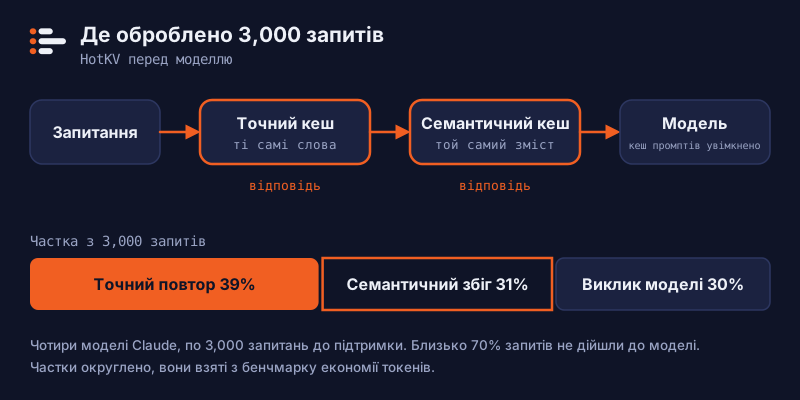
Порядок має значення. Спершу перевіряйте найдешевший і найбезпечніший шар і викликайте модель, лише коли всюди промах. Цей ескіз припускає клієнт у стилі redis-py з decode_responses=True, два попередньо створені простори імен і ваші власні функції embed та llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # ті самі слова

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # той самий зміст

    reply = llm.complete(question)                   # тут діє кешування промптів провайдера
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Створіть простори імен один раз командами PCACHE.CREATE answers_exact і SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, використовуючи розмірність вашої моделі ембедингів. Набір команд ШІ входить до екземплярів HotKV Cloud Performance і Scale, а сторінка ШІ перелічує, що робить кожен рушій. Сторінка цін показує, який план що містить.
Ведення обліку у продакшені
Кеш, якого ви не бачите, це кеш, якому ви не можете довіряти. HotKV веде лічильники влучань і промахів для кожного простору імен. Якщо ви зберігаєте використання токенів початкового виклику разом із кожним записом, він також може приписати токени та вартість, яких уникнув кожне наступне влучання. Відповіді PCACHE.STATS і SCACHE.STATS тоді містять поля на кшталт usage_saved_requests, usage_saved_input_tokens і usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Замініть <model> на id вашої моделі. INPUT рахує некешовані токени промпту, а CACHEREAD токени, які провайдер віддав зі свого кешу, тож вони не перекриваються. Модель має бути в таблиці цін HotKV, щоб поле вартості щось означало. LLMSTATS.PRICE LIST показує, які моделі відомі, а LLMSTATS.PRICE SET додає ваші власні. Модель без ціни все одно має підраховані токени, але її вартість записується як нуль, а окремий лічильник показує, що запити лишилися без ціни.
Кеші скорочують витрати, а бюджет обмежує те, що лишається. LLMBUDGET.SET визначає ліміт токенів і доларів на часовий проміжок. LLMBUDGET.CONSUME перевіряється перед викликом моделі, тож агента, що вийшов з-під контролю, зупиняють до того, як він витратить гроші, а не після. LLMSTATS.RECORD веде підсумки для кожного тенанта, що розуміють токени читання й запису кешу провайдера. Усі три використовують одну таблицю цін, коли ви передаєте назву моделі, тож заощадження, бюджет і цифра на дашборді не можуть розходитися.
Помилки, через які кеш повертає неправильні відповіді
Більшість поганих влучань походить від ключа, у якому чогось бракує. Покладіть у точний ключ модель, версію промпту й будь-яку версію інструмента чи політики, щоб зміна промпту не могла віддавати відповіді, написані для старого.
Задайте записам строк життя, що відповідає швидкості зміни ваших фактів. Тримайте тенантів окремо за допомогою окремих просторів імен, щоб відповідь одного клієнта ніколи не пропонувалася іншому. Ніколи не кешуйте відповідь, що містить персональні дані, якщо ключ не включає, чиї це дані.
Нарешті, вимірюйте на власному трафіку. Наші цифри походять з одного публічного набору коротких банківських запитань, вигаданої політики та одного запуску на умову, і вони не є обіцянкою для вашого навантаження.
Поширені запитання
Що таке кешування промптів?
Кешування промптів це функція провайдера моделі, що на короткий час зберігає оброблений початок промпту. Пізніший запит, що починається з точно такого самого тексту, тарифікується за нижчою ставкою за цю частину. Модель усе одно виконується й створює нову відповідь, тож ви все одно платите за вихідні токени.
Чи є кешування промптів тим самим, що семантичне кешування?
Ні. Кешування промптів повторно використовує повторюваний префікс промпту й усе одно викликає модель. Семантичне кешування повертає збережену відповідь на запитання зі схожим змістом і пропускає виклик моделі. Вони стосуються різних витрат і можуть використовуватися разом.
Чи знижує кешування промптів витрати на вихідні токени?
Ні. Воно лише знижує ціну читання кешованого префікса. У нашому бенчмарку вивід становив від 6% до 9% токенів, але від 73% до 92% базової вартості при вже ввімкненому кешуванні промптів, тому кешування цілих відповідей заощадило набагато більше.
Як довго живе кеш промптів Anthropic?
Типово п'ять хвилин, і він оновлюється при кожному використанні запису. Доступний варіант на одну годину з вищою ціною запису. Перевіряйте актуальну документацію, бо ліміти й ціни змінюються.
Чи можна використовувати кешування промптів і семантичне кешування разом?
Так, і наш бенчмарк робив саме це. Кешування промптів провайдера лишалося ввімкненим в обох запусках, а семантичний і точний шари стояли перед моделлю. Влучання в кеш пропускають виклик, а промахи все одно користуються зниженою ціною префікса.
Який поріг подібності має використовувати семантичний кеш?
Універсального значення немає. Ми обрали 0,81 на окремій тренувальній вибірці, а на Sonnet 5.5 кешовані відповіді не показали дефіциту якості порівняно зі свіжими від 0,88 і вище, але доказів мало. Починайте з високого, порівнюйте кешовані відповіді зі свіжими на власних запитаннях і знижуйте поріг, лише якщо якість утримується.
Продовжте розмову
Коментарі
Питання щодо методу? Інший результат на вашому обладнанні? Поділіться тим, що ви знайшли. Коментарі проходять модерацію перед публікацією.