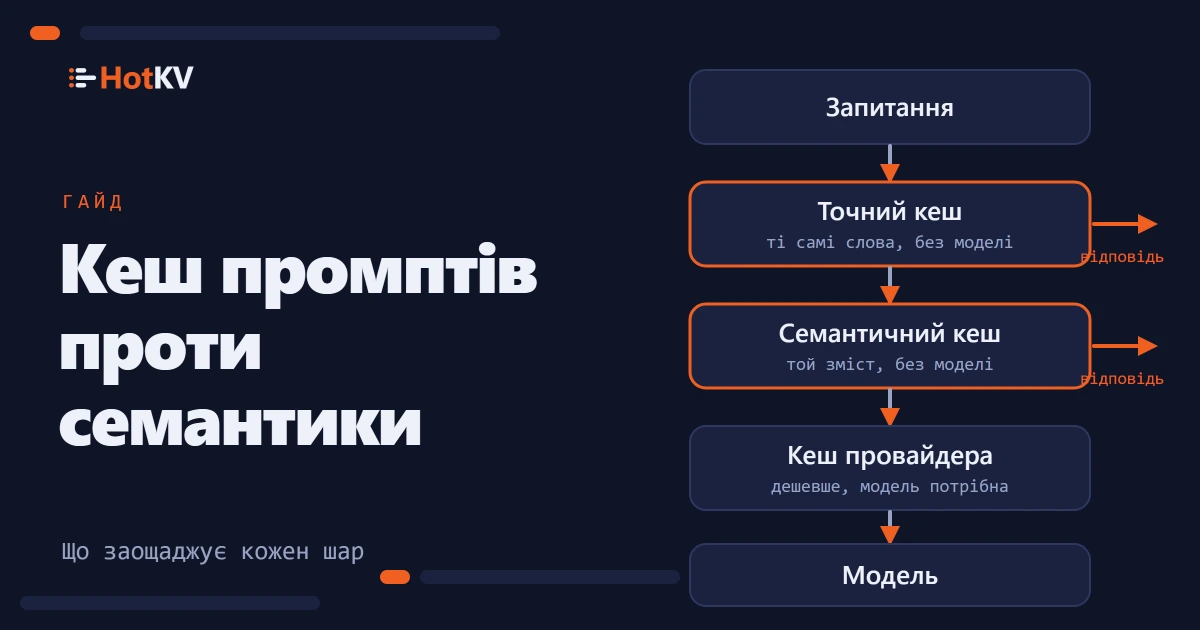
Кешування промптів проти семантичного кешування: що заощаджує кожне
Кешування промптів здешевлює повторюваний префікс. Семантичне кешування прибирає виклик моделі. Як працює кожне, що ми виміряли і що вибрати коли.
Тег
Виміряна вартість API й економія токенів з HotKV: припущення щодо цін, чутливість до навантаження та межі екстраполяції.
2 статті у розділі Оптимізація витрат
Кешування промптів здешевлює повторюваний префікс. Семантичне кешування прибирає виклик моделі. Як працює кожне, що ми виміряли і що вибрати коли.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Слідуйте за своєю цікавістю