
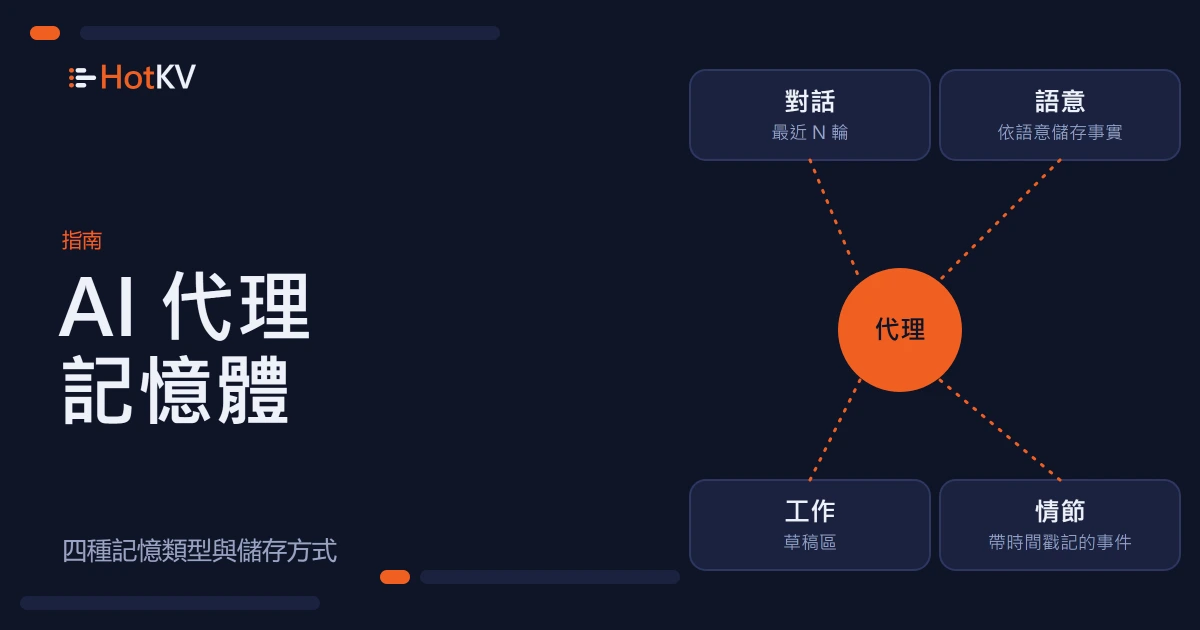
AI 代理記憶體,讓代理能把某些資訊從一個步驟、或一次工作階段,帶到下一個步驟或下一次工作階段。語言模型本身在兩次呼叫之間什麼都記不住。它看起來記得的一切,都是您的程式碼重新放回提示詞裡的。您如何儲存與檢索這些內容,決定了代理能回想起什麼、回想得多快,以及每一輪的成本是多少。
簡而言之。 代理需要四種記憶:簡短的對話視窗、依語意查找的長期事實、用於進行中任務的草稿區,以及記錄已發生之事的日誌。每一種的形態、生命週期與查找方式都不同,因此單一的記憶資料表對哪一種都不太合適。HotKV 以
AMEM.*指令,把這四種都存放在同一個記憶體內引擎中。我們測過的是 HotKV 的快取與向量搜尋,而不是代理記憶體,所以本文只說明設計,不宣稱任何加速效果。
為什麼上下文視窗不是記憶體
上下文視窗就是您隨每個請求送出的文字。它有大小限制,其中的所有內容每一輪您都要按輸入 Token 付費,工作階段一結束它就消失了。它也無法被搜尋。如果代理需要三週前的某一個事實,把整段歷史都貼進去並不是辦法。
記憶體是決定下一步該把什麼放進視窗的那一層。它保留最近幾輪的對話,並找出少數真正重要的較早事實。它保存目前任務的狀態,並記錄代理做過的事。研究人員也用類似的方式描述代理。Sumers、Yao、Narasimhan 與 Griffiths 提出的 CoALA 框架,把工作記憶與長期的情節記憶、語意記憶和程序性記憶區分開來。
AI 代理記憶體的四種類型
HotKV 的四個儲存區涵蓋了大致相同的範圍,只是依應用程式實際要建構的內容做了調整。程序性記憶,也就是保存在代理程式碼與提示詞中的技能與做法,通常放在您的程式碼儲存庫或提示詞登錄庫中,並不是獨立的一種儲存區。
對話記憶體
這是單次工作階段的短期記錄。訊息帶有角色(system、user、assistant 或 tool),存放在有界的滑動視窗中,達到上限後最舊的幾輪就會被丟棄。它回答一個問題:最近說了什麼?在 HotKV 中對應的是 AMEM.CONV.CREATE、AMEM.CONV.APPEND 與 AMEM.CONV.WINDOW。
語意記憶體
語意記憶體是以事實形式保存、並附帶嵌入向量的長期知識。代理依語意而不是依鍵來回想它們。它由 HNSW 向量索引支撐,與驅動向量搜尋的是同一種索引。AMEM.SEM.STORE 儲存一個事實,AMEM.SEM.RECALL 則傳回最匹配的幾項及其相似度分數。文件、使用者偏好與學到的修正,都應該放在這裡。
工作記憶體
工作記憶體是進行中任務的草稿區,是限定在某個工作階段內的一組扁平的鍵值。它保存目前的步驟、正在處理的工單或部分結果。任務結束時它就該消失。AMEM.WORK.SET 接受存活時間 (TTL),正是為了這個原因。
情節記憶體
情節記憶體是附帶時間戳記的事件所組成的僅追加日誌,例如採取過的動作、做出的觀察或得出的決定。它讓代理,或是審查它的人,可以詢問發生了什麼事、是什麼時候發生的。AMEM.EPIS.LOG 寫入一個事件,AMEM.EPIS.QUERY 則依類型與時間範圍把它們讀回來。
實務中的 AI 代理記憶體
實務上有兩件事很重要:如何寫入記憶體,以及每一輪讀回什麼。
用指令儲存記憶
以下是一個處理單次對話的客服代理。其中虛構的政策文字與只有三個數字的向量僅用於示範。真實的嵌入模型會產生 768 或 1,536 個數字的向量,您需要用該維度來建立命名空間。
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
每一輪,代理都會讀取最近的視窗,並回想出與問題匹配的少數事實。它檢查自己的工作筆記,再用這些內容組出提示詞。行動之後,它記錄一個事件。這個迴圈中的任何一步,都不需要完整的歷史。
每一輪讀取記憶
儲存記憶是比較容易的那一半。真正的功夫在於決定要讀回什麼,因為讀回的所有內容都會進入提示詞,並產生輸入 Token 的成本。一個合理的迴圈,會依固定的順序讀取少量內容:先是最近幾輪的對話,然後是與問題匹配的少數事實,最後是任務的狀態。以下是用官方 Python 用戶端寫成的版本,其中的嵌入函式與提示詞範本由您自行提供。
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # 請用您自己的資料來調整

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # 只建立一次,在第一次附加之前

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # 您自己的提示詞範本

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
相似度的下限需要您自行調整。適合某一個嵌入模型與某一組事實的值,對另一組可能就不對,所以請用您已知答案的問題來檢查召回的效果。丟掉較弱的匹配,比看起來更重要,因為提示詞裡放進一個品質差的事實,還不如不放。
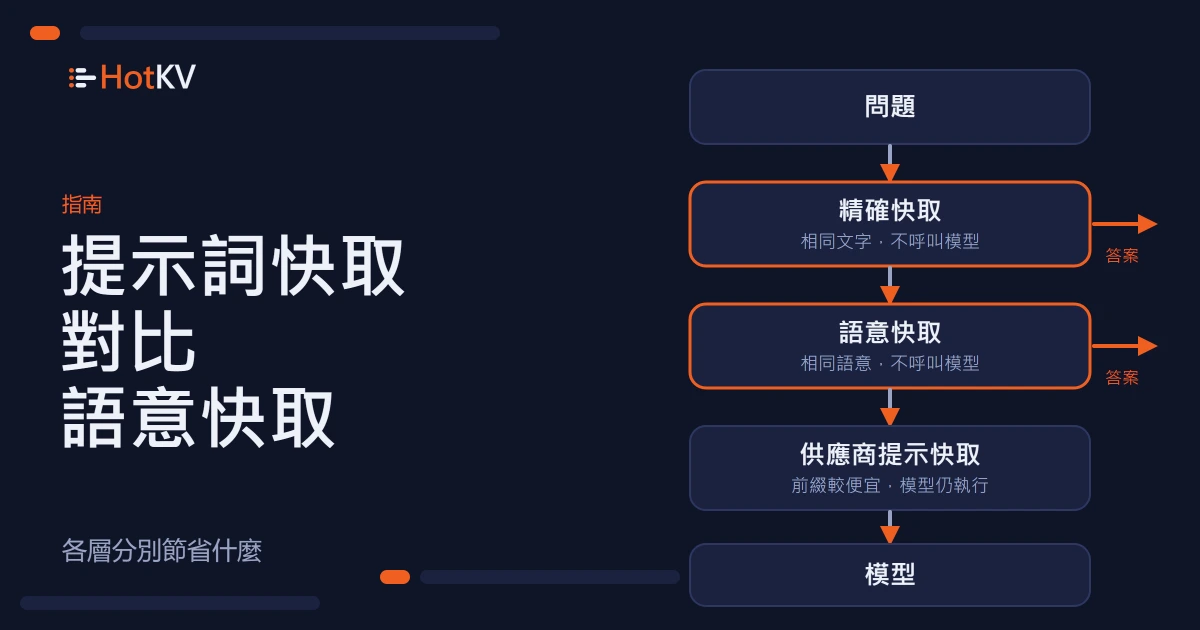
這個提示詞中穩定不變的部分,例如系統指令,也正是供應商端的提示詞快取可以變得更便宜的部分。請把讀到的記憶放在最後、穩定文字之後,這樣記憶的變化就不會讓該快取失效。
用摘要取代越來越長的視窗
視窗會把舊的對話輪次完全丟掉。閒聊時這沒有問題,但對長任務就不好了,因為第 3 輪的內容到第 300 輪時可能仍然重要。常見的辦法是滾動摘要。每經過一段對話,代理或一個更便宜的模型就把學到的內容寫下來,摘要在提示詞中取代舊的對話輪次。
HotKV 透過 AMEM.SUMMARY.SET、AMEM.SUMMARY.APPEND 與 AMEM.SUMMARY.GET,為每個代理保存一份摘要。SET 取代文字,APPEND 附加一行。每次更新都會提高版本號,所以其他元件可以低成本地判斷摘要是否變了、什麼時候變的。
摘要是有損的,對摘要再做摘要,每一次都會丟掉更多。識別碼、金額與日期這類精確的值,請不要寫進文字敘述,而是放在工作記憶或語意事實中,這樣它們才能保留下來。摘要則用來記錄工作的大致輪廓,例如偏好、已做的決定與剩下的事項。
設計規則與保留期
記憶體如果不加限制就會無限成長,所以請在第一次寫入之前就設好上限。
讓記憶保持有用的規則
- 為一切設上限。 為對話設定
WINDOW,為工作階段與工作值設定TTL。對於對話、工作值與事實,HotKV 會為僅追加檔案與複本記錄到期時間,因此已經過期的項目,不會在重新啟動後重播檔案時重新出現。 - 存事實,而不是整段記錄。 寫入語意記憶體之前先做摘要。一個事實比一整頁對話更容易被回想起來。
- 讓各個代理彼此分開。 為每個代理、每個租戶使用獨立的識別碼或命名空間,這樣一位客戶的記憶就永遠不會被回想給另一位客戶。
- 回想少量,而不是大量。 取最匹配的前三到五項,並在它們進入提示詞之前,依相似度分數丟掉較弱的。
- 不要存放機密。 記憶會被讀回提示詞,所以絕不要存放密碼、金鑰,或您不願給模型看的資料。
每種類型保留多久
這些生命週期是我們的建議,不是預設值。請依底層事實變化的快慢,以及您被允許保留什麼,來選擇自己的。
| 記憶體類型 | 建議的生命週期 | HotKV 中的控制方式 |
|---|---|---|
| 對話 | 工作階段期間,或固定的期間,例如一天 | AMEM.CONV.CREATE 上的 WINDOW 與 TTL |
| 工作 | 任務期間,之後清除 | AMEM.WORK.SET 上的 TTL,以及 AMEM.WORK.CLEAR |
| 語意 | 直到該事實不再成立 | AMEM.SEM.STORE 上的 TTL,以及 AMEM.SEM.FORGET |
| 情節 | 只要您的稽核或支援需要就保留 | 依時間範圍的 AMEM.EPIS.QUERY,以及 AMEM.EPIS.CLEAR(事件沒有存活時間) |
保留期也是隱私問題。如果記憶體中保存了任何關於某個人的資訊,您選擇的生命週期就是對他們承諾的一部分,所以請把它寫下來。
代理記憶體是怎麼出問題的
大多數記憶體方面的錯誤都是慢性的。代理一個星期都表現良好,然後開始越來越差。以下是設計時需要防範的故障。
常見的故障
- 過時的事實。 三月還成立的事實,到了十月還被回想出來。請為事實設定存活時間,或以每個實體一個鍵的方式儲存,讓新的值覆寫舊的值。
- 互相矛盾。 兩個儲存的事實彼此衝突,代理隨機挑了一個。與其在舊筆記旁附加新筆記,不如每個鍵只保留一個事實。
- 回想過多。 太多匹配會讓提示詞塞滿關聯不大的文字。請回想少量,並丟掉較弱的匹配。
- 使用者之間外洩。 一位客戶的記憶被回想給另一位客戶。每個租戶都要有獨立的識別碼或命名空間,並在每次讀取之前於程式碼中檢查。
- 無限制成長。 沒有任何東西會過期,於是查找變慢、成本悄悄上升。每種類型都需要生命週期。像情節日誌這種 HotKV 沒有存活時間的地方,請自行安排清除或匯出。
- 摘要漂移。 摘要的摘要會慢慢與實際發生的事不再相符。請把事件日誌當作事實的來源,並由它重新產生摘要。
把儲存的文字視為不可信
最後一點值得多加留意。代理寫入記憶體的任何內容,之後都可能被讀進提示詞,包括來自網頁、電子郵件或使用者的文字。這就是 OWASP 列為 LLM01 的間接提示詞注入。請為每個事實記錄來源。對由外部內容寫入的記憶要降低信任,並且絕不要讓被回想出的筆記凌駕於您的系統提示詞之上。
我們測量了什麼,沒有測量什麼
HotKV 公開的基準測試涵蓋指令吞吐量、向量搜尋,以及回應快取所節省的 Token。代理記憶體目前還沒有自己的基準測試。我們不宣稱它的延遲,也不宣稱它能把代理的品質提升多少。我們能說的是架構上的事:這四個儲存區與快取、向量索引運行在同一個行程中。一次記憶體查找,就是對一套您本來就在維運的系統發出一次呼叫。
Token 節省基準測試,以及提示詞快取與語意快取的比較,呈現了實測的那一面。代理記憶體的使用情境則在完整的情境中展示這些指令。
在 Claude Code 或 Cursor 中使用代理記憶體
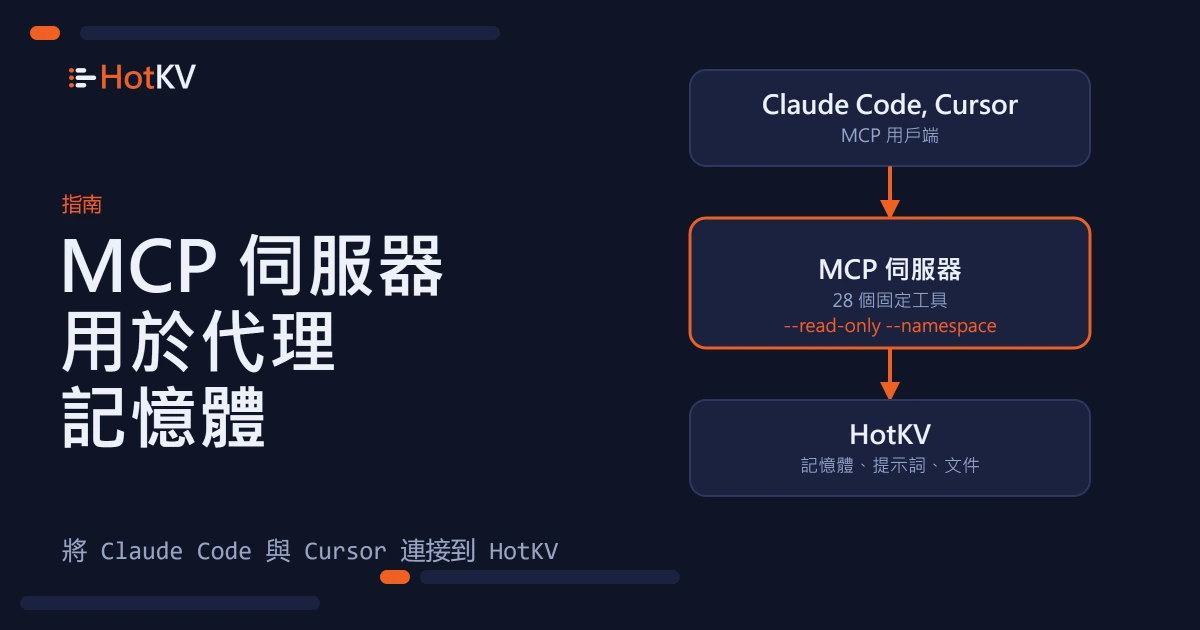
支援 Model Context Protocol 的助理,不需要自訂程式碼就能使用其中一部分記憶體。開源的 hotkv-mcp 伺服器,把對話記憶體、工作筆記、事件日誌與滾動摘要作為工具提供出來。它有唯讀模式,還有可將代理限制在其中的命名空間。它不提供語意記憶體,其工具也無法設定視窗或存活時間,這些請使用用戶端函式庫。下一篇文章適用於代理記憶體的 MCP 伺服器會說明如何連接它,以及它的安全措施涵蓋什麼。
常見問題
什麼是 AI 代理記憶體?
AI 代理記憶體是讓代理能跨步驟、跨工作階段保留資訊的儲存與檢索層。它通常結合了最近的對話視窗、依語意查找的長期事實、目前任務的草稿區,以及事件日誌。
短期與長期代理記憶體有什麼差別?
短期記憶體保存現在正在發生的事,例如最近幾輪對話與任務狀態,有界且是暫時的。長期記憶體保存應該在工作階段之後仍然存在的知識,例如事實、偏好與過去的事件,並在需要時搜尋。
代理記憶體中的滾動摘要是什麼?
滾動摘要是對代理目前為止學到或決定的內容的簡短持續描述,隨著工作進行而更新。它在提示詞中取代舊的對話輪次,讓提示詞不會一直變長。HotKV 為每個代理儲存一份,並在每次更新時提高版本號。
代理記憶體需要向量資料庫嗎?
只有語意記憶體需要,也就是依語意查找事實的那一種。對話視窗、工作狀態與事件日誌不需要向量。HotKV 把這四種都放在同一個引擎中,所以向量索引與其他儲存區並不是各自獨立的系統。
代理記憶體應該保留多久?
這取決於類型。工作記憶體應在任務結束時過期,對話在工作階段結束後或一段設定的期間後過期,情節日誌則只要您的稽核需要就保留。語意記憶體中的事實,應當在不再成立時被審查並移除。
代理記憶體會遭到攻擊嗎?
會。寫入記憶體的文字之後會被讀進提示詞,所以一則被下毒的筆記可以左右代理。請記錄每個事實的來源,降低對外部內容的信任,並讓被回想出的記憶在權威性上低於您的系統提示詞。
HotKV 把代理記憶體存放在 RAM 中嗎?
HotKV 是記憶體內引擎,所以讀取直接從記憶體提供。根據產品文件,對這四個儲存區的寫入會被記錄到僅追加檔案與複本,並一併帶上到期時間。
繼續討論
留言
對方法有疑問嗎?在您的硬體上得到不同的結果嗎?歡迎分享您的發現。留言會先經過審核才會顯示。