
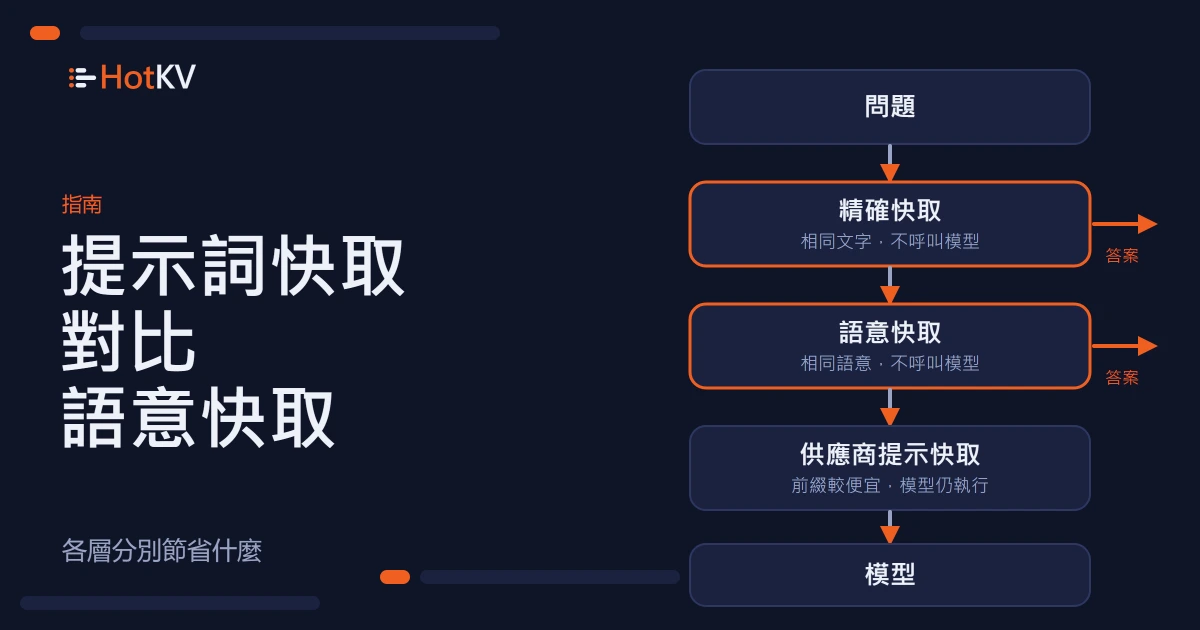
市面上有兩種不同的東西,都被當成語言模型的快取來賣,而團隊常常買了其中一種,卻期待它有另一種的效果。提示詞快取是供應商提供的功能,讓重複的提示詞前綴讀取起來更便宜。語意快取則是您自己運行的一層,直接從記憶體回答問題,完全不呼叫模型。它們解決的是帳單的不同部分,搭配使用的效果最好。
簡而言之。 提示詞快取會為提示詞中重複的開頭部分打折,例如很長的系統提示詞,但模型仍然會執行,您仍然要為每個輸出 Token 付費。精確快取與語意快取則是在問題先前回答過時,完全免去這次呼叫。在我們 3,000 個請求的基準測試中,即使已啟用供應商的提示詞快取,在前面加上 HotKV 之後,模型呼叫、Token 與成本仍減少了約 70%,因為輸出 Token 仍占基準成本的 73% 至 92%。
提示詞快取如何運作
提示詞快取位於模型供應商那一端。您標記請求中穩定的開頭部分,通常是工具與系統提示詞,供應商會將處理後的結果暫存一小段時間。下一個以完全相同的文字開頭的請求,這個部分就會按較低的費率計費。我們在此說明 Anthropic 的版本,因為那是我們測量過的。以下細節取自其提示詞快取文件,於 2026 年 10 月 18 日查證。
哪些內容會被快取
命中需要精確比對。從頭到您以 cache_control 標記的那個區塊為止,每個區塊都必須完全相同,順序依序是工具、系統提示詞,然後是訊息。提示詞前面只要改動一個字元,其後的一切都會未命中。問題本身排在最後,所以永遠不會成為被快取前綴的一部分。
長度低於下限的提示詞不會被快取,也不會傳回錯誤。對於我們使用的現行 Claude 模型,也就是 Fable 5.1、Opus 5.5、Sonnet 5.5 與 Haiku 5.5,文件記載的下限是 512 個 Token。快取項目依組織隔離,在 Claude API 上則依工作區隔離。
成本是多少
預設的存活時間是五分鐘,每次使用該項目都會免費延長。另有一小時的選項。依據價格頁面,寫入一個項目的成本,五分鐘為基本輸入價格的 1.25 倍,一小時為 2 倍。讀取成本在多數模型上為基本輸入價格的 0.1 倍,在 Opus 5.5 與 Sonnet 5.5 上為 0.05 倍,在 Fable 5.1 上為 0.025 倍。這些倍數會變動,所以在做任何計算之前,請先閱讀最新的頁面。
提示詞快取無法省去的部分
提示詞快取是為讀取前綴打折,並不會略過模型。每個請求仍然會產生新的回答,您仍然要等待,而且每個輸出 Token 都按完整的輸出價格計費。
我們的基準測試顯示了這有多重要。我們把 3,000 個客服問題送給四個 Claude 模型,各自以一份 2,200 個 Token 的政策作為系統提示詞,並啟用供應商快取。計入的 Token 中,有 90% 至 93% 是那份政策的快取讀取。輸出只占 Token 的 6% 至 9%,卻占基準成本的 73% 至 92%。前綴本來就已經很便宜,所以剩下的花費都在回答上。
這正是其他層要補上的缺口。完整的方法與結果請見 Token 節省基準測試。
精確與語意的回應快取
有兩層是直接從記憶體回答請求。它們的差別在於判斷新請求是否與舊請求相符的方式。
精確回應快取
精確快取會以由所有影響回答的因素組成的鍵,儲存最終的回答。通常這包含模型、提示詞版本與正規化後的問題。當相同的請求再次到來時,就傳回儲存的回答,不呼叫模型。沒有相似度分數,也不會有把為另一個問題準備的回答傳回來的風險。
在我們的測試中,精確快取回答了約 39% 的請求。重複的問題在中位數約 0.05 ms 內傳回。這是在同一台機器上,以 Python 用戶端透過回送介面測得的,所以請把它視為本機數字,而不是網路數字。基準測試對這一層使用的是普通的 GET 與 SET。HotKV Enterprise 另有專用的精確比對提示詞快取 PCACHE.*,具備依命名空間的上限與成本追蹤。
精確快取對措辭完全無感。「How do I reset my password?」與「I forgot my password」是兩個不同的鍵。
語意快取
語意快取查找的是問題的語意。它把問題轉成嵌入,找出最接近的已儲存問題,若餘弦相似度超過門檻,就傳回它的回答。在 HotKV 中對應的是 SCACHE.*,建立在與向量搜尋相同的向量索引之上。
我們約有 31% 的請求是以這種方式回答的。換句話說的問題,中位數約需 130 ms,其中幾乎全是呼叫嵌入服務的時間,所以語意命中比模型呼叫快得多,但並非瞬間完成。如果沒有語意層,單靠精確快取,3,000 個請求中最多需要 1,264 次模型呼叫,約少了 58%。加上語意層後,節省幅度提高到約 70%。
風險也在這裡。相似的問題不一定是同一個問題。我們請第二個 Claude 模型,針對每個語意命中與全新的回答進行評判。在我們預設的 0.81 門檻下,快取回答符合該問題的頻率,比全新的回答低 5.8 至 10.7 個百分點。在 Sonnet 5.5 上,0.88 以上的門檻沒有出現這樣的落差,但證據不多。刻意設計成只差一個關鍵細節的問題,在 0.81 時仍有 62% 的比對成功率,在 0.95 時則為 10%。
提示詞快取與語意快取並排比較
| 供應商提示詞快取 | 精確回應快取 | 語意快取 | |
|---|---|---|---|
| 省去什麼 | 部分輸入價格 | 整次模型呼叫 | 整次模型呼叫 |
| 比對規則 | 相同的前綴 | 相同的請求 | 語意相似度超過門檻 |
| 是否計收輸出 Token | 是,每次都計 | 否,命中時不計 | 否,命中時不計 |
| 回答錯誤的風險 | 無 | 相同請求不會有 | 確實存在,由門檻調整 |
| 在哪裡運行 | 在供應商端 | 在您的快取中 | 在您的快取中,另加一次嵌入呼叫 |
| 在我們的測試中占請求的比例 | 始終啟用 | 約 39% | 約 31% |
供應商提示詞快取與回應快取並不是互相替代的選項。一個降低您仍會發出的呼叫的價格,另一個則減少您發出呼叫的次數。
快取對延遲的影響
略過模型,改變的不只是成本,還有回答送達的速度。在我們的測試中,取得完整回答的時間中位數,在 Fable 5.1 上從 2.7 秒降到 127 ms,在 Opus 5.5 上從 2.9 秒降到 126 ms,在 Sonnet 5.5 上從 1.8 秒降到 128 ms,在 Haiku 5.5 上從 1.4 秒降到 125 ms。以中位數而言,快了 11 到 23 倍。
慢的那一端幾乎沒有改變。約有 30% 的請求仍然會到達模型,Fable 5.1 的第 99 百分位數在有 HotKV 時約為 6.4 秒,沒有時則為 6.6 秒。快取只會消除它所回答的那些請求的等待,對於它沒命中的請求則毫無幫助。如果您抱怨的是最差情況很慢,而不是一般情況很慢,單靠快取無法解決。
這些是取得完整回答的時間,因為這些呼叫並未使用串流。串流的回答會更早顯示第一批字句。因此在聊天視窗中感受到的差距,會比這些數字小。
為您的流量選擇合適的層
合適的層取決於您的請求如何重複,而這可以在建構任何東西之前先測量。
讓層與流量相符
請讓層與您的請求重複的方式相符。
- 很長且穩定的系統提示詞或工具清單: 使用供應商提示詞快取。開啟的成本很低,也不會改變任何回答。
- 用同樣的字句重複同一個問題,例如按鈕、範本或重試: 使用精確回應快取。安全又快速。
- 人們用不同說法問同一件事的客服、搜尋與常見問題流量: 加上語意快取,把門檻設高,並在信任它之前,用您自己的問題檢查回答品質。
- 取決於使用者、時間或即時資料的回答: 一概不要快取,或讓快取的鍵包含會改變回答的那些事實。
節省的幅度跟著重複程度走。當我們讓每個意圖的出現機率均等,而不是偏斜分布時,在我們重跑的兩個模型上,成本下降了 56%;而在 3,000 個全都不同的問題下,則下降 38%。沒有重複或相似問題的工作負載,不會省到任何東西。
先測量您自己的重複率
在建構任何東西之前,先弄清楚您的流量有多少是重複的。這個數字決定了精確快取是否值得擁有。用您已經記錄的問題,十分鐘就能完成。依照快取鍵的方式將每個問題正規化,計算不重複的問題數,看看有多少流量是重複的。
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share 是精確快取在每個問題都先見過一次之後,本來可以回答的請求比例。我們的測試集在 3,000 個請求中有 1,264 個不重複的問題,所以這個數字約為 58%。如果您的結果接近 5%,精確快取的作用就很有限,只有語意層才能幫上忙。
有兩點需要留意。快取一開始是空的,所以最早的請求一律會到達模型。在我們的測試中,前一千個請求約有 52% 由快取回應,最後一千個則約為 81%。此外,上個月的流量記錄只能告訴您上個月的情形。如果您即將推出會改變人們提問內容的功能,請把這個數字當作粗略的參考。
把各層組合起來
請求應該從最便宜、最安全的層開始,依序通過各層,直到最昂貴的一層,而且您應該能看到每一層節省了多少。
查找順序
順序很重要。先檢查最便宜、最安全的層,只有在全部未命中時才呼叫模型。這段範例假設使用 redis-py 風格的用戶端並設定 decode_responses=True、事先建立好兩個命名空間,以及您自己的 embed 與 llm 函式。
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # 字句相同

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # 語意相同

    reply = llm.complete(question)                   # 供應商的提示詞快取在這裡發揮作用
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
請以您的嵌入模型的維度,用 PCACHE.CREATE answers_exact 與 SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90 建立一次命名空間。AI 指令集隨 HotKV Cloud 的 Performance 與 Scale 執行個體提供,AI 頁面列出了每個引擎的功用。價格頁面則顯示各方案包含什麼。
在正式環境中記分
看不見的快取,就是無法信任的快取。HotKV 依命名空間保存命中與未命中次數。如果您在每個項目中一併儲存原始呼叫的 Token 用量,它還能歸算之後每次命中所避免的 Token 與成本。PCACHE.STATS 與 SCACHE.STATS 的回覆就會帶有 usage_saved_requests、usage_saved_input_tokens 與 usage_saved_cost_usd 等欄位。
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
請將 <model> 換成您的模型 ID。INPUT 計算未快取的提示詞 Token,CACHEREAD 計算供應商從自己的快取提供的 Token,因此兩者不會重疊。模型必須在 HotKV 的價格表中,成本欄位才有意義。LLMSTATS.PRICE LIST 會顯示已知的模型,LLMSTATS.PRICE SET 則可加入您自己的模型。沒有價格的模型仍會計算 Token,但它的成本會記錄為零,並由另一個計數器顯示有請求未計價。
快取降低支出,預算則為剩下的部分設定上限。LLMBUDGET.SET 定義時間窗內的 Token 與金額上限。LLMBUDGET.CONSUME 在模型呼叫之前檢查,因此失控的代理會在花掉錢之前被攔下,而不是之後。LLMSTATS.RECORD 保存依租戶統計的總數,並能辨識供應商的快取讀取與快取寫入 Token。當您傳入模型名稱時,這三者都使用同一份價格表,因此節省金額、預算與儀表板上的數字不會互相矛盾。
讓快取傳回錯誤回答的錯誤
大多數不良的快取命中,都來自缺少了某些內容的鍵。請把模型、提示詞版本,以及任何工具或政策的版本放進精確快取的鍵,這樣提示詞的變更就不會提供為舊提示詞所寫的回答。
請為項目設定與您的事實變動速度相符的存活時間。以獨立的命名空間讓租戶彼此隔離,讓某位客戶的回答絕不會被提供給另一位。除非鍵中包含資料屬於誰,否則絕不要快取含有個人資料的回答。
最後,請用您自己的流量來測量。我們的數字來自一個簡短銀行問題的公開資料集、一份虛構的政策,以及每種條件各一次執行,並不是對您的工作負載的保證。
常見問題
什麼是提示詞快取?
提示詞快取是模型供應商提供的功能,會將處理後的提示詞開頭暫存一小段時間。之後以完全相同的文字開頭的請求,這個部分就按較低的費率計費。模型仍然會執行並產生新的回答,所以您仍然要為輸出 Token 付費。
提示詞快取和語意快取一樣嗎?
不一樣。提示詞快取重複利用重複出現的提示詞前綴,但仍然呼叫模型。語意快取則是對語意相近的問題傳回已儲存的回答,並略過模型呼叫。它們處理的是不同的成本,可以搭配使用。
提示詞快取會降低輸出 Token 的成本嗎?
不會。它只降低讀取快取前綴的價格。在我們的基準測試中,即使已啟用提示詞快取,輸出只占 Token 的 6% 至 9%,卻占基準成本的 73% 至 92%,這就是為什麼快取整個回答能省下更多。
Anthropic 的提示詞快取能保留多久?
預設為五分鐘,每次使用該項目都會延長。另有一小時的選項,寫入價格較高。請查閱最新的文件,因為限制與價格會變動。
可以同時使用提示詞快取與語意快取嗎?
可以,而我們的基準測試正是這麼做的。兩次執行都保持啟用供應商的提示詞快取,並把語意與精確層放在模型前面。快取命中會略過呼叫,而未命中仍然能受益於打折的前綴。
語意快取該使用什麼相似度門檻?
沒有通用的值。我們是在獨立的訓練分割上選定 0.81,而在 Sonnet 5.5 上,0.88 以上時快取回答與全新回答相比沒有出現品質落差,但證據不多。請從較高的值開始,用您自己的問題對照評判快取回答與全新回答,只有在品質維持不變時才調低門檻。
繼續討論
留言
對方法有疑問嗎?在您的硬體上得到不同的結果嗎?歡迎分享您的發現。留言會先經過審核才會顯示。