

AI 智能体记忆,让智能体能把某些信息从一个步骤、或一次会话带到下一个步骤或下一次会话。语言模型本身在两次调用之间什么都不会记住。它看起来记得的一切,都是您的代码重新放回提示词里的。您如何存储和检索这些内容,决定了智能体能回忆起什么、回忆得多快,以及每一轮的成本是多少。
简而言之:智能体需要四种记忆,即简短的对话窗口、按含义查找的长期事实、用于当前任务的草稿区,以及记录已发生之事的日志。每一种的形态、生命周期和查找方式都不同,所以单独一张记忆表对哪一种都不太合适。HotKV 用
AMEM.*命令把这四种都存放在同一个内存引擎中。我们测过的是 HotKV 的缓存和向量搜索,而不是智能体记忆,所以本文只解释设计,不声称有任何提速。
为什么上下文窗口不是记忆
上下文窗口就是您随每个请求发送的文本。它有大小限制,其中的所有内容每一轮您都要按输入 Token 付费,会话一结束它就消失了。它也无法被搜索。如果智能体需要三周前的某一个事实,把整段历史都粘贴进去并不是办法。
记忆是决定下一步该把什么放进窗口的那一层。它保留最近的几轮对话,并找出少数真正重要的较早事实。它保存当前任务的状态,并记录智能体做过的事情。研究人员也用类似的方式描述智能体。Sumers、Yao、Narasimhan 和 Griffiths 提出的 CoALA 框架把工作记忆与长期的情景记忆、语义记忆和程序性记忆区分开来。
AI 智能体记忆的四种类型
HotKV 的四个存储涵盖了大致相同的范围,只是按应用实际要构建的内容做了调整。程序性记忆,即保存在智能体代码和提示词中的技能与做法,通常位于您的代码仓库或提示词注册表中,不是单独的一种存储。
对话记忆
这是单次会话的短期记录。消息带有角色(system、user、assistant 或 tool),存放在一个有界的滑动窗口中,达到上限后最旧的几轮就会被丢弃。它回答一个问题。最近说了什么?在 HotKV 中对应的是 AMEM.CONV.CREATE、AMEM.CONV.APPEND 和 AMEM.CONV.WINDOW。
语义记忆
语义记忆是以事实形式保存、并带有嵌入向量的长期知识。智能体按含义而不是按键来回忆它们。它由 HNSW 向量索引支撑,与驱动向量搜索的是同一种索引。AMEM.SEM.STORE 保存一个事实,AMEM.SEM.RECALL 返回最匹配的若干项及其相似度分数。文档、用户偏好和学到的纠正,都应放在这里。
工作记忆
工作记忆是进行中任务的草稿区,是限定在某个会话内的一组扁平的键值对。它保存当前步骤、正在处理的工单或某个中间结果。任务结束时它就应当消失。AMEM.WORK.SET 接受生存时间,正是出于这个原因。
情景记忆
情景记忆是只追加的、带时间戳的事件日志,例如执行的一个操作、做出的一次观察或得出的一个决定。它让智能体,或者审阅它的人,可以询问发生了什么、是在什么时候发生的。AMEM.EPIS.LOG 写入一个事件,AMEM.EPIS.QUERY 按类型和时间范围把它们读回来。
实践中的 AI 智能体记忆
实践中有两件事很重要。一是如何写入记忆,二是每一轮读回什么。
用命令存储记忆
下面是一个处理单次对话的客服智能体。其中虚构的政策文本和只有三个数字的向量仅用于演示。真实的嵌入模型会生成 768 或 1,536 个数字的向量,您需要用该维度创建命名空间。
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
每一轮,智能体都会读取最近的窗口,并回忆出与问题匹配的少数事实。它检查自己的工作笔记,再用这些内容拼出提示词。行动之后,它记录一个事件。这个循环中的任何一步都不需要完整的历史。
每一轮读取记忆
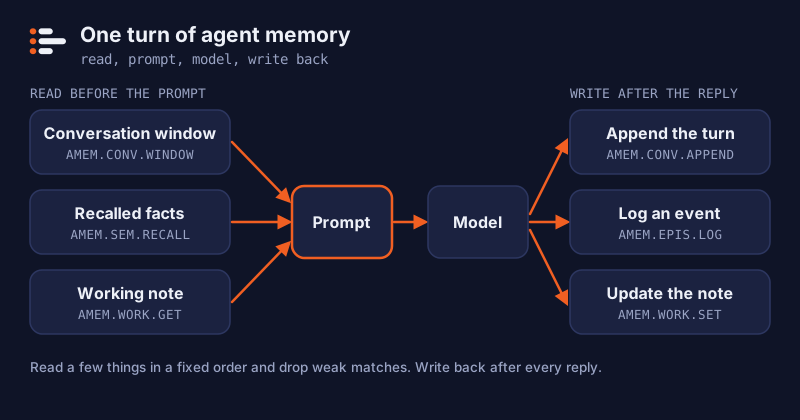
存储记忆是容易的那一半。真正的功夫在于决定读回什么,因为读回的所有内容都会进入提示词,并产生输入 Token 的成本。一个合理的循环会按固定顺序读取少量内容。先是最近的几轮对话,然后是与问题匹配的少数事实,最后是任务的状态。下面是用官方 Python 客户端写成的版本,其中的嵌入函数和提示词模板由您自己提供。
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # 请用您自己的数据来调整

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # 只创建一次,在第一次追加之前

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # 您自己的提示词模板

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
相似度的下限需要您自己调整。适合某一个嵌入模型和某一组事实的值,对另一个可能就不对,所以请用您已知答案的问题检查召回效果。丢掉较弱的匹配比看上去更重要,因为提示词里放进一个质量差的事实,还不如不放。
这个提示词中稳定不变的部分,例如系统指令,也正是服务商侧的提示词缓存可以变得更便宜的部分。请把读到的记忆放在末尾、稳定文本之后,这样记忆的变化就不会使该缓存失效。
用摘要代替越来越长的窗口
窗口会把旧的对话轮次完全丢掉。闲聊时这没有问题,但对长任务就不好了,因为第 3 轮的内容到第 300 轮时可能仍然重要。常见的办法是滚动摘要。每经过一段对话,智能体或一个更便宜的模型就把学到的内容写下来,摘要在提示词中取代旧的对话轮次。
HotKV 通过 AMEM.SUMMARY.SET、AMEM.SUMMARY.APPEND 和 AMEM.SUMMARY.GET 为每个智能体保存一份摘要。SET 替换文本,APPEND 追加一行。每次更新都会提高版本号,所以其他组件可以低成本地判断摘要是否变了、什么时候变的。
摘要是有损的,对摘要再做摘要,每一次都会丢掉更多。标识符、金额和日期之类的精确值,请不要写进文字叙述,而是放在工作记忆或语义事实中,这样它们才能保留下来。摘要则用于记录工作的大致轮廓,例如偏好、已做的决定和剩下的事项。
设计规则与保留期
记忆如果不加限制就会无限增长,所以请在第一次写入之前就设好上限。
让记忆保持有用的规则
- 为一切设上限。 给对话设置
WINDOW,给会话和工作值设置TTL。对于对话、工作值和事实,HotKV 会为只追加文件和副本记录到期时间,因此已经过期的条目不会在重启后重放文件时重新出现。 - 存事实,而不是整段记录。 写入语义记忆之前先做摘要。一个事实比一整页对话更容易被回忆起来。
- 让各个智能体彼此分开。 为每个智能体、每个租户使用单独的标识符或命名空间,这样一个客户的记忆永远不会被回忆给另一个客户。
- 回忆少量,而不是大量。 取最匹配的前三到五项,并在它们进入提示词之前,按相似度分数丢掉较弱的。
- 不要存放机密。 记忆会被读回提示词,所以绝不要存放密码、密钥,或您不愿给模型看的数据。
每种类型保留多久
这些生命周期是我们的建议,不是默认值。请根据底层事实变化的快慢,以及您被允许保留什么,来选择自己的。
| 记忆类型 | 建议的生命周期 | HotKV 中的控制手段 |
|---|---|---|
| 对话 | 会话期间,或一个固定时段,例如一天 | AMEM.CONV.CREATE 上的 WINDOW 和 TTL |
| 工作 | 任务期间,之后清除 | AMEM.WORK.SET 上的 TTL,以及 AMEM.WORK.CLEAR |
| 语义 | 直到该事实不再成立 | AMEM.SEM.STORE 上的 TTL,以及 AMEM.SEM.FORGET |
| 情景 | 只要您的审计或支持需要就保留 | 按时间范围的 AMEM.EPIS.QUERY,以及 AMEM.EPIS.CLEAR(事件没有生存时间) |
保留期也是一个隐私问题。如果记忆中保存了任何关于某个人的信息,您选择的生命周期就是对他们的承诺的一部分,所以请把它写下来。
智能体记忆是怎样出问题的
大多数记忆方面的错误都是慢性的。智能体一个星期里都表现良好,然后开始越来越差。下面是需要在设计中防范的故障。
常见故障
- 过时的事实。 三月时成立的事实,在十月被回忆了出来。请给事实设置生存时间,或者按每个实体用一个键来存储,让新值覆盖旧值。
- 相互矛盾。 两个已存事实不一致,智能体随机挑了一个。与其在旧笔记旁边追加新笔记,不如每个键只保留一个事实。
- 回忆过多。 太多匹配项让提示词里塞满了关系不大的文本。请少回忆,并丢掉较弱的匹配。
- 用户之间泄漏。 一个客户的记忆被回忆给了另一个客户。每个租户使用单独的标识符或命名空间,并在每次读取之前在代码中检查。
- 无限增长。 没有任何东西会过期,于是查找变慢,成本悄悄上升。每种类型都需要一个生命周期。在 HotKV 没有生存时间的地方,例如情景日志,请您自行安排清除或导出。
- 摘要漂移。 摘要的摘要会慢慢地与实际发生的事不再相符。请把事件日志当作真相的来源,并据此重新生成摘要。
把存储的文本视为不可信
最后一点值得更多关注。智能体写入记忆的任何内容,之后都可能被读进提示词。这包括来自网页、电子邮件或用户的文本。这就是 OWASP 列为 LLM01 的间接提示注入。请随每个事实一并存储它的来源。对由外部内容写入的记忆,要降低信任程度,并且绝不要让被回忆出来的笔记凌驾于您的系统提示词之上。
我们测量过什么,没有测量什么
HotKV 已发布的基准测试涵盖命令吞吐量、向量搜索,以及响应缓存带来的 Token 节省。智能体记忆目前还没有它自己的基准测试。对于它的延迟,或者它能在多大程度上提升智能体的质量,我们不作任何声明。我们能说的只涉及架构。这四个存储与缓存和向量索引运行在同一个进程中。一次记忆查找,就是对您已在运行的系统的一次调用。
Token 节省基准测试以及提示词缓存与语义缓存的对比展示了实测的一面。智能体记忆的使用场景则在一个完整的情景中展示了这些命令。
在 Claude Code 或 Cursor 中使用智能体记忆
支持 Model Context Protocol 的助手,无需自定义代码就能使用其中一部分记忆。开源的 hotkv-mcp 服务器把对话记忆、工作笔记、事件日志和滚动摘要作为工具提供出来。它有只读模式,还有可将智能体限制在其中的命名空间。它不提供语义记忆,其工具也无法设置窗口或生存时间,这些请使用客户端库。下一篇文章面向智能体记忆的 MCP 服务器展示如何连接它,以及它的安全措施涵盖什么。
常见问题
什么是 AI 智能体记忆?
AI 智能体记忆是一个存储与检索层,让智能体可以跨步骤、跨会话保留信息。它通常结合了最近的对话窗口、按含义查找的长期事实、用于当前任务的草稿区,以及一份事件日志。
智能体的短期记忆和长期记忆有什么区别?
短期记忆保存当前正在发生的事情,例如最近的对话轮次和任务状态,它有界限,也是暂时的。长期记忆保存应当比会话存活更久的知识,例如事实、偏好和过往事件,需要时再去搜索。
智能体记忆中的滚动摘要是什么?
滚动摘要是对智能体迄今为止学到或决定的内容所做的简短的持续性描述,随着工作进行而更新。它在提示词中取代旧的对话轮次,使提示词不会不断变长。HotKV 为每个智能体存储一份,并在每次更新时提高版本号。
智能体记忆需要向量数据库吗?
只有语义记忆需要,也就是按含义查找事实的那一种。对话窗口、工作状态和事件日志不需要向量。HotKV 把这四种都放在同一个引擎中,所以向量索引和其他存储并不是各自独立的系统。
智能体记忆应该保留多久?
这取决于类型。工作记忆应在任务结束时过期,对话在会话结束后或一个设定的时段后过期,情景日志则只要您的审计需要就保留。语义记忆中的事实,应当在不再成立时被审查并移除。
智能体记忆会遭到攻击吗?
会。写入记忆的文本之后会被读进提示词,所以一条被投毒的笔记可以左右智能体。请记录每个事实的来源,降低对外部内容的信任,并让被回忆出的记忆在权威性上低于您的系统提示词。
HotKV 把智能体记忆存放在内存中吗?
HotKV 是内存引擎,所以读取直接从内存提供。根据产品文档,对这四个存储的写入会被记录到只追加文件和副本中,并一并带上到期时间。

继续讨论
评论
对方法有疑问?在您的硬件上得到了不同的结果?欢迎分享您的发现。评论经审核后才会显示。