

有两种不同的东西都被当作语言模型的缓存来卖,团队常常买了其中一种,却指望它做到另一种的事。提示词缓存是服务商提供的功能,让重复出现的提示词前缀读取起来更便宜。语义缓存是您自己运行的一层,直接从内存中回答问题,根本不调用模型。两者解决账单的不同部分,搭配使用效果最好。
简而言之:提示词缓存只对提示词中重复的开头部分(例如很长的系统提示词)打折,但模型仍然要运行,每个输出 Token 您仍要付费。精确缓存和语义缓存则在问题以前回答过时,完全省去这次调用。在我们 3,000 个请求的基准测试中,服务商的提示词缓存本来就已开启,在前面加上 HotKV 后,模型调用、Token 和成本都降低了约 70%,因为输出 Token 仍占基线成本的 73% 至 92%。
提示词缓存的工作原理
提示词缓存位于模型服务商一侧。您标出请求中稳定不变的开头部分,通常是工具定义和系统提示词,服务商会把它处理后的形式保存一小段时间。下一个以完全相同文本开头的请求,这一部分按较低费率计费。这里介绍的是 Anthropic 的版本,因为我们测量的就是它。下面的细节来自其提示词缓存文档,核对日期为 2026 年 10 月 18 日。
哪些内容会被缓存
命中要求完全匹配。从开头直到并包括您用 cache_control 标记的那一块,每个块都必须一致,顺序为工具、系统提示词,然后是消息。如果在提示词靠前的位置改动哪怕一个字符,其后的所有内容都会未命中。问题本身排在最后,因此永远不属于被缓存的前缀。
长度低于最小值的提示词不会被缓存,也不会返回错误。对于我们使用的当前 Claude 模型,即 Fable 5.1、Opus 5.5、Sonnet 5.5 和 Haiku 5.5,文档规定的最小值是 512 个 Token。缓存条目按组织隔离,在 Claude API 上则按工作区隔离。
它的成本
默认有效期为五分钟,条目每被使用一次就会免费刷新。也可以选择一小时的有效期。写入条目的成本,五分钟有效期为基础输入价格的 1.25 倍,一小时为 2 倍。根据价格页面,读取的成本在大多数模型上是基础输入价格的 0.1 倍,在 Opus 5.5 和 Sonnet 5.5 上是 0.05 倍,在 Fable 5.1 上是 0.025 倍。这些倍数会变化,计算之前请先查看当前页面。
提示词缓存无法消除什么
提示词缓存只是为读取前缀打折,并不会跳过模型。每个请求仍然会生成一个全新的答案,您仍然要等待,每个输出 Token 也仍按完整的输出价格计费。
我们的基准测试展示了这有多重要。我们向四个 Claude 模型各发送 3,000 个客服问题,以一份 2,200 Token 的政策作为系统提示词,并开启服务商的缓存。所统计的 Token 中有 90% 至 93% 是对这份政策的缓存读取。输出只占 Token 的 6% 至 9%,却占基线成本的 73% 至 92%。前缀本来就已经很便宜,剩下的开销都在答案上。
这正是其他几层要填补的空缺。完整的方法和结果见 Token 节省基准测试。
精确响应缓存与语义响应缓存
有两层会直接从内存中回答请求。它们的区别在于如何判断新请求与旧请求匹配。
精确响应缓存
精确缓存把最终答案存放在一个键下,这个键由影响答案的所有因素生成,通常是模型、提示词版本和规范化后的问题。同样的请求再次到来时,直接返回已存的答案,不调用模型。没有相似度分数,也不会把为另一个问题准备的答案返回出去。
在我们的运行中,精确缓存应答了约 39% 的请求。重复问题的返回时间中位数约为 0.05 ms。这是用 Python 客户端通过同一台机器上的本地回环测得的,因此请将它视为本地数据,而不是网络数据。基准测试在这一层使用的是普通的 GET 和 SET。HotKV Enterprise 还提供专门的精确匹配提示词缓存 PCACHE.*,带有按命名空间的限额和成本追踪。
精确缓存对措辞毫不敏感。“How do I reset my password?”和“I forgot my password”是两个不同的键。
语义缓存
语义缓存查找的是问题的含义。它把问题转换为嵌入向量,找到最接近的已存问题,如果余弦相似度达到阈值,就返回它的答案。在 HotKV 中对应的是 SCACHE.*,它建立在与向量搜索相同的向量索引之上。
我们约有 31% 的请求是这样应答的。一个改写后的问题耗时中位数约为 130 ms,几乎全部花在对嵌入服务的调用上,因此语义命中比调用模型快得多,但并非瞬时完成。如果没有语义层,仅靠精确缓存,3,000 个请求中最多需要 1,264 次模型调用,即减少约 58%。语义层将节省幅度提高到约 70%。
风险也出在这里。相似的问题并不总是同一个问题。我们让另一个 Claude 模型,把每一次语义命中与一个新答案进行对比评判。在默认阈值 0.81 下,缓存答案切合原问题的比例比新答案低 5.8 至 10.7 个百分点。在 Sonnet 5.5 上,阈值为 0.88 及以上时没有出现这种差距,但证据有限。刻意写成只差一个关键细节的问题,在 0.81 时仍有 62% 被匹配,在 0.95 时为 10%。
提示词缓存与语义缓存对照
| 服务商提示词缓存 | 精确响应缓存 | 语义缓存 | |
|---|---|---|---|
| 省去什么 | 一部分输入价格 | 整个模型调用 | 整个模型调用 |
| 匹配规则 | 相同的前缀 | 相同的请求 | 含义相近且高于阈值 |
| 输出 Token 是否计费 | 是,每次都计费 | 否,命中时不计费 | 否,命中时不计费 |
| 答案出错的风险 | 无 | 相同的请求没有风险 | 确实存在,由阈值调节 |
| 在哪里运行 | 在服务商处 | 在您的缓存中 | 在您的缓存中,外加一次嵌入调用 |
| 在我们的运行中所占的请求比例 | 始终开启 | 约 39% | 约 31% |
服务商的提示词缓存和响应缓存并不是二选一的关系。一个降低您仍然要发起的调用的价格,另一个减少您发起调用的次数。
缓存对延迟的影响
跳过模型,改变的不只是成本,也包括答案到达的速度。在我们的运行中,获得完整答案的时间中位数在 Fable 5.1 上从 2.7 秒降至 127 ms,在 Opus 5.5 上从 2.9 秒降至 126 ms,在 Sonnet 5.5 上从 1.8 秒降至 128 ms,在 Haiku 5.5 上从 1.4 秒降至 125 ms。按中位数计算,快了 11 至 23 倍。
慢的一端几乎没有变化。仍有约 30% 的请求会到达模型,在 Fable 5.1 上,第 99 百分位数在使用 HotKV 时约为 6.4 秒,不使用时为 6.6 秒。缓存只会消除它所应答的那些请求的等待,对未命中的请求没有任何帮助。如果您的问题是最坏情况很慢,而不是典型情况很慢,仅靠缓存无法解决。
这些都是获得完整答案的时间,因为调用没有使用流式传输。流式输出的答案会更早显示出前几个字。在聊天窗口中的差距,要小于这些数字所显示的差距。
为您的流量选择合适的层
合适的层取决于您的请求如何重复,而且在构建任何东西之前,您就可以先测量这一点。
让缓存层与流量相匹配
让缓存层与请求的重复方式相匹配。
- 很长且稳定的系统提示词或工具列表: 使用服务商的提示词缓存。开启它几乎没有成本,也不会改变任何答案。
- 措辞完全相同的同一个问题,例如按钮、模板或重试: 使用精确响应缓存。它安全且快速。
- 客服、搜索和常见问题类流量,人们用不同的措辞问同一件事: 加上语义缓存,把阈值设得高一些,并先在您自己的问题上检查答案质量,再决定是否信任它。
- 答案取决于用户、时钟或实时数据: 这些都不要缓存,或者把缓存的键建立在会改变答案的那些事实上。
节省幅度取决于重复程度。当我们让每个意图出现的概率相同,而不是呈偏斜分布时,在重新运行的两个模型上成本降低了 56%,而在 3,000 个问题全都互不相同时,成本降低了 38%。没有重复或相似问题的工作负载不会有任何节省。
先测量您自己的重复率
在构建任何东西之前,先弄清楚您的流量中有多少是重复的。这个数字决定了精确缓存是否值得拥有。用您已经记录的问题,十分钟就能算出来。按照缓存键将采用的方式规范化每个问题,统计其中互不相同的数量,看看流量中有多少是重复的。
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share 是精确缓存在见过每个问题第一次之后本可应答的请求比例。我们的测试集在 3,000 个请求中有 1,264 个互不相同的问题,所以这个数字约为 58%。如果您算出来接近 5%,精确缓存几乎没有作用,只有语义层才能帮上忙。
有两点需要注意。缓存一开始是空的,因此最初的请求总会到达模型。在我们的运行中,最初一千个请求约有 52% 由缓存应答,最后一千个请求约有 81%。另外,上个月的流量记录只能告诉您上个月的情况。如果您即将上线的功能会改变人们的提问内容,请把这个数字仅当作粗略的参考。
把各层组合起来
请求应当从最便宜、最安全的一层开始,依次经过各层,直到最昂贵的一层,并且您应该能看到每一层节省了多少。
查找顺序
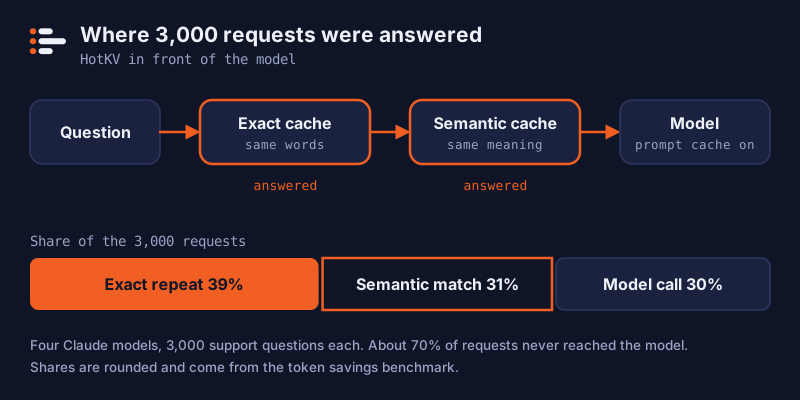
顺序很重要。先检查最便宜、最安全的一层,只有全部未命中时才调用模型。下面的示例假设使用 redis-py 风格的客户端并设置了 decode_responses=True,两个命名空间已提前创建,并且有您自己的 embed 和 llm 函数。
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # 措辞相同

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # 含义相同

    reply = llm.complete(question)                   # 服务商的提示词缓存在这里生效
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
命名空间只需创建一次,使用 PCACHE.CREATE answers_exact 和 SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90,其中的维度请换成您的嵌入模型的维度。AI 命令集随 HotKV Cloud 的 Performance 和 Scale 实例提供,AI 页面列出了每个引擎的作用。价格页面显示了各套餐包含什么。
在生产环境中记录成效
看不见的缓存,就无法信任。HotKV 按命名空间记录命中和未命中次数。如果您在存储每个条目时一并保存原始调用的 Token 用量,它还可以统计之后每次命中所避免的 Token 和成本。PCACHE.STATS 和 SCACHE.STATS 的返回中就会带有 usage_saved_requests、usage_saved_input_tokens 和 usage_saved_cost_usd 等字段。
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
请把 <model> 换成您的模型 ID。INPUT 统计未缓存的提示词 Token,CACHEREAD 统计服务商从其自身缓存中提供的 Token,因此两者不会重叠。该模型必须在 HotKV 的价格表中,成本字段才有意义。LLMSTATS.PRICE LIST 显示已知的模型,LLMSTATS.PRICE SET 可以添加您自己的模型。没有价格的模型,其 Token 仍会被统计,但成本记为零,并且会有一个单独的计数器显示有请求没有定价。
缓存降低支出,预算则为剩余部分设定上限。LLMBUDGET.SET 定义某个时间窗口内的 Token 和美元限额。LLMBUDGET.CONSUME 在调用模型之前检查,因此失控的智能体会在花掉钱之前被拦下,而不是之后。LLMSTATS.RECORD 保存各租户的合计,并能识别服务商的缓存读取和缓存写入 Token。当您传入模型名称时,这三者使用同一张价格表,因此节省额、预算和仪表盘数字不会互相矛盾。
导致缓存返回错误答案的常见错误
大多数错误的缓存命中,都源于键中缺了某些内容。请把模型、提示词版本以及任何工具或政策的版本放进精确缓存的键里,这样提示词改动后,就不会再返回为旧版本写的答案。
给条目设置的有效期应与您的事实变化的速度相称。用不同的命名空间把租户隔开,这样一个客户的答案永远不会被提供给另一个客户。除非键中包含数据属于谁,否则不要缓存包含个人数据的答案。
最后,请在您自己的流量上测量。我们的数字来自一个由简短银行问题组成的公开数据集、一份虚构的政策,以及每种条件一次运行,它们并不是对您的工作负载的承诺。
常见问题
什么是提示词缓存?
提示词缓存是模型服务商提供的一项功能,会把提示词处理后的开头部分保存一小段时间。之后以完全相同的文本开头的请求,这一部分按较低费率计费。模型仍然会运行并生成新的答案,所以您仍要为输出 Token 付费。
提示词缓存和语义缓存是一回事吗?
不是。提示词缓存重复利用的是重复出现的提示词前缀,仍然要调用模型。语义缓存则针对含义相近的问题返回已存的答案,并跳过模型调用。它们针对的是不同的成本,可以一起使用。
提示词缓存能降低输出 Token 的成本吗?
不能。它只会降低读取已缓存前缀的价格。在我们的基准测试中,在提示词缓存本来就已开启的情况下,输出只占 Token 的 6% 至 9%,却占基线成本的 73% 至 92%,这就是缓存完整答案能节省得多得多的原因。
Anthropic 的提示词缓存能持续多久?
默认是五分钟,每次使用条目时都会刷新。另有一小时的选项,写入价格更高。请查看当前的文档,因为限制和价格会变化。
可以同时使用提示词缓存和语义缓存吗?
可以,我们的基准测试正是这样做的。两次运行中服务商的提示词缓存都保持开启,精确层和语义层则位于模型之前。缓存命中会跳过调用,未命中的请求仍然能享受前缀的折扣。
语义缓存应该使用什么相似度阈值?
没有通用的值。我们在单独的训练集上选定了 0.81,而在 Sonnet 5.5 上,从 0.88 起,缓存答案与新答案相比没有出现质量差距,但证据有限。请从较高的值开始,在您自己的问题上对比评判缓存答案与新答案,只有质量不受影响时才降低阈值。

继续讨论
评论
对方法有疑问?在您的硬件上得到了不同的结果?欢迎分享您的发现。评论经审核后才会显示。