Dieser Redis-Latenz-Benchmark misst, wie lange HotKV, Redis, Valkey und Dragonfly bei einer festen Anfragerate zum Antworten brauchen. Unsere früheren Benchmarks haben den Durchsatz gemessen, und ein Leser hat zu Recht darauf hingewiesen, dass der Durchsatz nicht alles ist. Deshalb haben wir die Last konstant gehalten, Schritt für Schritt erhöht und bei jedem Schritt den Median (p50) und das 99. Perzentil (p99) erfasst. Außerdem haben wir die Zustellzeit von Pub/Sub gemessen.
Kurz gesagt. In diesem Redis-Latenz-Benchmark auf AWS hielten HotKV und Dragonfly beide 1,6 Millionen GETs pro Sekunde, Redis mit 8 I/O-Threads etwa 0,8 Millionen, Valkey mit 8 I/O-Threads etwa 0,4 Millionen und Redis und Valkey mit einem Thread etwa 0,2 Millionen. Von 200.000 bis 1,6 Millionen Anfragen pro Sekunde blieb das p99 von HotKV zwischen 0,59 und 0,76 ms, bei Dragonfly zwischen 0,71 und 1,48 ms. Bei geringer Last lagen die Multithread-Produkte beim p99 gleichauf, und auch die Pub/Sub-Zustellung war ein Unentschieden.
Warum wir einen Redis-Latenz-Benchmark mit fester Rate durchgeführt haben
Ein Durchsatztest treibt einen Server so weit, wie er geht, und meldet, wie viel er bedient hat. Das sagt wenig darüber, wie lange eine einzelne Anfrage wartet. Ein Latenztest legt fest, wie viele Anfragen pro Sekunde die Clients senden, und misst die Zeit jeder einzelnen. Der Server steht dann unter derselben Last wie jedes andere Produkt, sodass sich die Zeiten vergleichen lassen.
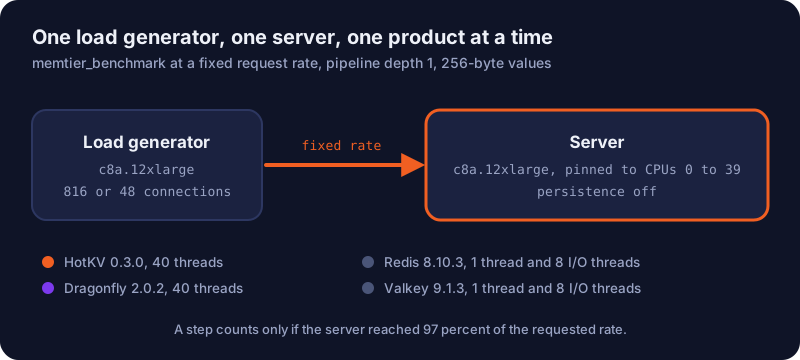
Diese Art von Test hat einen Haken. memtier_benchmark arbeitet im geschlossenen Regelkreis, ein Client wartet also auf eine Antwort, bevor er die nächste Anfrage sendet. Kommt ein Server nicht mehr mit, sendet der Client einfach weniger Anfragen, und die Latenz der gesendeten sieht besser aus, als sie ist. Wir werten einen Schritt daher nur als gehalten, wenn die erreichte Rate mindestens 97 Prozent der angeforderten Rate beträgt. Schritte, die diesen Test nicht bestehen, sind in den Tabellen als „NS“ (nicht gehalten) markiert, und ihre Latenz wird nicht gezeigt.
Was wir getestet haben
Maschinen
- Server und Lastgenerator. Instanzen vom Typ
c8a.12xlarge(AMD EPYC 9R45, 48 Kerne, kein SMT, 96 GiB, 22,5 Gbit/s Netzwerk) in einer AWS-Cluster-Placement-Group in eu-south-2a unter Ubuntu 24.04. Eine Instanz führte den Lastgenerator aus, eine den Server. - Ein Produkt nach dem anderen. Jedes Produkt lief allein auf dem Server, sodass sich nichts überlagerte und nichts das Netzwerk teilte. Jeder Serverprozess war an die CPUs 0 bis 39 gebunden, bei ausgeschalteter Persistenz und ausgeschaltetem Protected Mode.
Produkte
- HotKV 0.3.0 mit 40 Threads.
- Dragonfly 2.0.2 mit 40 Proactor-Threads.
- Redis 8.10.3 und Valkey 9.1.3, jeweils zweimal gelaufen, einmal im Standard-Setup mit einem Thread und einmal mit
--io-threads 8.
Die Startzeile und die Live-Ausgabe von CONFIG GET jedes Laufs sind bei seinen Ergebnissen gespeichert.
Last und Vorgehen
Der Datensatz bestand aus 1.000.000 Schlüsseln mit 256-Byte-Werten, die Pipeline-Tiefe war 1, jede Anfrage wartet also auf ihre eigene Antwort. Die Last war nur GET sowie ein Mix aus 1 Schreibzugriff auf 10 Lesezugriffe. Jeder Schritt lief 20 Sekunden, zweimal, und wir berichten den Mittelwert der beiden Läufe. memtier_benchmark nutzte ein Ratenlimit pro Verbindung und zeichnete ein HDR-Histogramm auf. Wir haben zwei Verbindungszahlen getestet.
- 816 Verbindungen (24 Threads mit je 34 Verbindungen), für Raten von 20.000 bis 2,4 Millionen Anfragen pro Sekunde.
- 48 Verbindungen (4 Threads mit je 12 Verbindungen), für Raten bis 300.000 Anfragen pro Sekunde. Darüber können 48 Verbindungen die Rate nicht erreichen, weil jede Verbindung nur so schnell senden kann, wie sie Antworten erhält.
Ergebnisse
Zuerst kommen die GET-Tabellen, eine für jede Verbindungszahl, danach Pub/Sub.
Bei 816 Verbindungen
Jede Zelle zeigt p50 / p99 in Millisekunden für GET. „NS“ steht für nicht gehalten, in Klammern steht die tatsächlich erreichte Rate. Ein Strich bedeutet, dass der Durchlauf für dieses Produkt bereits beendet war.
| Anfragen/s | HotKV | Dragonfly | Redis 1 Thread | Redis 8 I/O-Threads | Valkey 1 Thread | Valkey 8 I/O-Threads |
|---|---|---|---|---|---|---|
| 19.584 | 0,38 / 1,81 | 0,48 / 1,90 | 1,63 / 5,29 | 0,68 / 2,07 | 1,59 / 5,13 | 0,76 / 2,63 |
| 99.552 | 0,24 / 0,76 | 0,27 / 1,76 | 2,60 / 5,12 | 0,40 / 0,98 | 2,65 / 5,13 | 1,71 / 3,19 |
| 199.920 | 0,25 / 0,59 | 0,25 / 1,34 | 2,91 / 5,60 | 0,55 / 1,11 | 3,02 / 5,81 | 1,11 / 2,15 |
| 399.840 | 0,27 / 0,63 | 0,27 / 1,48 | NS (258k) | 0,62 / 1,23 | NS (259k) | 1,24 / 1,49 |
| 799.680 | 0,28 / 0,75 | 0,28 / 1,26 | - | 0,68 / 1,18 | - | NS (670k) |
| 1.199.520 | 0,28 / 0,67 | 0,28 / 1,05 | - | NS (1.078k) | - | - |
| 1.599.360 | 0,28 / 0,64 | 0,28 / 0,71 | - | - | - | - |
| 2.399.856 | NS (2.284k) | NS (2.281k) | - | - | - | - |
Die gemischte Last ergab dasselbe Bild. Das p99 von HotKV lag von 200.000 bis 1,6 Millionen Anfragen pro Sekunde bei 0,54 bis 0,75 ms, und die Punkte, die jedes Produkt halten konnte, waren dieselben wie bei GET. Alles steht im Ergebnisordner.
So sind die Zeilen mit einem Thread zu lesen
Die Mediane von 1,6 bis 3 ms bei Redis und Valkey mit einem Thread und 816 Verbindungen sind nicht ihre Latenz im stationären Betrieb. Mit einem Ratenlimit lässt memtier_benchmark alle 816 Verbindungen im selben Moment senden. Ein Server mit einem Thread muss diesen Schub von 816 Anfragen nacheinander abarbeiten, sodass der Median einer Anfrage ihren Platz in der Warteschlange enthält. Den Test mit 48 Verbindungen unten haben wir durchgeführt, um diesen Effekt zu beseitigen.
Bei 48 Verbindungen
Die Zellen haben dieselbe Bedeutung wie oben, nur für GET.
| Anfragen/s | HotKV | Dragonfly | Redis 1 Thread | Redis 8 I/O-Threads | Valkey 1 Thread | Valkey 8 I/O-Threads |
|---|---|---|---|---|---|---|
| 9.984 | 0,14 / 0,54 | 0,14 / 0,37 | 0,21 / 0,89 | 0,17 / 0,92 | 0,21 / 0,91 | 0,20 / 0,81 |
| 49.968 | 0,10 / 0,28 | 0,11 / 0,28 | 0,21 / 0,41 | 0,13 / 0,28 | 0,21 / 0,43 | 0,21 / 0,44 |
| 99.984 | 0,09 / 0,28 | 0,10 / 0,28 | 0,20 / 0,40 | 0,13 / 0,28 | 0,20 / 0,38 | 0,19 / 0,35 |
| 199.968 | 0,08 / 0,27 | 0,08 / 0,27 | 0,20 / 0,35 | 0,10 / 0,27 | 0,21 / 0,36 | 0,11 / 0,28 |
| 300.000 | 0,08 / 0,27 | 0,08 / 0,27 | NS (231k) | 0,09 / 0,26 | NS (233k) | 0,09 / 0,26 |
Zustellzeit bei Pub/Sub
Wir haben die Zeit von einem Publish bis zur Zustellung an einen Subscriber gemessen, mit 64 Publishern, 100 Subscribern und 128 Byte Nutzlast, mit pubsub-sub-bench. Jede Nachricht ging an einen Subscriber. Die Zellen zeigen p50 / p99 in Millisekunden.
| Zustellungen/s | HotKV | Dragonfly | Redis 1 Thread | Redis 8 I/O-Threads | Valkey 1 Thread | Valkey 8 I/O-Threads |
|---|---|---|---|---|---|---|
| etwa 21.000 | 0,10 / 0,71 | 0,10 / 0,65 | 0,11 / 0,74 | 0,11 / 0,62 | 0,11 / 0,76 | 0,12 / 0,78 |
| etwa 107.000 | 0,10 / 1,02 | 0,12 / 0,92 | 0,10 / 0,80 | 0,11 / 0,63 | 0,10 / 0,82 | 0,10 / 0,86 |
| etwa 215.000 | 0,11 / 1,20 | 0,13 / 1,13 | 0,51 / 1,03 | 0,20 / 0,73 | 0,57 / 1,07 | 0,12 / 1,22 |
Alle Produkte stellten im selben Bereich zu. Bei der höchsten Last hatten die Produkte mit einem Thread einen höheren Median, 0,51 und 0,57 ms gegenüber 0,11 ms bei HotKV.
Außerdem mussten wir pubsub-sub-bench patchen. Das Tool verglich eine Publish-Zeit in Millisekunden mit einer Empfangszeit in Mikrosekunden. Der Patch liegt im Ergebnisordner.
Was die Ergebnisse zeigen
Die Tabellen zeigen bei hoher Last einen Vorsprung für HotKV und Dragonfly, bei geringer Last ein Unentschieden und eine Obergrenze für Redis und Valkey mit einem Thread.
HotKV und Dragonfly hielten bis 1,6 Millionen Anfragen pro Sekunde ein niedriges Tail
Beide hielten bei 816 Verbindungen 1,6 Millionen GETs pro Sekunde, mit einem Median von 0,28 ms. Das p99 von HotKV lag ab 200.000 Anfragen pro Sekunde zwischen 0,59 und 0,76 ms. Bei Dragonfly lag es zwischen 0,71 und 1,48 ms, und bei 1,6 Millionen lagen beide nah beieinander (0,64 gegenüber 0,71 ms). Redis und Valkey mit I/O-Threads hielten die Rate bei niedrigeren Lasten nicht mehr, und Redis und Valkey mit einem Thread bei etwa 260.000.
Bei geringer Last liegen die Multithread-Produkte gleichauf
Bei 48 Verbindungen und bis zu 300.000 Anfragen pro Sekunde hatten HotKV, Dragonfly und Redis mit 8 I/O-Threads alle ein p99 von etwa 0,27 ms. HotKV hatte den niedrigsten Median, 0,08 bis 0,09 ms ab 100.000 Anfragen pro Sekunde, Dragonfly lag bei 0,08 bis 0,10 ms. Ein Unterschied von 0,01 ms liegt im Bereich dessen, was andere Teile des Aufbaus verursachen können, daher werten wir ihn nicht als Vorsprung.
Redis und Valkey mit einem Thread stießen bei etwa 230.000 pro Sekunde an ihre Grenze
Bei 48 Verbindungen hatten sie einen Median von etwa 0,2 ms und ein p99 von 0,35 bis 0,43 ms, und sie hielten 300.000 Anfragen pro Sekunde nicht (etwa 231.000 und 233.000). Das ist die Obergrenze eines Threads bei dieser Hardware und Last. Deshalb werden Redis und Valkey meist als viele Prozesse oder als Cluster betrieben, wie in unserem Cluster-Benchmark.
Grenzen
Dies sind Messungen von HotKV Ltd an den oben genannten Versionen und der oben genannten Konfiguration. Sie sind keine Aussage über andere Versionen, Konfigurationen oder Lasten dieser Produkte.
Der Testaufbau
- Ein Server, ein Lastgenerator. Zwei Wiederholungen pro Schritt, auf einem Satz Maschinen an einem Datum. Die Streuung zwischen Maschinen oder Tagen haben wir nicht gemessen.
- Von uns gewählte Setups. Redis und Valkey liefen im Standard-Setup mit einem Thread und mit
--io-threads 8, und wir haben keines der Produkte darüber hinaus abgestimmt. Andere Einstellungen könnten ihre Werte verändern. Wenn Sie meinen, dass eine Einstellung hier ein Produkt benachteiligt, sagen Sie es uns, wir prüfen es und veröffentlichen das Ergebnis. - Der Schub-Effekt des Tools. Bei 816 Verbindungen sind die Mediane der Produkte mit einem Thread durch die Funktionsweise des Ratenlimits von
memtier_benchmarküberhöht, wie oben erklärt.
Was nicht gemessen wurde
- Daten. Größere oder ungleich verteilte Werte, Speicher pro Schlüssel und Persistenz. Die Persistenz war bei allen Servern ausgeschaltet.
- Modi. Cluster-Modus, Sharded Pub/Sub, TLS, Replikation und Failover.
- Pub/Sub-Fan-out. Eine Nachricht an viele Subscriber.
Redis, Valkey und Dragonfly sind Marken ihrer jeweiligen Inhaber. Sie werden nur genannt, um die gemessene Software zu bezeichnen, und das impliziert weder Sponsoring noch Billigung oder Zugehörigkeit.
Selbst nachmessen
Die Sweep-Skripte, die Startzeile und die Live-Konfiguration jedes Servers, der Patch für pubsub-sub-bench und alle Rohergebnisse liegen im Benchmark-Repository. Das Latenz-Skript ist harness/lat_sweep.sh, das Pub/Sub-Skript ist harness/ps_sweep.sh. Der Ordner raw enthält pro Test ein Archiv mit dem JSON von memtier_benchmark, den HDR-Histogrammen und der CPU-Auslastung des Servers für jeden Lauf.
Selbst ausprobieren
HotKV Cloud betreibt HotKV für Sie. Starten Sie mit HotKV Cloud oder sprechen Sie mit dem Vertrieb, um HotKV mit Ihrer eigenen Last zu vergleichen.
Häufig gestellte Fragen
Ist HotKV bei der Latenz schneller als Redis?
Unter Last und bei den getesteten Raten ja. Bei 816 Verbindungen und 200.000 Anfragen pro Sekunde hatte HotKV ein p99 von 0,59 ms, Redis mit 8 I/O-Threads 1,11 ms und Redis mit einem Thread 5,60 ms. Bei geringer Last mit 48 Verbindungen lagen die Multithread-Produkte beim p99 gleichauf, bei etwa 0,27 ms.
Warum haben Sie die Anfragerate festgehalten?
Bei fester Rate trägt jedes Produkt dieselbe Last, sodass sich die Latenzen vergleichen lassen. Ein Durchsatztest zeigt, wie viel ein Server an seiner Grenze bedient, und sagt wenig darüber, wie lange eine einzelne Anfrage wartet.
Was bedeutet „nicht gehalten“?
Das Produkt erreichte weniger als 97 Prozent der angeforderten Anfragerate. memtier_benchmark arbeitet im geschlossenen Regelkreis, ein überlasteter Server lässt die Clients also weniger senden, und die Latenz der übrigen Anfragen sieht besser aus, als sie ist. Für diese Schritte zeigen wir keine Latenz.
Wie schnitt die Pub/Sub-Zustellzeit im Vergleich ab?
Bei den drei getesteten Lasten stellten alle Produkte im selben Bereich zu, mit einem Median von etwa 0,1 ms bei den beiden niedrigeren Lasten. Die Tabelle oben enthält jeden Wert.
Kann ich diesen Redis-Latenz-Benchmark nachvollziehen?
Ja. Die Skripte, die Konfigurationen und alle Rohergebnisse liegen im Benchmark-Repository. Sie brauchen zwei Server im selben Netzwerk, einen Lastgenerator und die vier Produkte.
Diskutieren Sie mit
Kommentare
Fragen zur Methode? Ein anderes Ergebnis auf Ihrer Hardware? Teilen Sie mit, was Sie herausgefunden haben. Kommentare werden vor der Veröffentlichung geprüft.