

Deux choses différentes sont vendues comme du cache pour les modèles de langage, et les équipes achètent régulièrement l’une en attendant l’autre. Le cache de prompts est une fonction du fournisseur qui rend moins chère la lecture d’un préfixe de prompt répété. Le cache sémantique est une couche que vous exploitez vous-même et qui répond à une question depuis la mémoire, sans jamais appeler le modèle. Ils réduisent deux moitiés différentes de la facture, et ils fonctionnent mieux ensemble.
En bref. Le cache de prompts applique une remise sur le début répété d’un prompt, comme un long prompt système, mais le modèle s’exécute quand même et vous payez toujours chaque token de sortie. Le cache exact et le cache sémantique suppriment entièrement l’appel lorsqu’une question a déjà reçu une réponse. Dans notre benchmark de 3 000 requêtes, avec le cache de prompts du fournisseur déjà activé, ajouter HotKV devant a réduit d’environ 70 % les appels au modèle, les tokens et le coût, car les tokens de sortie représentaient encore de 73 % à 92 % du coût de référence.
Comment fonctionne le cache de prompts
Le cache de prompts se trouve chez le fournisseur du modèle. Vous marquez le début stable d’une requête, généralement les outils et le prompt système, et le fournisseur conserve sa forme traitée pendant une courte durée. La requête suivante qui commence par le texte identique est facturée à tarif réduit pour cette partie. Nous décrivons ici la version d’Anthropic, car c’est celle que nous avons mesurée. Les détails ci-dessous proviennent de sa documentation sur le cache de prompts, consultée le 18 octobre 2026.
Ce qui est mis en cache
Un succès exige une correspondance exacte. Chaque bloc jusqu’à celui que vous avez marqué avec cache_control, inclus, doit être identique, dans l’ordre outils, prompt système, puis messages. Changez un seul caractère au début du prompt et tout ce qui suit est un échec. La question elle-même vient en dernier, elle ne fait donc jamais partie du préfixe mis en cache.
Les prompts plus courts qu’une longueur minimale ne sont pas mis en cache, et aucune erreur n’est renvoyée. Pour les modèles Claude actuels que nous avons utilisés, Fable 5.1, Opus 5.5, Sonnet 5.5 et Haiku 5.5, le minimum documenté est de 512 tokens. Les entrées du cache sont isolées par organisation, et par espace de travail sur l’API Claude.
Ce que cela coûte
La durée de vie par défaut est de cinq minutes, et chaque utilisation de l’entrée la prolonge sans frais supplémentaires. Une durée de vie d’une heure est disponible. Écrire une entrée coûte 1,25 fois le prix d’entrée de base pour cinq minutes et 2 fois pour une heure. La lire coûte 0,1 fois le prix d’entrée de base sur la plupart des modèles, 0,05 fois sur Opus 5.5 et Sonnet 5.5, et 0,025 fois sur Fable 5.1, d’après la page de tarification. Ces coefficients changent, lisez donc la page actuelle avant tout calcul.
Ce que le cache de prompts ne peut pas supprimer
Le cache de prompts réduit le prix de la lecture du préfixe. Il ne court-circuite pas le modèle. Chaque requête produit toujours une réponse neuve, vous l’attendez toujours, et chaque token de sortie est facturé au plein tarif de sortie.
Notre benchmark montre l’importance de ce point. Nous avons envoyé 3 000 questions de support client à chacun de quatre modèles Claude, avec une politique de 2 200 tokens comme prompt système et le cache du fournisseur activé. De 90 % à 93 % des tokens comptés étaient des lectures de cache de cette politique. La sortie ne représentait que de 6 % à 9 % des tokens, mais de 73 % à 92 % du coût de référence. Le préfixe coûtait déjà peu, et le reste de la dépense se trouvait donc dans les réponses.
C’est l’écart que comblent les autres couches. La méthode complète et les résultats figurent dans le benchmark d’économies de tokens.
Cache de réponses exact et sémantique
Deux couches répondent à une requête depuis la mémoire. Elles diffèrent par la façon dont elles décident qu’une nouvelle requête correspond à une ancienne.
Cache de réponses exact
Un cache exact stocke la réponse finale sous une clé construite à partir de tout ce qui la façonne. Normalement, ce sont le modèle, la version du prompt et la question normalisée. Quand la même requête revient, la réponse stockée est renvoyée et le modèle n’est pas appelé. Il n’y a ni score de similarité ni risque de renvoyer une réponse destinée à une autre question.
Dans notre exécution, le cache exact a répondu à environ 39 % des requêtes. Une question répétée est revenue en une médiane d’environ 0,05 ms. Cela a été mesuré avec un client Python via loopback sur la même machine, il faut donc le lire comme un chiffre local et non comme un chiffre réseau. Le benchmark utilisait de simples GET et SET pour cette couche. HotKV Enterprise dispose aussi d’un cache de prompts dédié à la correspondance exacte, PCACHE.*, avec des limites par espace de noms et un suivi des coûts.
Le cache exact ignore la formulation. « Comment réinitialiser mon mot de passe ? » et « J’ai oublié mon mot de passe » sont deux clés différentes.
Cache sémantique
Un cache sémantique recherche le sens de la question. Il transforme la question en embedding, trouve la question stockée la plus proche et renvoie sa réponse si la similarité cosinus dépasse un seuil. Dans HotKV, c’est SCACHE.*, construit sur le même index vectoriel que la recherche vectorielle.
Environ 31 % de nos requêtes ont reçu leur réponse ainsi. Une reformulation a pris une médiane d’environ 130 ms, presque entièrement due à l’appel au service d’embedding. Un succès sémantique est donc bien plus rapide qu’un appel au modèle, sans être instantané. Sans la couche sémantique, un cache exact seul aurait nécessité au plus 1 264 appels au modèle sur 3 000, soit environ 58 % de moins. La couche sémantique a porté l’économie à environ 70 %.
C’est aussi là que se trouve le risque. Une question similaire n’est pas toujours la même question. Nous avons fait juger chaque succès sémantique par un second modèle Claude, face à une réponse fraîche. À notre seuil par défaut de 0,81, les réponses en cache convenaient à la question exacte moins souvent que les réponses fraîches, de 5,8 à 10,7 points de pourcentage. Sur Sonnet 5.5, des seuils de 0,88 et plus n’ont montré aucun écart de ce type, avec des preuves minces. Des questions écrites pour différer par un seul détail décisif correspondaient quand même dans 62 % des cas à 0,81 et dans 10 % des cas à 0,95.
Cache de prompts ou cache sémantique, côte à côte
| Cache de prompts du fournisseur | Cache de réponses exact | Cache sémantique | |
|---|---|---|---|
| Ce qu’il supprime | Une partie du prix d’entrée | L’appel complet au modèle | L’appel complet au modèle |
| Règle de correspondance | Préfixe identique | Requête identique | Sens similaire au-dessus d’un seuil |
| Tokens de sortie facturés | Oui, à chaque fois | Non, en cas de succès | Non, en cas de succès |
| Risque de mauvaise réponse | Aucun | Aucun pour des requêtes identiques | Réel, réglé par le seuil |
| Où il s’exécute | Chez le fournisseur | Dans votre cache | Dans votre cache, plus un appel d’embedding |
| Part des requêtes dans notre exécution | Toujours actif | Environ 39 % | Environ 31 % |
Le cache de prompts du fournisseur et le cache de réponses ne sont pas des alternatives. L’un réduit le prix des appels que vous faites encore, l’autre réduit le nombre d’appels que vous faites.
Ce que le cache change à la latence
Sauter le modèle change la vitesse d’arrivée des réponses autant que leur coût. Dans notre exécution, le temps médian jusqu’à une réponse complète est passé de 2,7 secondes à 127 ms sur Fable 5.1, de 2,9 secondes à 126 ms sur Opus 5.5, de 1,8 seconde à 128 ms sur Sonnet 5.5 et de 1,4 seconde à 125 ms sur Haiku 5.5. Cela représente de 11 à 23 fois plus rapide à la médiane.
L’extrémité lente a à peine bougé. Environ 30 % des requêtes atteignaient encore le modèle, et le 99e centile sur Fable 5.1 était d’environ 6,4 secondes avec HotKV contre 6,6 secondes sans. Un cache supprime l’attente pour les requêtes auxquelles il répond et ne fait rien pour celles qu’il manque. Si votre problème est un pire cas lent plutôt qu’un cas typique lent, le cache seul ne le réglera pas.
Ce sont des temps jusqu’à la réponse complète, car les appels n’étaient pas diffusés en streaming. Une réponse diffusée montre ses premiers mots plus tôt. L’écart dans une fenêtre de chat est plus petit que l’écart de ces chiffres.
Choisir une couche pour votre trafic
La bonne couche dépend de la façon dont vos requêtes se répètent, et vous pouvez le mesurer avant de construire quoi que ce soit.
Adapter la couche au trafic
Adaptez la couche à la façon dont vos requêtes se répètent.
- Un long prompt système ou une liste d’outils stable : utilisez le cache de prompts du fournisseur. Il coûte peu à activer et ne change aucune réponse.
- La même question avec les mêmes mots, comme un bouton, un modèle de texte ou une nouvelle tentative : utilisez un cache de réponses exact. Il est sûr et rapide.
- Le trafic de support, de recherche et de FAQ où l’on pose la même chose avec des mots différents : ajoutez un cache sémantique, réglez le seuil haut, et vérifiez la qualité des réponses sur vos propres questions avant de lui faire confiance.
- Les réponses qui dépendent de l’utilisateur, de l’heure ou de données en direct : ne mettez rien en cache, ou construisez la clé à partir des faits qui changent la réponse.
Les économies suivent la répétition. Quand nous avons rendu chaque intention équiprobable au lieu d’une distribution biaisée, le coût a baissé de 56 % sur les deux modèles que nous avons réexécutés, et avec 3 000 questions toutes différentes, il a baissé de 38 %. Une charge de travail sans question répétée ou similaire n’économise rien.
Mesurez d’abord votre propre répétition
Avant de construire quoi que ce soit, découvrez quelle part de votre trafic se répète. Ce chiffre décide si un cache exact vaut la peine. Cela prend dix minutes avec les questions que vous journalisez déjà. Normalisez chaque question comme le fera votre clé de cache, comptez les questions distinctes, et regardez quelle part du trafic était une répétition.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share est la fraction des requêtes auxquelles un cache exact aurait répondu, une fois qu’il aurait vu chaque question une première fois. Notre jeu de test comptait 1 264 questions distinctes parmi 3 000 requêtes. Le chiffre était donc d’environ 58 %. Si le vôtre tombe autour de 5 %, un cache exact servira à peu de chose, et seule une couche sémantique peut aider.
Deux précautions s’appliquent. Un cache démarre vide, les premières requêtes atteignent donc toujours le modèle. Dans notre exécution, environ 52 % des mille premières requêtes ont été servies depuis le cache, et environ 81 % des mille dernières. Et un journal du trafic du mois dernier ne vous renseigne que sur le mois dernier. Si vous êtes sur le point de lancer une fonctionnalité qui change ce que les gens demandent, prenez ce chiffre comme une indication approximative.
Assembler les couches
Une requête doit traverser les couches de la moins chère et la plus sûre à la plus coûteuse, et vous devez pouvoir voir ce que chacune a économisé.
L’ordre des recherches
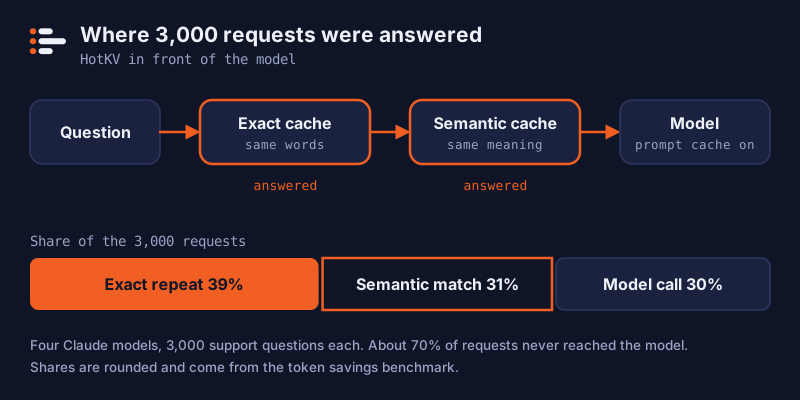
L’ordre compte. Vérifiez d’abord la couche la moins chère et la plus sûre, et n’appelez le modèle que lorsque tout échoue. Cet exemple suppose un client de style redis-py avec decode_responses=True, deux espaces de noms créés au préalable, et vos propres fonctions embed et llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # mêmes mots

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # même sens

    reply = llm.complete(question)                   # le cache de prompts du fournisseur s'applique ici
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Créez les espaces de noms une seule fois avec PCACHE.CREATE answers_exact et SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, en utilisant la dimension de votre modèle d’embedding. Le jeu de commandes d’IA est fourni avec les instances HotKV Cloud Performance et Scale, et la page IA liste ce que fait chaque moteur. La page des tarifs indique quelle offre inclut quoi.
Suivre les chiffres en production
Un cache que vous ne voyez pas est un cache auquel vous ne pouvez pas vous fier. HotKV tient le compte des succès et des échecs par espace de noms. Si vous stockez l’utilisation de tokens de l’appel d’origine avec chaque entrée, il peut aussi attribuer les tokens et le coût que chaque succès ultérieur a évités. Les réponses de PCACHE.STATS et SCACHE.STATS contiennent alors des champs tels que usage_saved_requests, usage_saved_input_tokens et usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Remplacez <model> par l’identifiant de votre modèle. INPUT compte les tokens de prompt non mis en cache et CACHEREAD les tokens que le fournisseur a servis depuis son propre cache. Les deux ne se chevauchent donc pas. Le modèle doit figurer dans la table de prix de HotKV pour que le champ de coût ait un sens. LLMSTATS.PRICE LIST indique quels modèles sont connus, et LLMSTATS.PRICE SET ajoute les vôtres. Un modèle sans prix voit quand même ses tokens comptés, mais son coût est enregistré à zéro et un compteur distinct montre que des requêtes n’ont pas été tarifées.
Les caches réduisent la dépense, et un budget plafonne ce qui reste. LLMBUDGET.SET définit une limite de tokens et de dollars sur une fenêtre de temps. LLMBUDGET.CONSUME est vérifié avant l’appel au modèle, de sorte qu’un agent qui s’emballe est arrêté avant qu’il ne dépense l’argent, et non après. LLMSTATS.RECORD tient des totaux par tenant qui comprennent les tokens de lecture et d’écriture du cache du fournisseur. Les trois utilisent une même table de prix quand vous passez le nom du modèle, si bien qu’une économie, un budget et un chiffre de tableau de bord ne peuvent pas se contredire.
Les erreurs qui font renvoyer de mauvaises réponses par un cache
La plupart des mauvais succès viennent d’une clé à laquelle il manque quelque chose. Mettez le modèle, la version du prompt et toute version d’outil ou de politique dans la clé exacte, afin qu’un changement de prompt ne serve pas des réponses écrites pour l’ancien.
Donnez aux entrées une durée de vie qui correspond à la vitesse à laquelle vos faits changent. Séparez les tenants avec des espaces de noms distincts pour qu’une réponse destinée à un client ne soit jamais proposée à un autre. Ne mettez jamais en cache une réponse qui contient des données personnelles, à moins que la clé n’indique de qui sont ces données.
Enfin, mesurez sur votre propre trafic. Nos chiffres proviennent d’un jeu de données public de courtes questions bancaires, d’une politique fictive et d’une exécution par condition, et ils ne constituent pas une promesse pour votre charge de travail.
Questions fréquentes
Qu’est-ce que le cache de prompts ?
Le cache de prompts est une fonction des fournisseurs de modèles qui conserve pendant une courte durée le début traité d’un prompt. Une requête ultérieure qui commence exactement par le même texte est facturée à un tarif plus bas pour cette partie. Le modèle s’exécute quand même et produit une nouvelle réponse, vous payez donc toujours les tokens de sortie.
Le cache de prompts est-il la même chose que le cache sémantique ?
Non. Le cache de prompts réutilise un préfixe de prompt répété et appelle quand même le modèle. Le cache sémantique renvoie une réponse stockée à une question de sens similaire et saute l’appel au modèle. Ils agissent sur des coûts différents et peuvent être utilisés ensemble.
Le cache de prompts réduit-il le coût des tokens de sortie ?
Non. Il abaisse seulement le prix de la lecture du préfixe mis en cache. Dans notre benchmark, la sortie représentait de 6 % à 9 % des tokens, mais de 73 % à 92 % du coût de référence avec le cache de prompts déjà activé, ce qui explique pourquoi la mise en cache des réponses entières a économisé bien davantage.
Combien de temps le cache de prompts d’Anthropic dure-t-il ?
La durée par défaut est de cinq minutes, prolongée à chaque utilisation de l’entrée. Une option d’une heure existe, avec un prix d’écriture plus élevé. Vérifiez la documentation actuelle, car les limites et les prix changent.
Puis-je utiliser ensemble le cache de prompts et le cache sémantique ?
Oui, et notre benchmark l’a fait. Le cache de prompts du fournisseur est resté activé dans les deux exécutions, et les couches sémantique et exacte se plaçaient devant le modèle. Les succès du cache évitent l’appel, et les échecs profitent toujours du préfixe à tarif réduit.
Quel seuil de similarité un cache sémantique doit-il utiliser ?
Il n’existe pas de valeur universelle. Nous avons choisi 0,81 sur une partition d’entraînement distincte, et sur Sonnet 5.5 les réponses en cache n’ont montré aucun déficit de qualité par rapport aux réponses fraîches à partir de 0,88, avec des preuves minces. Commencez haut, jugez les réponses en cache face aux réponses fraîches sur vos propres questions, et ne baissez le seuil que si la qualité tient.

Poursuivez la conversation
Commentaires
Des questions sur la méthode ? Un résultat différent sur votre matériel ? Partagez ce que vous avez trouvé. Les commentaires sont relus avant leur publication.