

La mémoire d’un agent IA est ce qui lui permet de reporter quelque chose d’une étape, ou d’une session, à la suivante. Un modèle de langage seul ne retient rien entre deux appels. Tout ce qu’il semble retenir a été remis dans le prompt par votre code. La façon dont vous stockez et récupérez cette matière décide de ce que l’agent peut se rappeler, à quelle vitesse et pour quel coût par tour.
En bref. Les agents ont besoin de quatre types de mémoire : une courte fenêtre de conversation, des faits à long terme retrouvés par le sens, un brouillon pour la tâche en cours et un journal de ce qui s’est passé. Chacun a une forme, une durée de vie et une recherche différentes, si bien qu’une table de mémoire unique ne convient bien à aucun d’eux. HotKV stocke les quatre dans un seul moteur en mémoire avec les commandes
AMEM.*. Nous avons mesuré le cache et la recherche vectorielle de HotKV, pas la mémoire d’agent. Cet article explique donc la conception et n’annonce aucun gain de vitesse.
Pourquoi une fenêtre de contexte n’est pas une mémoire
Une fenêtre de contexte est le texte que vous envoyez avec chaque requête. Elle a une limite de taille, vous payez des tokens d’entrée pour tout ce qu’elle contient à chaque tour, et elle disparaît à la fin de la session. On ne peut pas non plus y faire de recherche. Si un agent a besoin d’un fait vieux de trois semaines, coller tout l’historique n’est pas une réponse.
La mémoire est la couche qui décide de ce qui entre ensuite dans la fenêtre. Elle conserve les tours récents et retrouve les quelques faits plus anciens qui comptent. Elle contient l’état de la tâche en cours et enregistre ce que l’agent a fait. Les chercheurs décrivent les agents en termes similaires. Le cadre CoALA de Sumers, Yao, Narasimhan et Griffiths distingue la mémoire de travail des mémoires épisodique, sémantique et procédurale à long terme.
Les quatre types de mémoire d’un agent IA
Les quatre stockages de HotKV couvrent l’essentiel du même terrain, adapté à ce qu’une application doit construire. La mémoire procédurale, le savoir-faire contenu dans le code et les prompts de l’agent, vit normalement dans votre dépôt ou dans un registre de prompts et n’est pas un stockage à part.
Mémoire de conversation
C’est la transcription à court terme d’une session. Les messages portent un rôle (system, user, assistant ou tool). Ils se trouvent dans une fenêtre glissante bornée, de sorte que les tours les plus anciens tombent une fois la limite atteinte. Elle répond à une seule question. Qu’a-t-on dit récemment ? Dans HotKV, ce sont AMEM.CONV.CREATE, AMEM.CONV.APPEND et AMEM.CONV.WINDOW.
Mémoire sémantique
La mémoire sémantique est un savoir à long terme stocké sous forme de faits avec un vecteur d’embedding. L’agent les rappelle par le sens, et non par une clé. Elle repose sur un index vectoriel HNSW, du même type que celui qui alimente la recherche vectorielle. AMEM.SEM.STORE enregistre un fait et AMEM.SEM.RECALL renvoie les meilleures correspondances avec un score de similarité. C’est ici que vont les documents, les préférences des utilisateurs et les corrections apprises.
Mémoire de travail
La mémoire de travail est le brouillon d’une tâche en cours, un ensemble plat de clés et de valeurs rattaché à une session. Elle contient l’étape en cours, le ticket traité ou un résultat partiel. Elle doit disparaître à la fin de la tâche. AMEM.WORK.SET accepte une durée de vie pour exactement cette raison.
Mémoire épisodique
La mémoire épisodique est un journal en ajout seul d’événements horodatés, comme une action effectuée, une observation faite ou une décision prise. Elle permet à un agent, ou à une personne qui le relit, de demander ce qui s’est passé et quand. AMEM.EPIS.LOG écrit un événement et AMEM.EPIS.QUERY les relit par type et par plage de temps.
La mémoire d’agent IA en pratique
Deux choses comptent en pratique. La façon dont vous écrivez dans la mémoire, et ce que vous relisez à chaque tour.
Stocker la mémoire avec des commandes
Voici un agent de support qui traite une conversation. Le texte de politique fictif et les vecteurs de trois nombres ne servent qu’à illustrer. Un vrai modèle d’embedding produit des vecteurs de 768 ou de 1 536 nombres, et vous créez l’espace de noms avec cette dimension.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
À chaque tour, l’agent lit la fenêtre récente et rappelle les quelques faits qui correspondent à la question. Il consulte sa note de travail et construit le prompt à partir de ces éléments. Après avoir agi, il journalise l’événement. Rien dans cette boucle n’a besoin de tout l’historique.
Relire la mémoire à chaque tour
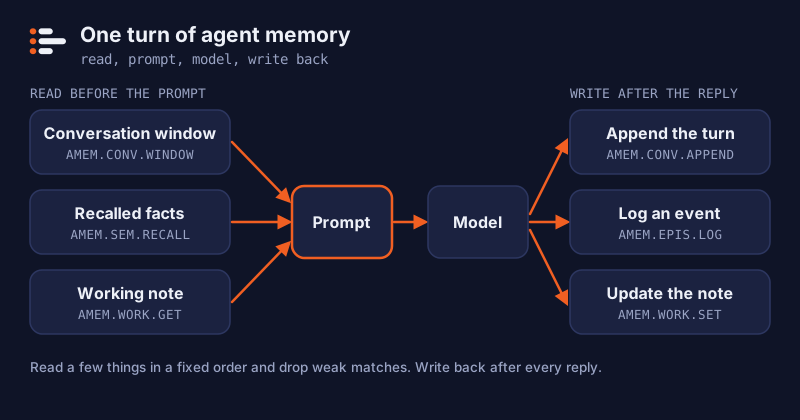
Stocker la mémoire est la moitié facile. Le savoir-faire consiste à décider quoi relire, car tout ce que vous lisez entre dans le prompt et coûte des tokens d’entrée. Une boucle raisonnable lit une poignée d’éléments dans un ordre fixe. Les tours récents d’abord, puis les quelques faits qui correspondent à la question, puis l’état de la tâche. La voici avec le client Python officiel, avec votre propre fonction d’embedding et votre propre modèle de prompt.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # à régler sur vos propres données

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # à créer une seule fois, avant le premier ajout

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # votre modèle de prompt

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
Le seuil de similarité est à vous de le régler. Une valeur qui convient à un modèle d’embedding et à un ensemble de faits sera mauvaise pour un autre, vérifiez donc le rappel sur des questions dont vous connaissez les réponses. Écarter les correspondances faibles compte plus qu’il n’y paraît, car un mauvais fait dans le prompt est pire que pas de fait du tout.
Les parties stables de ce prompt, comme les instructions système, sont aussi celles que le cache de prompts du fournisseur rend moins chères. Placez la mémoire que vous lisez à la fin, après le texte stable, pour que sa modification n’invalide pas ce cache.
Des résumés plutôt que des fenêtres toujours plus longues
Une fenêtre abandonne complètement les anciens tours. C’est acceptable pour une conversation légère et mauvais pour une longue tâche, où le tour 3 peut encore compter au tour 300. Un résumé glissant est la réponse habituelle. Après chaque tranche de conversation, l’agent, ou un modèle moins cher, note ce qui a été appris, et le résumé remplace les anciens tours dans le prompt.
HotKV conserve un résumé par agent avec AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND et AMEM.SUMMARY.GET. SET remplace le texte et APPEND ajoute une ligne. Chaque mise à jour augmente un numéro de version, de sorte qu’un autre composant peut constater à peu de frais que le résumé a changé, et quand.
Un résumé fait perdre de l’information, et résumer un résumé en perd davantage à chaque fois. Gardez les valeurs exactes, comme les identifiants, les montants et les dates, hors de la prose, dans la mémoire de travail ou dans des faits sémantiques, où elles survivent. Utilisez le résumé pour la forme du travail, comme les préférences, les décisions prises et ce qui reste à faire.
Règles de conception et rétention
La mémoire grandit sans limite si vous ne l’arrêtez pas. Fixez donc les limites avant la première écriture.
Règles pour que la mémoire reste utile
- Tout borner. Définissez un
WINDOWsur les conversations et unTTLsur les sessions et les valeurs de travail. Pour les conversations, les valeurs de travail et les faits, HotKV enregistre l’heure d’expiration pour le fichier en ajout seul et pour les réplicas, de sorte qu’une entrée expirée ne revient pas lorsque le fichier est rejoué après un redémarrage. - Stocker des faits, pas des transcriptions. Résumez avant d’écrire dans la mémoire sémantique. Un fait se rappelle plus facilement qu’une page de dialogue.
- Séparer les agents. Utilisez un identifiant ou un espace de noms distinct par agent et par tenant, afin que la mémoire d’un client ne soit jamais rappelée pour un autre.
- Rappeler peu, pas beaucoup. Prenez les trois à cinq meilleures correspondances et écartez les faibles selon leur score de similarité avant qu’elles n’entrent dans le prompt.
- Garder les secrets dehors. La mémoire est relue dans des prompts, ne stockez donc jamais de mots de passe, de clés ou de données que vous ne montreriez pas au modèle.
Combien de temps conserver chaque type
Ces durées sont nos suggestions, pas des valeurs par défaut. Choisissez les vôtres selon la vitesse à laquelle les faits sous-jacents changent et ce que vous avez le droit de conserver.
| Type de mémoire | Durée suggérée | Contrôles dans HotKV |
|---|---|---|
| Conversation | La session, ou une période fixe comme un jour | WINDOW et TTL sur AMEM.CONV.CREATE |
| Travail | La tâche, puis effacée | TTL sur AMEM.WORK.SET, et AMEM.WORK.CLEAR |
| Sémantique | Jusqu’à ce que le fait cesse d’être vrai | TTL sur AMEM.SEM.STORE, et AMEM.SEM.FORGET |
| Épisodique | Aussi longtemps que vos besoins d’audit ou de support l’exigent | AMEM.EPIS.QUERY par plage de temps, et AMEM.EPIS.CLEAR (les événements n’ont pas de durée de vie) |
La rétention est aussi une question de vie privée. Si la mémoire contient quoi que ce soit sur une personne, la durée que vous choisissez fait partie de ce que vous lui promettez. Écrivez-la donc.
Comment la mémoire d’agent tourne mal
La plupart des bugs de mémoire sont lents. L’agent fonctionne bien pendant une semaine, puis commence à se dégrader. Voici les défaillances à prévoir dans la conception.
Défaillances courantes
- Faits périmés. Un fait vrai en mars est rappelé en octobre. Donnez une durée de vie aux faits, ou stockez-les sous une clé par entité afin que la nouvelle valeur écrase l’ancienne.
- Contradictions. Deux faits stockés se contredisent, et l’agent en choisit un au hasard. Préférez un fait par clé plutôt que d’ajouter de nouvelles notes à côté des anciennes.
- Sur-rappel. Trop de correspondances remplissent le prompt de texte vaguement lié. Rappelez peu, et écartez les correspondances faibles.
- Fuites entre utilisateurs. La mémoire d’un client est rappelée pour un autre. Utilisez des identifiants ou des espaces de noms séparés pour chaque tenant, vérifiés dans le code avant chaque lecture.
- Croissance non bornée. Rien n’expire jamais, les recherches ralentissent et les coûts grimpent. Chaque type a besoin d’une durée de vie. Là où HotKV n’a pas de durée de vie, comme pour le journal épisodique, planifiez vous-même un effacement ou un export.
- Dérive du résumé. Un résumé de résumé cesse peu à peu de correspondre à ce qui s’est passé. Gardez le journal d’événements comme source de vérité et régénérez les résumés à partir de lui.
Traitez le texte stocké comme non fiable
Le dernier point mérite plus d’attention. Tout ce qu’un agent écrit dans la mémoire peut être relu plus tard dans un prompt. Cela inclut du texte venu d’une page web, d’un e-mail ou d’un utilisateur. C’est la forme indirecte de l’injection de prompt que l’OWASP classe LLM01. Stockez la source avec chaque fait. Faites moins confiance à la mémoire écrite à partir de contenu extérieur, et ne laissez jamais une note rappelée l’emporter sur votre prompt système.
Ce que nous avons mesuré et ce que nous n’avons pas mesuré
Les benchmarks publiés de HotKV couvrent le débit des commandes, la recherche vectorielle et les économies de tokens du cache de réponses. La mémoire d’agent n’a pas encore de benchmark propre. Nous n’affirmons rien sur sa latence ni sur l’ampleur de son effet sur la qualité de l’agent. Ce que nous pouvons dire relève de l’architecture. Les quatre stockages s’exécutent dans le même processus que le cache et l’index vectoriel. Une recherche en mémoire est un seul appel à un système que vous exploitez déjà.
Le benchmark d’économies de tokens et la comparaison entre cache de prompts et cache sémantique montrent le côté mesuré. Le cas d’usage de la mémoire d’agent présente les commandes dans un scénario complet.
Utiliser la mémoire d’agent depuis Claude Code ou Cursor
Un assistant qui prend en charge le Model Context Protocol peut utiliser une partie de cette mémoire sans code sur mesure. Le serveur open source hotkv-mcp expose comme outils la mémoire de conversation, des notes de travail, un journal d’événements et un résumé glissant. Il dispose d’un mode lecture seule et d’un espace de noms qui confine l’agent. Il n’expose pas la mémoire sémantique, et ses outils ne peuvent pas définir une fenêtre ni une durée de vie. Utilisez donc la bibliothèque cliente pour cela. L’article suivant, un serveur MCP pour la mémoire d’agent, montre comment le connecter et ce que couvrent ses garde-fous.
Questions fréquentes
Qu’est-ce que la mémoire d’agent IA ?
La mémoire d’agent IA est la couche de stockage et de récupération qui permet à un agent de conserver des informations d’une étape et d’une session à l’autre. Elle combine généralement une fenêtre de conversation récente, des faits à long terme retrouvés par le sens, un brouillon pour la tâche en cours et un journal d’événements.
Quelle est la différence entre la mémoire d’agent à court terme et à long terme ?
La mémoire à court terme contient ce qui se passe maintenant, comme les tours récents et l’état de la tâche, et elle est bornée et temporaire. La mémoire à long terme contient le savoir qui doit survivre à une session, comme les faits, les préférences et les événements passés, et elle est interrogée en cas de besoin.
Qu’est-ce qu’un résumé glissant dans la mémoire d’agent ?
Un résumé glissant est une courte description continue de ce qu’un agent a appris ou décidé jusqu’ici, mise à jour au fil du travail. Il remplace les anciens tours dans le prompt, qui ne cesse donc pas de grossir. HotKV en stocke un par agent et augmente un numéro de version à chaque mise à jour.
Ai-je besoin d’une base de données vectorielle pour la mémoire d’agent ?
Seulement pour la mémoire sémantique, où les faits sont retrouvés par le sens. Les fenêtres de conversation, l’état de travail et les journaux d’événements n’ont pas besoin de vecteurs. HotKV garde les quatre dans un seul moteur, si bien que l’index vectoriel et les autres stockages ne sont pas des systèmes séparés.
Combien de temps faut-il conserver la mémoire d’agent ?
Cela dépend du type. La mémoire de travail doit expirer à la fin de la tâche, les conversations après la session ou une période définie, et les journaux épisodiques aussi longtemps que vos besoins d’audit l’exigent. Les faits de la mémoire sémantique doivent être revus et supprimés lorsqu’ils cessent d’être vrais.
La mémoire d’agent peut-elle être attaquée ?
Oui. Le texte écrit dans la mémoire est relu plus tard dans des prompts, de sorte qu’une note empoisonnée peut orienter l’agent. Enregistrez l’origine de chaque fait, faites moins confiance au contenu extérieur, et gardez la mémoire rappelée en dessous de votre prompt système en termes d’autorité.
HotKV stocke-t-il la mémoire d’agent en RAM ?
HotKV est un moteur en mémoire, les lectures sont donc servies depuis la mémoire. Les écritures dans les quatre stockages sont enregistrées pour le fichier en ajout seul et pour les réplicas, avec les heures d’expiration transmises, d’après la documentation du produit.

Poursuivez la conversation
Commentaires
Des questions sur la méthode ? Un résultat différent sur votre matériel ? Partagez ce que vous avez trouvé. Les commentaires sont relus avant leur publication.