Ce benchmark de latence Redis mesure le temps que mettent HotKV, Redis, Valkey et Dragonfly à répondre à un débit de requêtes fixe. Nos benchmarks précédents mesuraient le débit, et un lecteur a fait remarquer à juste titre que le débit ne fait pas tout. Nous avons donc gardé la charge constante, l’avons augmentée palier par palier, et relevé la médiane (p50) et le 99e centile (p99) à chaque palier. Nous avons aussi mesuré le temps de livraison du pub/sub.
En bref. Dans ce benchmark de latence Redis sur AWS, HotKV et Dragonfly ont tous deux tenu 1,6 million de GET par seconde, Redis avec 8 threads d’E/S environ 0,8 million, Valkey avec 8 threads d’E/S environ 0,4 million, et Redis et Valkey à un seul thread environ 0,2 million. De 200 000 à 1,6 million de requêtes par seconde, le p99 de HotKV est resté entre 0,59 et 0,76 ms, contre 0,71 à 1,48 ms pour Dragonfly. À faible charge, les produits multithreads sont à égalité sur le p99, et la livraison pub/sub aussi.
Pourquoi un benchmark de latence Redis à débit fixe
Un test de débit pousse un serveur aussi fort que possible et indique combien il a servi. Cela dit peu de choses sur le temps d’attente d’une requête. Un test de latence fixe le nombre de requêtes par seconde envoyées par les clients et mesure le temps de chacune. Le serveur est alors à la même charge que tout autre produit, et les temps peuvent être comparés.
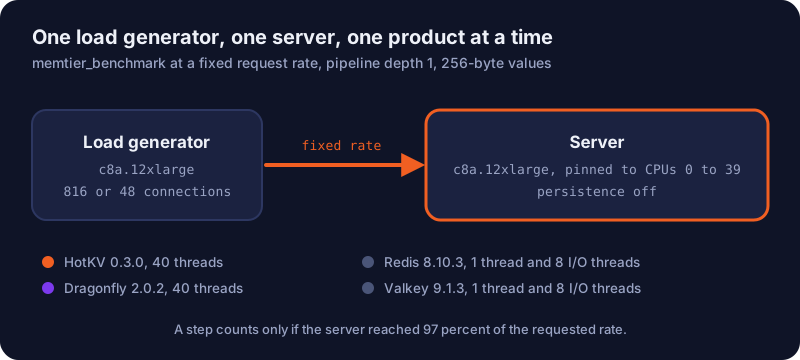
Ce type de test a un piège. memtier_benchmark fonctionne en boucle fermée : un client attend une réponse avant d’envoyer la requête suivante. Si un serveur ne suit pas, le client envoie simplement moins de requêtes, et la latence de celles qu’il a envoyées paraît meilleure qu’elle ne l’est. Nous ne comptons donc un palier comme tenu que si le débit atteint est d’au moins 97 pour cent du débit demandé. Les paliers qui échouent sont marqués « NS » (non tenu) dans les tableaux et leur latence n’est pas affichée.
Ce que nous avons testé
Machines
- Serveurs et générateur de charge. Des instances
c8a.12xlarge(AMD EPYC 9R45, 48 cœurs, sans SMT, 96 Gio, réseau de 22,5 Gbit/s) dans un groupe de placement de cluster AWS en eu-south-2a, sous Ubuntu 24.04. Une instance exécutait le générateur de charge et une autre le serveur. - Un produit à la fois. Chaque produit a tourné seul sur le serveur, donc rien ne se chevauchait et rien ne partageait le réseau. Chaque processus serveur était épinglé sur les CPU 0 à 39, avec la persistance et le mode protégé désactivés.
Produits
- HotKV 0.3.0 avec 40 threads.
- Dragonfly 2.0.2 avec 40 threads proactor.
- Redis 8.10.3 et Valkey 9.1.3, chacun lancé deux fois, une fois avec la configuration par défaut à un seul thread et une fois avec
--io-threads 8.
La ligne de lancement et la sortie en direct de CONFIG GET de chaque exécution sont enregistrées avec ses résultats.
Charge et procédure
Le jeu de données comptait 1 000 000 de clés avec des valeurs de 256 octets, et la profondeur de pipeline était de 1, chaque requête attend donc sa propre réponse. La charge était du GET seul, puis un mélange de 1 écriture pour 10 lectures. Chaque palier a duré 20 secondes, deux fois, et nous donnons la moyenne des deux exécutions. memtier_benchmark a utilisé une limite de débit par connexion et enregistré un histogramme HDR. Nous avons testé deux nombres de connexions.
- 816 connexions (24 threads de 34 connexions), pour des débits de 20 000 à 2,4 millions de requêtes par seconde.
- 48 connexions (4 threads de 12 connexions), pour des débits jusqu’à 300 000 requêtes par seconde. Au-delà, 48 connexions ne peuvent pas atteindre le débit, car chaque connexion ne peut envoyer qu’aussi vite qu’elle reçoit des réponses.
Résultats
Les tableaux GET viennent d’abord, un par nombre de connexions, puis le pub/sub.
Avec 816 connexions
Chaque cellule indique p50 / p99 en millisecondes, pour GET. « NS » signifie non tenu, et le débit réellement atteint figure entre parenthèses. Un tiret signifie que le balayage de ce produit s’était déjà arrêté.
| Requêtes/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 threads d’E/S | Valkey 1 thread | Valkey 8 threads d’E/S |
|---|---|---|---|---|---|---|
| 19 584 | 0,38 / 1,81 | 0,48 / 1,90 | 1,63 / 5,29 | 0,68 / 2,07 | 1,59 / 5,13 | 0,76 / 2,63 |
| 99 552 | 0,24 / 0,76 | 0,27 / 1,76 | 2,60 / 5,12 | 0,40 / 0,98 | 2,65 / 5,13 | 1,71 / 3,19 |
| 199 920 | 0,25 / 0,59 | 0,25 / 1,34 | 2,91 / 5,60 | 0,55 / 1,11 | 3,02 / 5,81 | 1,11 / 2,15 |
| 399 840 | 0,27 / 0,63 | 0,27 / 1,48 | NS (258k) | 0,62 / 1,23 | NS (259k) | 1,24 / 1,49 |
| 799 680 | 0,28 / 0,75 | 0,28 / 1,26 | - | 0,68 / 1,18 | - | NS (670k) |
| 1 199 520 | 0,28 / 0,67 | 0,28 / 1,05 | - | NS (1 078k) | - | - |
| 1 599 360 | 0,28 / 0,64 | 0,28 / 0,71 | - | - | - | - |
| 2 399 856 | NS (2 284k) | NS (2 281k) | - | - | - | - |
La charge mixte a donné la même image. Le p99 de HotKV était de 0,54 à 0,75 ms de 200 000 à 1,6 million de requêtes par seconde, et les paliers que chaque produit pouvait tenir étaient les mêmes qu’avec GET. Tout figure dans le dossier de résultats.
Comment lire les lignes à un seul thread
Les médianes de 1,6 à 3 ms de Redis et Valkey à un seul thread avec 816 connexions ne sont pas leur latence en régime établi. Avec une limite de débit, memtier_benchmark fait partir les 816 connexions au même instant. Un serveur à un seul thread doit traiter cette rafale de 816 requêtes l’une après l’autre, si bien que la médiane d’une requête inclut sa place dans la file. Nous avons réalisé le test à 48 connexions ci-dessous pour supprimer cet effet.
Avec 48 connexions
Les cellules ont la même signification que ci-dessus, pour GET seulement.
| Requêtes/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 threads d’E/S | Valkey 1 thread | Valkey 8 threads d’E/S |
|---|---|---|---|---|---|---|
| 9 984 | 0,14 / 0,54 | 0,14 / 0,37 | 0,21 / 0,89 | 0,17 / 0,92 | 0,21 / 0,91 | 0,20 / 0,81 |
| 49 968 | 0,10 / 0,28 | 0,11 / 0,28 | 0,21 / 0,41 | 0,13 / 0,28 | 0,21 / 0,43 | 0,21 / 0,44 |
| 99 984 | 0,09 / 0,28 | 0,10 / 0,28 | 0,20 / 0,40 | 0,13 / 0,28 | 0,20 / 0,38 | 0,19 / 0,35 |
| 199 968 | 0,08 / 0,27 | 0,08 / 0,27 | 0,20 / 0,35 | 0,10 / 0,27 | 0,21 / 0,36 | 0,11 / 0,28 |
| 300 000 | 0,08 / 0,27 | 0,08 / 0,27 | NS (231k) | 0,09 / 0,26 | NS (233k) | 0,09 / 0,26 |
Temps de livraison du pub/sub
Nous avons mesuré le temps entre une publication et sa livraison à un abonné, avec 64 éditeurs, 100 abonnés et une charge utile de 128 octets, à l’aide de pubsub-sub-bench. Chaque message allait à un seul abonné. Les cellules indiquent p50 / p99 en millisecondes.
| Livraisons/s | HotKV | Dragonfly | Redis 1 thread | Redis 8 threads d’E/S | Valkey 1 thread | Valkey 8 threads d’E/S |
|---|---|---|---|---|---|---|
| environ 21 000 | 0,10 / 0,71 | 0,10 / 0,65 | 0,11 / 0,74 | 0,11 / 0,62 | 0,11 / 0,76 | 0,12 / 0,78 |
| environ 107 000 | 0,10 / 1,02 | 0,12 / 0,92 | 0,10 / 0,80 | 0,11 / 0,63 | 0,10 / 0,82 | 0,10 / 0,86 |
| environ 215 000 | 0,11 / 1,20 | 0,13 / 1,13 | 0,51 / 1,03 | 0,20 / 0,73 | 0,57 / 1,07 | 0,12 / 1,22 |
Tous les produits ont livré dans la même plage. À la charge la plus élevée, les produits à un seul thread avaient une médiane plus haute, 0,51 et 0,57 ms contre 0,11 ms pour HotKV.
Nous avons aussi dû corriger pubsub-sub-bench. L’outil comparait un temps de publication en millisecondes à un temps de réception en microsecondes. Le correctif est dans le dossier de résultats.
Ce que montrent les résultats
Les tableaux montrent une avance de HotKV et Dragonfly à forte charge, une égalité à faible charge et un plafond pour Redis et Valkey à un seul thread.
HotKV et Dragonfly ont gardé une queue basse jusqu’à 1,6 million de requêtes par seconde
Tous deux ont tenu 1,6 million de GET par seconde à 816 connexions, avec une médiane de 0,28 ms. Le p99 de HotKV était compris entre 0,59 et 0,76 ms à partir de 200 000 requêtes par seconde. Celui de Dragonfly était compris entre 0,71 et 1,48 ms, et les deux étaient proches à 1,6 million (0,64 contre 0,71 ms). Redis et Valkey avec threads d’E/S ont cessé de tenir le débit à des charges plus basses, et Redis et Valkey à un seul thread vers 260 000.
À faible charge, les produits multithreads sont à égalité
Avec 48 connexions, jusqu’à 300 000 requêtes par seconde, HotKV, Dragonfly et Redis avec 8 threads d’E/S ont tous eu un p99 d’environ 0,27 ms. HotKV avait la médiane la plus basse, de 0,08 à 0,09 ms à partir de 100 000 requêtes par seconde, Dragonfly se situant entre 0,08 et 0,10 ms. Un écart de 0,01 ms reste dans ce que d’autres éléments du dispositif peuvent causer, nous n’en faisons donc pas une victoire.
Redis et Valkey à un seul thread ont atteint leur limite vers 230 000 par seconde
Avec 48 connexions, ils avaient une médiane d’environ 0,2 ms et un p99 de 0,35 à 0,43 ms, et n’ont pas tenu 300 000 requêtes par seconde (environ 231 000 et 233 000). C’est le plafond d’un seul thread sur ce matériel et cette charge. C’est pourquoi Redis et Valkey sont généralement exécutés en de nombreux processus ou en cluster, comme dans notre benchmark de cluster.
Limites
Ce sont des mesures de HotKV Ltd sur les versions et la configuration ci-dessus. Elles ne valent pas pour une autre version, une autre configuration ou une autre charge de ces produits.
Le dispositif de test
- Un serveur, un générateur de charge. Deux répétitions par palier, sur un seul jeu de machines à une seule date. Nous n’avons pas mesuré la variation entre machines ou entre jours.
- Configurations choisies par nous. Redis et Valkey ont tourné avec leur configuration par défaut à un seul thread et avec
--io-threads 8, et nous n’avons réglé aucun des deux au-delà. D’autres réglages pourraient modifier leurs chiffres. Si vous pensez qu’un réglage ici désavantage un produit, dites-le-nous et nous le vérifierons et publierons le résultat. - L’effet de rafale de l’outil. À 816 connexions, les médianes des produits à un seul thread sont gonflées par le fonctionnement de la limite de débit de
memtier_benchmark, comme expliqué plus haut.
Ce qui n’a pas été mesuré
- Données. Valeurs plus grandes ou déséquilibrées, mémoire par clé et persistance. La persistance était désactivée sur tous les serveurs.
- Modes. Mode cluster, pub/sub partitionné, TLS, réplication et bascule.
- Fan-out pub/sub. Un message vers de nombreux abonnés.
Redis, Valkey et Dragonfly sont des marques de leurs détenteurs respectifs. Ils ne sont nommés que pour identifier le logiciel mesuré, et cela n’implique ni parrainage, ni approbation, ni affiliation.
Reproduisez-le
Les scripts de balayage, la ligne de lancement et la configuration en direct de chaque serveur, le correctif de pubsub-sub-bench et tous les résultats bruts se trouvent dans le dépôt de benchmarks. Le script de latence est harness/lat_sweep.sh et celui du pub/sub est harness/ps_sweep.sh. Le dossier raw contient une archive par test avec le JSON de memtier_benchmark, les histogrammes HDR et l’utilisation du CPU du serveur pour chaque exécution.
Essayez-le vous-même
HotKV Cloud exécute HotKV pour vous. Démarrez sur HotKV Cloud ou parlez aux ventes pour comparer HotKV à votre propre charge.
Questions fréquentes
HotKV est-il plus rapide que Redis en latence ?
Sous charge, aux débits testés, oui. Avec 816 connexions et 200 000 requêtes par seconde, HotKV avait un p99 de 0,59 ms, Redis avec 8 threads d’E/S 1,11 ms et Redis à un seul thread 5,60 ms. À faible charge avec 48 connexions, les produits multithreads étaient à égalité sur le p99, à environ 0,27 ms.
Pourquoi avoir fixé le débit de requêtes ?
À débit fixe, chaque produit porte la même charge, et les latences peuvent donc être comparées. Un test de débit montre combien un serveur sert à sa limite, ce qui dit peu de choses sur le temps d’attente d’une requête.
Que signifie « non tenu » ?
Le produit a atteint moins de 97 pour cent du débit de requêtes demandé. memtier_benchmark fonctionne en boucle fermée : un serveur surchargé fait envoyer moins de requêtes aux clients, et la latence des requêtes restantes paraît meilleure qu’elle ne l’est. Nous n’affichons aucune latence pour ces paliers.
Comment le temps de livraison pub/sub se compare-t-il ?
Aux trois charges testées, tous les produits ont livré dans la même plage, avec une médiane d’environ 0,1 ms aux deux charges les plus basses. Le tableau ci-dessus donne chaque valeur.
Puis-je reproduire ce benchmark de latence Redis ?
Oui. Les scripts, les configurations et tous les résultats bruts sont dans le dépôt de benchmarks. Il vous faut deux serveurs sur le même réseau, un générateur de charge et les quatre produits.
Poursuivez la conversation
Commentaires
Des questions sur la méthode ? Un résultat différent sur votre matériel ? Partagez ce que vous avez trouvé. Les commentaires sont relus avant leur publication.