
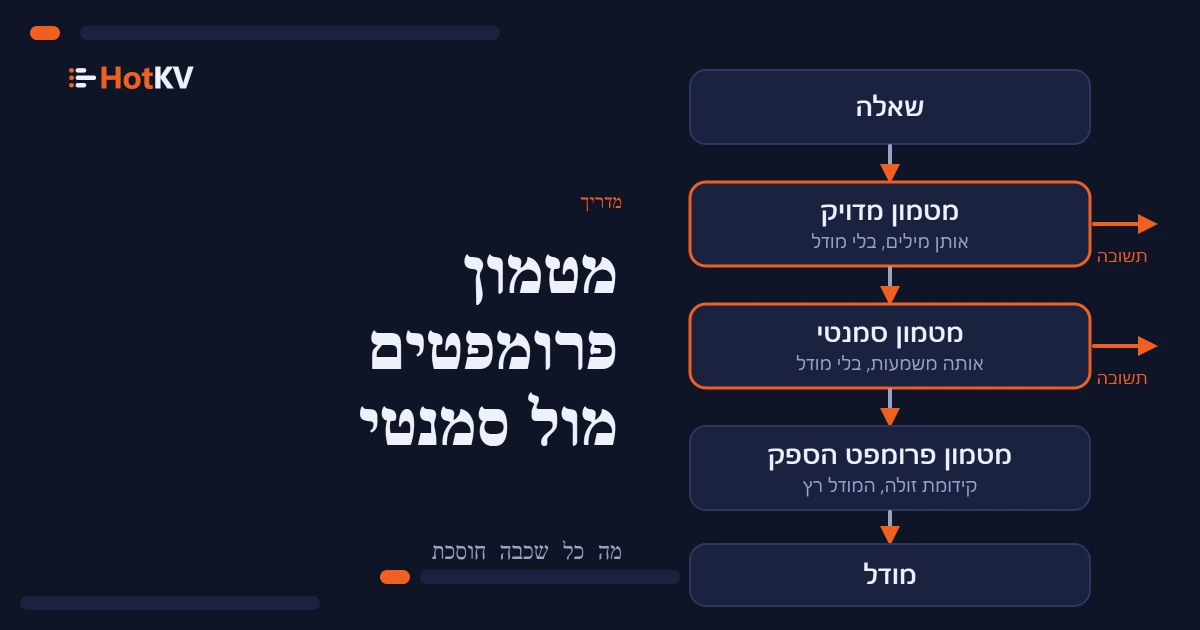
שני דברים שונים נמכרים כמטמון למודלי שפה, וצוותים קונים באופן קבוע אחד מהם ומצפים לשני. מטמון פרומפטים הוא יכולת של הספק שמוזילה את קריאת תחילית פרומפט חוזרת. מטמון סמנטי הוא שכבה שאתם מפעילים בעצמכם ועונה על שאלה מהזיכרון כך שהמודל לא נקרא בכלל. הם פותרים חצאים שונים של החשבון, והם עובדים הכי טוב יחד.
בקצרה. מטמון פרומפטים נותן הנחה על תחילת הפרומפט החוזרת, כמו הנחיית מערכת ארוכה, אבל המודל עדיין רץ ואתם עדיין משלמים על כל טוקן פלט. מטמון מדויק וסמנטי מבטלים את הקריאה לגמרי כששאלה כבר נענתה. בבדיקה שלנו של 3,000 בקשות, כשמטמון הפרומפטים של הספק כבר פעיל, הוספת HotKV לפניו קיצצה את הקריאות למודל, הטוקנים והעלות בכ-70%, כי טוקני הפלט עדיין היו 73% עד 92% מעלות קו הבסיס.
איך עובד מטמון פרומפטים
מטמון פרומפטים חי אצל ספק המודל. מסמנים את תחילת הבקשה היציבה, בדרך כלל הכלים והנחיית המערכת, והספק שומר את הצורה המעובדת שלה לזמן קצר. הבקשה הבאה שמתחילה בטקסט זהה מחויבת בתעריף מופחת על החלק הזה. אנו מתארים כאן את הגרסה של Anthropic כי זו שמדדנו. הפרטים להלן באים מתיעוד מטמון הפרומפטים שלה, שנבדק ב-18 באוקטובר 2026.
מה נשמר במטמון
פגיעה דורשת התאמה מדויקת. כל בלוק עד לבלוק שסימנתם ב-cache_control ובכלל זה חייב להיות זהה, בסדר כלים, הנחיית מערכת ואז הודעות. משנים תו אחד בתחילת הפרומפט וכל מה שאחריו הוא החטאה. השאלה עצמה באה אחרונה, ולכן אינה חלק מהתחילית השמורה.
פרומפטים מתחת לאורך מינימלי לא נשמרים ולא מוחזרת שגיאה. עבור מודלי Claude הנוכחיים שבהם השתמשנו, Fable 5.1, Opus 5.5, Sonnet 5.5 ו-Haiku 5.5, המינימום המתועד הוא 512 טוקנים. רשומות המטמון מבודדות לכל ארגון, ולכל סביבת עבודה ב-Claude API.
כמה זה עולה
אורך החיים כברירת מחדל הוא חמש דקות, וכל שימוש ברשומה מרענן אותה ללא חיוב נוסף. זמין גם אורך חיים של שעה. כתיבת רשומה עולה פי 1.25 ממחיר הקלט הבסיסי לחמש דקות ופי 2 לשעה. קריאתה עולה פי 0.1 ממחיר הקלט הבסיסי ברוב המודלים, פי 0.05 ב-Opus 5.5 וב-Sonnet 5.5, ופי 0.025 ב-Fable 5.1, לפי עמוד התמחור. המכפילים האלה משתנים, ולכן קראו את העמוד העדכני לפני כל חישוב.
מה מטמון פרומפטים לא יכול להסיר
מטמון פרומפטים נותן הנחה על קריאת התחילית. הוא לא מדלג על המודל. כל בקשה עדיין מייצרת תשובה חדשה, אתם עדיין ממתינים לה, וכל טוקן פלט מחויב במחיר הפלט המלא.
מדד הביצועים שלנו מראה עד כמה זה חשוב. שלחנו 3,000 שאלות תמיכת לקוחות לכל אחד מארבעה מודלי Claude, עם מדיניות של 2,200 טוקנים כהנחיית המערכת ומטמון הספק פעיל. בין 90% ל-93% מהטוקנים שנספרו היו קריאות מטמון של המדיניות הזו. הפלט היה רק 6% עד 9% מהטוקנים, ובכל זאת היה 73% עד 92% מעלות קו הבסיס. התחילית כבר הייתה זולה, ולכן ההוצאה שנותרה ישבה בתשובות.
זה הפער שהשכבות האחרות ממלאות. השיטה המלאה והתוצאות נמצאות במדד חיסכון הטוקנים.
מטמון תשובות מדויק וסמנטי
שתי שכבות עונות על בקשה מהזיכרון. הן נבדלות באופן שבו הן מחליטות שבקשה חדשה תואמת ישנה.
מטמון תשובות מדויק
מטמון מדויק שומר את התשובה הסופית תחת מפתח שנבנה מכל מה שמעצב אותה. בדרך כלל זה המודל, גרסת הפרומפט והשאלה המנורמלת. כשאותה בקשה מגיעה שוב, התשובה השמורה מוחזרת והמודל לא נקרא. אין ציון דמיון ואין סיכון להחזיר תשובה שנועדה לשאלה אחרת.
בהרצה שלנו, המטמון המדויק ענה על כ-39% מהבקשות. שאלה חוזרת חזרה בחציון של כ-0.05 ms. זה נמדד עם לקוח Python על loopback באותה מכונה, ולכן יש לקרוא זאת כמספר מקומי ולא כמספר רשת. מדד הביצועים השתמש ב-GET וב-SET פשוטים לשכבה הזו. ל-HotKV Enterprise יש גם מטמון פרומפטים ייעודי בהתאמה מדויקת, PCACHE.*, עם מגבלות לכל מרחב שמות ומעקב עלויות.
מטמון מדויק עיוור לניסוח. "How do I reset my password?" ו-"I forgot my password" הם שני מפתחות שונים.
מטמון סמנטי
מטמון סמנטי מחפש את המשמעות של השאלה. הוא הופך את השאלה ל-embedding, מוצא את השאלה השמורה הקרובה ביותר ומחזיר את התשובה שלה אם דמיון הקוסינוס עובר סף. ב-HotKV זה SCACHE.*, שנבנה על אותו אינדקס וקטורי כמו החיפוש הווקטורי.
כ-31% מהבקשות שלנו נענו כך. ניסוח אחר לקח חציון של כ-130 ms, כמעט כולו הקריאה לשירות ה-embedding, ולכן פגיעה סמנטית מהירה בהרבה מקריאה למודל אבל לא מיידית. בלי השכבה הסמנטית, מטמון מדויק לבדו היה צריך לכל היותר 1,264 קריאות למודל מתוך 3,000, כ-58% פחות. השכבה הסמנטית הביאה את החיסכון לכ-70%.
כאן גם נמצא הסיכון. שאלה דומה אינה תמיד אותה שאלה. נתנו למודל Claude שני לשפוט כל פגיעה סמנטית מול תשובה טרייה. בסף ברירת המחדל שלנו, 0.81, תשובות מהמטמון התאימו לשאלה המדויקת בתדירות נמוכה ב-5.8 עד 10.7 נקודות אחוז מתשובות טריות. ב-Sonnet 5.5, ספים של 0.88 ומעלה לא הראו חסר כזה, עם ראיות דלות. שאלות שנכתבו להיות שונות בפרט מכריע אחד עדיין הותאמו ב-62% מהמקרים ב-0.81 וב-10% ב-0.95.
מטמון פרומפטים מול מטמון סמנטי זה לצד זה
| מטמון פרומפטים של הספק | מטמון תשובות מדויק | מטמון סמנטי | |
|---|---|---|---|
| מה הוא מסיר | חלק ממחיר הקלט | את כל הקריאה למודל | את כל הקריאה למודל |
| כלל ההתאמה | תחילית זהה | בקשה זהה | משמעות דומה מעל סף |
| טוקני פלט מחויבים | כן, בכל פעם | לא, בפגיעה | לא, בפגיעה |
| סיכון לתשובה שגויה | אין | אין בבקשות זהות | אמיתי, מכוונן על ידי הסף |
| איפה הוא רץ | אצל הספק | במטמון שלכם | במטמון שלכם, בתוספת קריאת embedding |
| חלק הבקשות בהרצה שלנו | תמיד פעיל | כ-39% | כ-31% |
מטמון פרומפטים של הספק ומטמון תשובות אינם חלופות. אחד מוזיל את מחיר הקריאות שאתם עדיין מבצעים, והשני מקטין את מספר הקריאות שאתם מבצעים.
מה מטמון עושה להשהיה
דילוג על המודל משנה את מהירות הגעת התשובות ולא רק את מה שהן עולות. בהרצה שלנו הזמן החציוני לתשובה מלאה ירד מ-2.7 שניות ל-127 ms ב-Fable 5.1, מ-2.9 שניות ל-126 ms ב-Opus 5.5, מ-1.8 שניות ל-128 ms ב-Sonnet 5.5 ומ-1.4 שניות ל-125 ms ב-Haiku 5.5. זה מהיר פי 11 עד פי 23 בחציון.
הקצה האיטי כמעט לא זז. כ-30% מהבקשות עדיין הגיעו למודל, והאחוזון ה-99 ב-Fable 5.1 היה כ-6.4 שניות עם HotKV מול 6.6 שניות בלעדיו. מטמון מסיר את ההמתנה בבקשות שהוא עונה עליהן ולא עושה דבר לאלה שהוא מחטיא. אם התלונה שלכם היא על מקרה גרוע איטי ולא על מקרה טיפוסי איטי, מטמון לבדו לא יתקן אותה.
אלה זמנים עד התשובה המלאה, כי הקריאות לא הוזרמו. תשובה מוזרמת מראה את המילים הראשונות שלה מוקדם יותר. הפער בחלון צ'אט קטן מהפער במספרים האלה.
בוחרים שכבה לתעבורה שלכם
השכבה הנכונה תלויה באופן שבו הבקשות שלכם חוזרות, ואפשר למדוד זאת לפני שבונים משהו.
מתאימים את השכבה לתעבורה
מתאימים את השכבה לאופן שבו הבקשות שלכם חוזרות.
- הנחיית מערכת ארוכה ויציבה או רשימת כלים: משתמשים במטמון פרומפטים של הספק. הפעלתו זולה והוא לא משנה תשובות.
- אותה שאלה באותן מילים, כמו כפתור, תבנית או ניסיון חוזר: משתמשים במטמון תשובות מדויק. הוא בטוח ומהיר.
- תעבורת תמיכה, חיפוש ושאלות נפוצות שבה אנשים שואלים אותו דבר במילים שונות: מוסיפים מטמון סמנטי, קובעים סף גבוה ובודקים את איכות התשובות על השאלות שלכם לפני שסומכים עליו.
- תשובות שתלויות במשתמש, בשעון או בנתונים חיים: לא שומרים אף אחת מהן במטמון, או מפתחים את המטמון לפי העובדות ששוללות את התשובה.
החיסכון עוקב אחר חזרתיות. כשהפכנו כל כוונה לסבירה באותה מידה במקום מוטה, העלות ירדה 56% בשני המודלים שהרצנו מחדש, ועם 3,000 שאלות שונות כולן היא ירדה 38%. עומס עבודה ללא שאלות חוזרות או דומות לא חוסך דבר.
מודדים קודם את החזרתיות שלכם
לפני שבונים משהו, בדקו כמה מהתעבורה שלכם חוזרת. המספר מחליט אם מטמון מדויק שווה את המאמץ. זה לוקח עשר דקות עם השאלות שאתם כבר רושמים ביומן. מנרמלים כל שאלה כמו שמפתח המטמון שלכם ינרמל אותה, סופרים את הנפרדות ורואים כמה מהתעבורה הייתה חזרה.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share הוא חלק הבקשות שמטמון מדויק היה עונה עליהן, אחרי שראה כל שאלה בפעם הראשונה. בסט הבדיקה שלנו היו 1,264 שאלות נפרדות מתוך 3,000 בקשות, ולכן המספר היה כ-58%. אם אצלכם יוצא קרוב ל-5%, מטמון מדויק יעשה מעט, ורק שכבה סמנטית יכולה לעזור.
שתי הסתייגויות חלות. מטמון מתחיל ריק, ולכן הבקשות הראשונות תמיד מגיעות למודל. בהרצה שלנו כ-52% מהאלף הראשון של הבקשות הוגשו מהמטמון וכ-81% מהאלף האחרון. ויומן של התעבורה בחודש שעבר מספר לכם על חודש שעבר. אם אתם עומדים להשיק יכולת שמשנה מה אנשים שואלים, התייחסו למספר כאל קירוב.
משלבים את השכבות
בקשה צריכה לעבור בשכבות מהזולה והבטוחה ביותר ליקרה ביותר, ואתם צריכים לראות מה כל אחת חסכה.
סדר החיפוש
הסדר חשוב. בודקים קודם את השכבה הזולה והבטוחה ביותר וקוראים למודל רק כשהכול מחטיא. הקטע הזה מניח לקוח בסגנון redis-py עם decode_responses=True, שני מרחבי שמות שנוצרו מראש, ופונקציות embed ו-llm משלכם.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # same words

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # same meaning

    reply = llm.complete(question)                   # provider prompt caching applies here
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
יוצרים את מרחבי השמות פעם אחת עם PCACHE.CREATE answers_exact ו-SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, עם הממד של מודל ה-embedding שלכם. ערכת פקודות ה-AI כלולה במופעי Performance ו-Scale ב-HotKV Cloud, ועמוד ה-AI מפרט מה כל מנוע עושה. עמוד התמחור מראה איזו תוכנית כוללת מה.
שומרים על ספירה בייצור
מטמון שאי אפשר לראות הוא מטמון שאי אפשר לסמוך עליו. HotKV שומר ספירות פגיעה והחטאה לכל מרחב שמות. אם שומרים עם כל רשומה את שימוש הטוקנים של הקריאה המקורית, הוא יכול גם לשייך את הטוקנים והעלות שכל פגיעה מאוחרת יותר מנעה. תשובות PCACHE.STATS ו-SCACHE.STATS נושאות אז שדות כמו usage_saved_requests, usage_saved_input_tokens ו-usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
מחליפים את <model> במזהה המודל שלכם. INPUT סופר את טוקני הפרומפט שלא נשמרו במטמון ו-CACHEREAD את הטוקנים שהספק הגיש ממטמון משלו, ולכן שניהם לא חופפים. המודל חייב להיות בטבלת המחירים של HotKV כדי ששדה העלות יהיה בעל משמעות. LLMSTATS.PRICE LIST מראה אילו מודלים מוכרים, ו-LLMSTATS.PRICE SET מוסיף משלכם. למודל בלי מחיר עדיין נספרים הטוקנים, אך העלות שלו נרשמת כאפס ומונה נפרד מראה שבקשות נותרו ללא תמחור.
מטמונים מקטינים הוצאה, ותקציב חוסם את מה שנשאר. LLMBUDGET.SET מגדיר מגבלת טוקנים ודולרים על פני חלון זמן. LLMBUDGET.CONSUME נבדק לפני הקריאה למודל, כך שסוכן שיצא משליטה נעצר לפני שהוא מוציא את הכסף ולא אחרי. LLMSTATS.RECORD שומר סכומים לכל דייר שמבינים טוקני קריאה וכתיבה למטמון של הספק. שלושתם משתמשים בטבלת מחירים אחת כשמעבירים את שם המודל, כך שחיסכון, תקציב ומספר בלוח מחוונים לא יכולים להיות סותרים.
טעויות שגורמות למטמון להחזיר תשובות שגויות
רוב הפגיעות הגרועות במטמון באות ממפתח שחסר בו משהו. שימו את המודל, גרסת הפרומפט וכל גרסת כלי או מדיניות במפתח המדויק, כך ששינוי פרומפט לא יוכל להגיש תשובות שנכתבו לישן.
תנו לרשומות אורך חיים שמתאים לקצב שבו העובדות שלכם משתנות. הפרידו בין דיירים עם מרחבי שמות נפרדים כדי שתשובה של לקוח אחד לא תוצע לאחר. לעולם אל תשמרו במטמון תשובה שמכילה מידע אישי אלא אם המפתח כולל של מי המידע.
לבסוף, מדדו על התעבורה שלכם. המספרים שלנו באים ממערך נתונים ציבורי אחד של שאלות בנקאיות קצרות, מדיניות בדיונית והרצה אחת לכל תנאי, והם אינם הבטחה לעומס העבודה שלכם.
שאלות נפוצות
מהו מטמון פרומפטים?
מטמון פרומפטים הוא יכולת של ספק מודלים ששומרת את תחילת הפרומפט המעובדת לזמן קצר. בקשה מאוחרת יותר שמתחילה באותו טקסט בדיוק מחויבת בתעריף נמוך יותר על החלק הזה. המודל עדיין רץ ומייצר תשובה חדשה, ולכן אתם עדיין משלמים על טוקני פלט.
האם מטמון פרומפטים זהה למטמון סמנטי?
לא. מטמון פרומפטים משתמש שוב בתחילית פרומפט חוזרת ועדיין קורא למודל. מטמון סמנטי מחזיר תשובה שמורה לשאלה בעלת משמעות דומה ומדלג על הקריאה למודל. הם מטפלים בעלויות שונות ואפשר להשתמש בהם יחד.
האם מטמון פרומפטים מקטין את עלות טוקני הפלט?
לא. הוא מוריד רק את מחיר קריאת התחילית השמורה. במדד הביצועים שלנו הפלט היה 6% עד 9% מהטוקנים אבל 73% עד 92% מעלות קו הבסיס כשמטמון הפרומפטים כבר פעיל, ולכן שמירת תשובות שלמות במטמון חסכה הרבה יותר.
כמה זמן נשמר מטמון הפרומפטים של Anthropic?
ברירת המחדל היא חמש דקות, שמתרעננות בכל פעם שהרשומה בשימוש. זמינה גם אפשרות של שעה במחיר כתיבה גבוה יותר. בדקו את התיעוד העדכני, כי מגבלות ומחירים משתנים.
האם אפשר להשתמש במטמון פרומפטים ובמטמון סמנטי יחד?
כן, ומדד הביצועים שלנו עשה בדיוק את זה. מטמון הפרומפטים של הספק נשאר פעיל בשתי ההרצות, והשכבות הסמנטית והמדויקת ישבו לפני המודל. פגיעות במטמון מדלגות על הקריאה, וההחטאות עדיין נהנות מהתחילית המוזלת.
באיזה סף דמיון כדאי להשתמש במטמון סמנטי?
אין ערך אוניברסלי. בחרנו 0.81 על חלוקת אימון נפרדת, וב-Sonnet 5.5 תשובות מהמטמון לא הראו חסר איכות מול תשובות טריות מ-0.88 ומעלה, עם ראיות דלות. מתחילים גבוה, שופטים תשובות מהמטמון מול תשובות טריות על השאלות שלכם, ומורידים את הסף רק אם האיכות נשמרת.
ממשיכים את השיחה
תגובות
שאלות על השיטה? תוצאה אחרת על החומרה שלכם? שתפו את מה שמצאתם. התגובות נבדקות לפני שהן מופיעות.