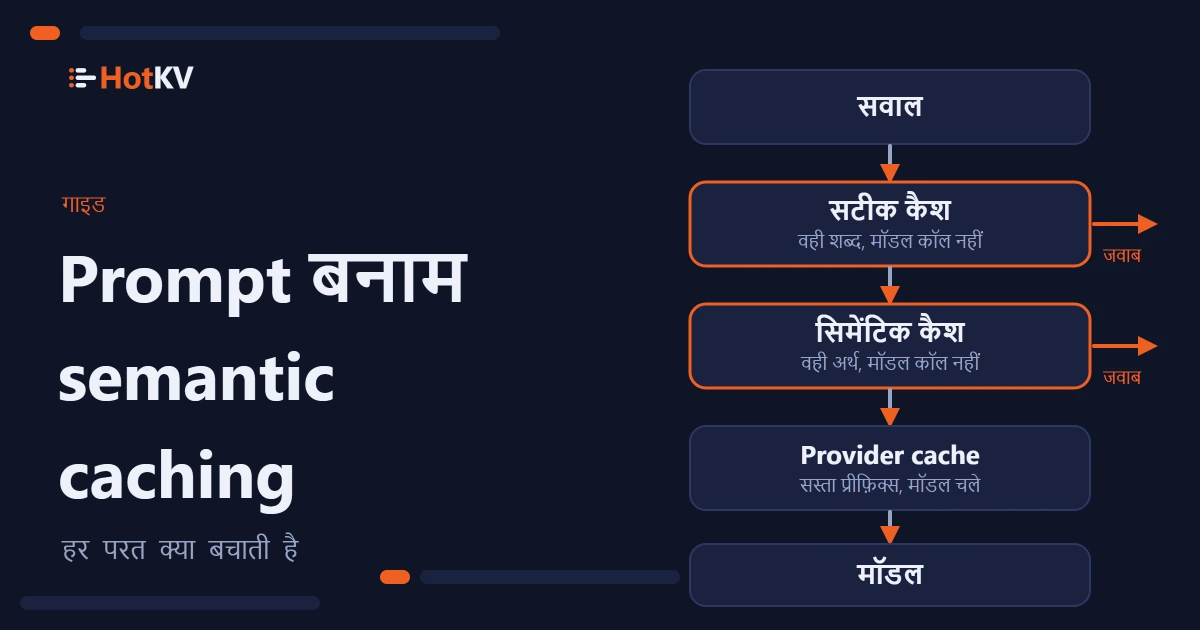
Prompt caching बनाम semantic caching: कौन क्या बचाता है
Prompt caching दोहराए गए prefix को सस्ता करता है, semantic caching मॉडल कॉल हटा देता है। दोनों कैसे काम करते हैं, हमने क्या मापा और कब कौन सा चुनें।
टैग
HotKV के साथ मापी गई API लागत और टोकन बचत, जिसमें कीमतों की मान्यताएँ, वर्कलोड के प्रति संवेदनशीलता और अनुमान बढ़ाने की सीमाएँ शामिल हैं।
2 लेख लागत अनुकूलन में
Prompt caching दोहराए गए prefix को सस्ता करता है, semantic caching मॉडल कॉल हटा देता है। दोनों कैसे काम करते हैं, हमने क्या मापा और कब कौन सा चुनें।
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
अपनी जिज्ञासा के पीछे चलें