टैग

LLM

इंजीनियरिंग।
मापी हुई और समझाई हुई।

भाषा मॉडल एप्लिकेशन में HotKV का उपयोग, यानी मॉडल कॉल, टोकन का हिसाब, जवाबों का दोबारा उपयोग और सिमैंटिक कैशिंग में गुणवत्ता के समझौते।

4 लेख LLM में

लेख

विचार। प्रयोग। अपडेट।
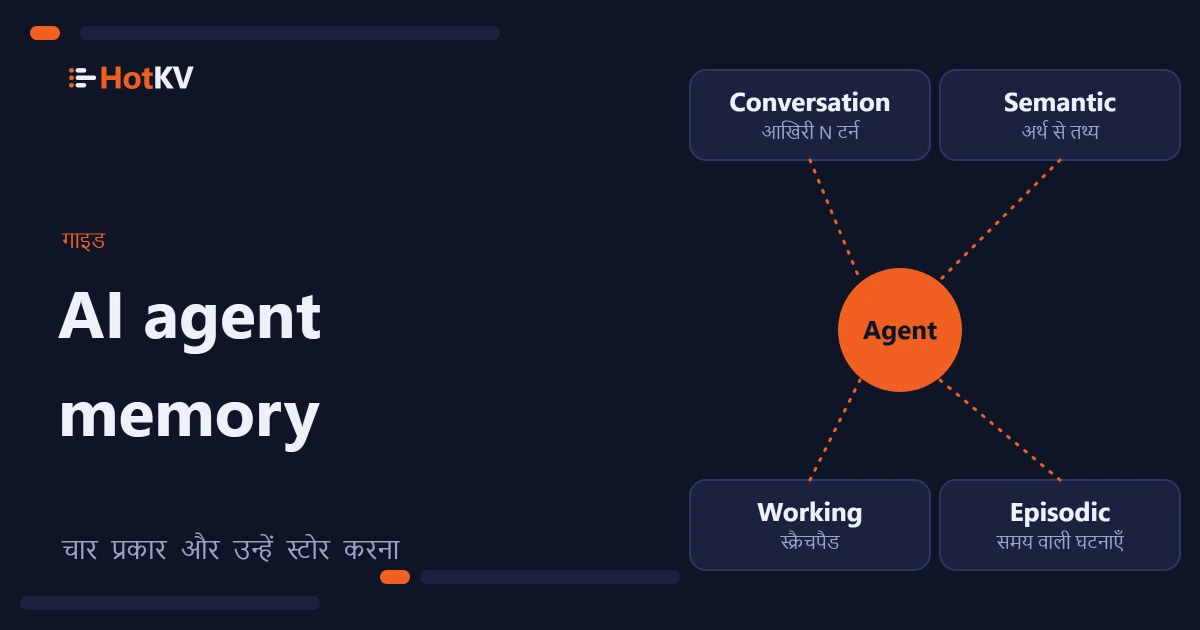
AI agent memory, एक एजेंट के रूप में जिसके चारों ओर चार मेमोरी स्टोर हैं: conversation, semantic, working और episodic।
गाइड12 मिनट में पढ़ें

AI agent memory: चार प्रकार और उन्हें कैसे स्टोर करें
AI agent memory एक लंबी context window से कहीं ज़्यादा है। एजेंट को चाहिए चार तरह की मेमोरी, हर एक को कैसे स्टोर करें और क्या बाहर रखें, HotKV कमांड के साथ।

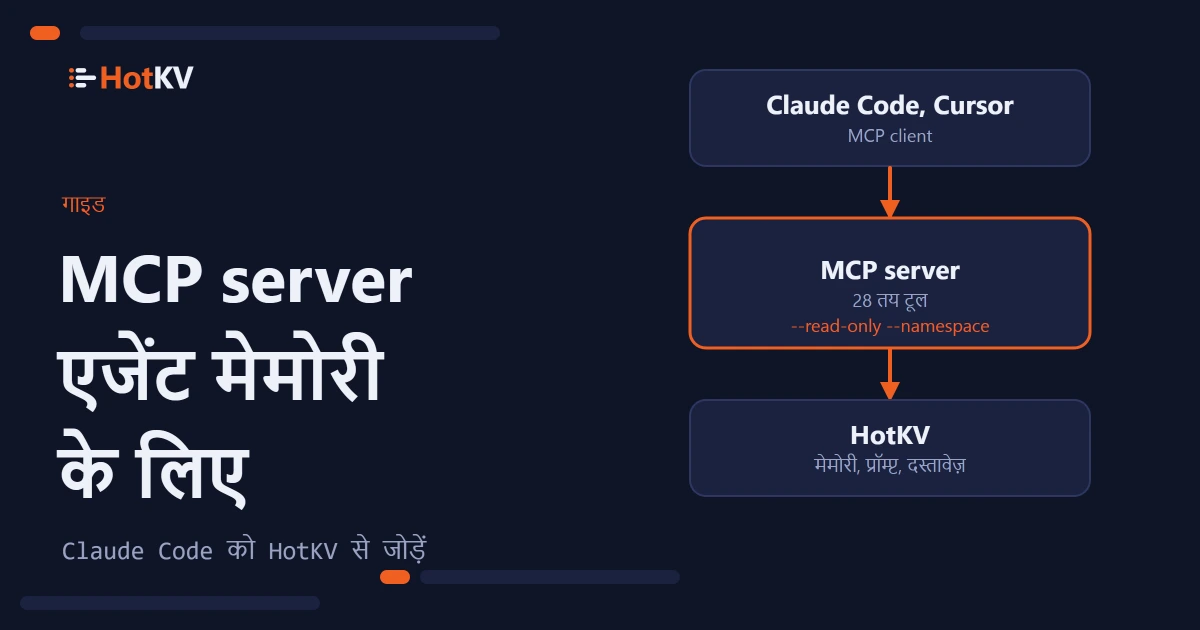
Claude Code जैसे असिस्टेंट और HotKV के बीच एक MCP server, 28 तय टूल के साथ।
गाइड10 मिनट में पढ़ें

एजेंट मेमोरी के लिए MCP server: Claude Code को HotKV से जोड़ें

MCP server 28 तय टूल के ज़रिए Claude Code या Cursor को HotKV में मेमोरी देता है। इंस्टॉल करें, जोड़ें और read-only मोड व namespace से सीमित करें।

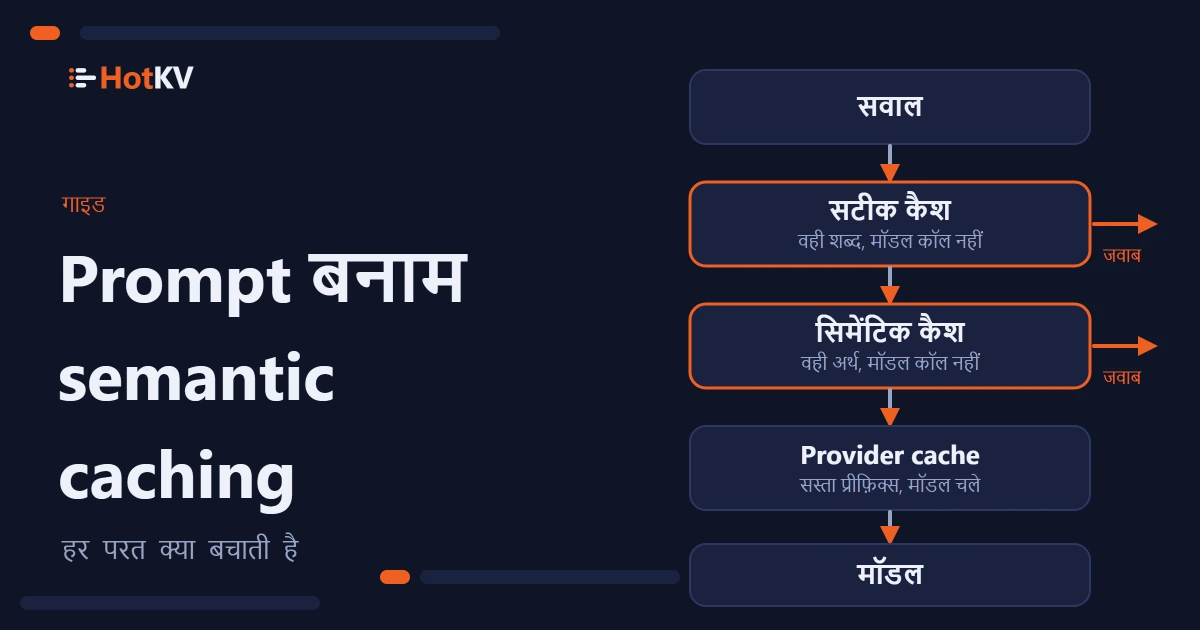
Prompt caching और semantic caching, एक सवाल और मॉडल के बीच की परतों के रूप में।
गाइड13 मिनट में पढ़ें

Prompt caching बनाम semantic caching: कौन क्या बचाता है

Prompt caching दोहराए गए prefix को सस्ता करता है, semantic caching मॉडल कॉल हटा देता है। दोनों कैसे काम करते हैं, हमने क्या मापा और कब कौन सा चुनें।

अपनी जिज्ञासा के पीछे चलें

टैग के अनुसार खोजें

न्यूज़लेटर

HotKV के नए लेख हम प्रकाशित करते ही ईमेल से भेजते हैं। एक बार पुष्टि करें और एक क्लिक में सदस्यता छोड़ें। फ़ीड पसंद है? RSS का उपयोग करें।