
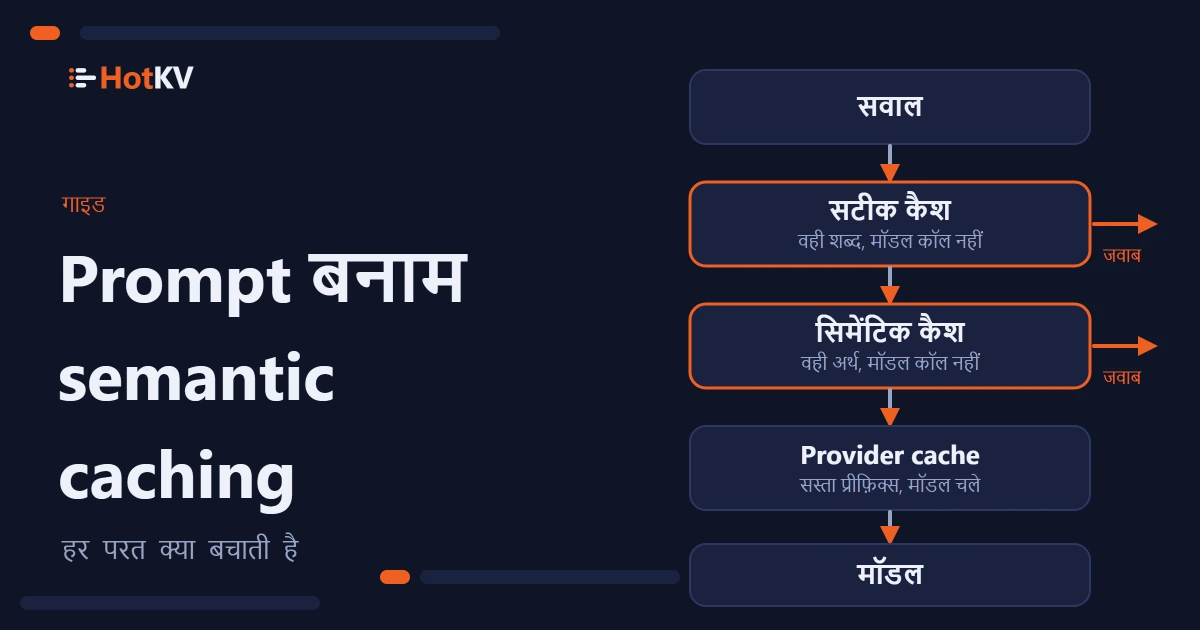
भाषा मॉडल के लिए दो अलग चीज़ें caching के नाम पर बिकती हैं, और टीमें अक्सर एक खरीदकर दूसरी की उम्मीद करती हैं। Prompt caching प्रोवाइडर का फ़ीचर है, जो दोहराए गए prompt prefix को पढ़ना सस्ता कर देता है। Semantic caching ऐसी परत है जिसे आप खुद चलाते हैं और जो किसी सवाल का जवाब मेमोरी से दे देती है, ताकि मॉडल को कॉल ही न करना पड़े। ये बिल के अलग-अलग हिस्सों को हल करती हैं, और साथ मिलकर सबसे अच्छा काम करती हैं।
संक्षेप में। Prompt caching किसी prompt के दोहराए गए शुरुआती हिस्से पर छूट देता है, जैसे लंबा system prompt। लेकिन मॉडल फिर भी चलता है और आप हर output token के लिए फिर भी भुगतान करते हैं। Exact और semantic caching तब कॉल को पूरी तरह हटा देते हैं जब सवाल का जवाब पहले दिया जा चुका हो। हमारे 3,000 अनुरोधों वाले benchmark में, जहाँ प्रोवाइडर का prompt caching पहले से चालू था, उसके आगे HotKV लगाने से मॉडल कॉल, token और लागत लगभग 70% घटे, क्योंकि output token अब भी baseline लागत का 73% से 92% थे।
Prompt caching कैसे काम करता है
Prompt caching मॉडल प्रोवाइडर के पास रहता है। आप अनुरोध के स्थिर शुरुआती हिस्से को चिह्नित करते हैं, आमतौर पर tools और system prompt, और प्रोवाइडर उसका प्रोसेस किया हुआ रूप थोड़े समय के लिए रख लेता है। जो अगला अनुरोध बिल्कुल उसी टेक्स्ट से शुरू होता है, उसमें उस हिस्से का बिल घटी हुई दर पर बनता है। हम यहाँ Anthropic का संस्करण बता रहे हैं क्योंकि हमने उसी को मापा। नीचे के ब्योरे उसके prompt caching दस्तावेज़ीकरण से हैं, जिसे 18 अक्टूबर 2026 को जाँचा गया।
क्या cache होता है
Hit के लिए बिल्कुल सटीक मिलान चाहिए। cache_control से चिह्नित ब्लॉक तक का हर ब्लॉक, उसे मिलाकर, एकदम समान होना चाहिए, क्रम है tools, system prompt, फिर messages। Prompt में शुरुआत के पास एक अक्षर बदलें तो उसके बाद का सब कुछ miss हो जाता है। सवाल खुद सबसे अंत में आता है, इसलिए वह cache किए गए prefix का हिस्सा कभी नहीं बनता।
न्यूनतम लंबाई से छोटे prompt cache नहीं होते और कोई एरर भी नहीं आता। हमारे इस्तेमाल किए मौजूदा Claude मॉडल, Fable 5.1, Opus 5.5, Sonnet 5.5 और Haiku 5.5, के लिए दस्तावेज़ में बताया न्यूनतम 512 token है। Cache एंट्री संगठन के स्तर पर अलग रहती हैं, और Claude API पर workspace के स्तर पर।
इसकी कीमत क्या है
डिफ़ॉल्ट अवधि पाँच मिनट है, और एंट्री का हर उपयोग उसे बिना अतिरिक्त शुल्क के रीफ़्रेश करता है। एक घंटे की अवधि भी उपलब्ध है। एंट्री लिखने की कीमत पाँच मिनट के लिए बेस input कीमत का 1.25 गुना और एक घंटे के लिए 2 गुना है। उसे पढ़ने की कीमत ज़्यादातर मॉडल पर बेस input कीमत का 0.1 गुना, Opus 5.5 और Sonnet 5.5 पर 0.05 गुना और Fable 5.1 पर 0.025 गुना है, pricing पेज के अनुसार। ये गुणक बदलते रहते हैं, इसलिए कोई भी हिसाब लगाने से पहले मौजूदा पेज पढ़ें।
Prompt caching क्या नहीं हटा सकता
Prompt caching prefix पढ़ने पर छूट देता है। यह मॉडल को छोड़ता नहीं। हर अनुरोध फिर भी नया जवाब बनाता है, आप फिर भी उसका इंतज़ार करते हैं, और हर output token का बिल पूरी output कीमत पर बनता है।
हमारा benchmark दिखाता है कि यह कितना मायने रखता है। हमने चार Claude मॉडल में से हर एक को 3,000 ग्राहक सहायता सवाल भेजे, system prompt के रूप में 2,200 token की एक पॉलिसी के साथ और प्रोवाइडर caching चालू रखकर। गिने गए token में से 90% से 93% उस पॉलिसी की cache reads थे। Output सिर्फ़ 6% से 9% token था, फिर भी वह baseline लागत का 73% से 92% था। Prefix पहले से सस्ता था, इसलिए बचा हुआ खर्च जवाबों में था।
यही वह खाई है जिसे दूसरी परतें भरती हैं। पूरी पद्धति और नतीजे token savings benchmark में हैं।
Exact और semantic response caching
दो परतें अनुरोध का जवाब मेमोरी से देती हैं। वे इस बात में अलग हैं कि नया अनुरोध पुराने से मिलता है, यह कैसे तय करती हैं।
Exact response caching
Exact cache अंतिम जवाब को ऐसी key के तहत रखता है जो उसे आकार देने वाली हर चीज़ से बनी हो। आमतौर पर वह मॉडल, prompt का संस्करण और normalize किया हुआ सवाल होता है। जब वही अनुरोध फिर आता है तो रखा हुआ जवाब लौटा दिया जाता है और मॉडल को कॉल नहीं किया जाता। इसमें कोई similarity स्कोर नहीं है और किसी दूसरे सवाल के लिए बना जवाब लौट जाने का जोखिम नहीं है।
हमारे रन में exact cache ने लगभग 39% अनुरोधों का जवाब दिया। दोहराया गया सवाल औसतन (median) लगभग 0.05 ms में लौट आया। यह उसी मशीन पर loopback के ज़रिए Python क्लाइंट से मापा गया था, इसलिए इसे लोकल आँकड़ा समझें, नेटवर्क का नहीं। Benchmark ने इस परत के लिए सादे GET और SET इस्तेमाल किए। HotKV Enterprise में प्रति-namespace सीमाओं और लागत ट्रैकिंग वाला एक समर्पित exact-match prompt cache भी है, PCACHE.*।
Exact caching शब्दों के प्रति अंधा है। "How do I reset my password?" और "I forgot my password" दो अलग keys हैं।
Semantic caching
Semantic cache सवाल के अर्थ को खोजता है। वह सवाल को embedding में बदलता है, सबसे नज़दीकी रखा हुआ सवाल ढूँढता है और अगर cosine similarity किसी threshold को पार कर जाए तो उसका जवाब लौटाता है। HotKV में यह SCACHE.* है, जो vector search वाले ही vector index पर बना है।
हमारे लगभग 31% अनुरोधों का जवाब इसी तरह दिया गया। एक paraphrase में औसतन (median) लगभग 130 ms लगे, जिसका लगभग सारा हिस्सा embedding सेवा को कॉल करने का था, इसलिए semantic hit मॉडल कॉल से बहुत तेज़ है पर तात्कालिक नहीं। Semantic परत के बिना, अकेले exact cache को 3,000 में से अधिकतम 1,264 मॉडल कॉल लगते, यानी लगभग 58% कम। Semantic परत ने बचत को लगभग 70% तक पहुँचाया।
जोखिम भी यहीं है। मिलता-जुलता सवाल हमेशा वही सवाल नहीं होता। हमने एक दूसरे Claude मॉडल से हर semantic hit को नए जवाब के सामने परखवाया। हमारे डिफ़ॉल्ट threshold 0.81 पर, cache किए जवाब सटीक सवाल पर नए जवाबों से 5.8 से 10.7 प्रतिशत अंक कम बार फ़िट हुए। Sonnet 5.5 पर 0.88 और उससे ऊपर के threshold में ऐसी कोई कमी नहीं दिखी, पर प्रमाण कमज़ोर है। जो सवाल एक निर्णायक ब्योरे से अलग होने के लिए लिखे गए थे, वे फिर भी 0.81 पर 62% बार और 0.95 पर 10% बार मिल गए।
Prompt caching बनाम semantic caching, आमने-सामने
| प्रोवाइडर का prompt caching | Exact response cache | Semantic cache | |
|---|---|---|---|
| यह क्या हटाता है | input कीमत का एक हिस्सा | पूरा मॉडल कॉल | पूरा मॉडल कॉल |
| मिलान का नियम | एकदम समान prefix | एकदम समान अनुरोध | threshold से ऊपर मिलता-जुलता अर्थ |
| Output token का बिल | हाँ, हर बार | नहीं, hit पर | नहीं, hit पर |
| गलत जवाब का जोखिम | कोई नहीं | समान अनुरोधों के लिए कोई नहीं | असली, threshold से ट्यून होता है |
| कहाँ चलता है | प्रोवाइडर के पास | आपके cache में | आपके cache में, साथ में एक embedding कॉल |
| हमारे रन में अनुरोधों का हिस्सा | हमेशा चालू | लगभग 39% | लगभग 31% |
प्रोवाइडर का prompt caching और response caching एक-दूसरे के विकल्प नहीं हैं। एक उन कॉल की कीमत घटाता है जो आप फिर भी करते हैं, और दूसरा घटाता है कि आप कितने कॉल करते हैं।
Caching का latency पर असर
मॉडल को छोड़ने से जवाब कितनी तेज़ी से आते हैं, यह भी बदलता है, सिर्फ़ लागत नहीं। हमारे रन में पूरा जवाब मिलने का औसत (median) समय Fable 5.1 पर 2.7 सेकंड से 127 ms, Opus 5.5 पर 2.9 सेकंड से 126 ms, Sonnet 5.5 पर 1.8 सेकंड से 128 ms और Haiku 5.5 पर 1.4 सेकंड से 125 ms हो गया। यह median पर 11 से 23 गुना तेज़ है।
धीमा सिरा लगभग नहीं हिला। लगभग 30% अनुरोध फिर भी मॉडल तक पहुँचे, और Fable 5.1 पर 99वाँ percentile HotKV के साथ लगभग 6.4 सेकंड था जबकि उसके बिना 6.6 सेकंड। Cache उन अनुरोधों का इंतज़ार हटा देता है जिनका वह जवाब देता है, और जिन्हें वह चूकता है उनके लिए कुछ नहीं करता। अगर आपकी शिकायत सबसे बुरे मामले की धीमी गति है, सामान्य मामले की नहीं, तो अकेली caching उसे ठीक नहीं करेगी।
ये पूरा जवाब मिलने के समय हैं, क्योंकि कॉल streamed नहीं थे। Streamed जवाब अपने पहले शब्द जल्दी दिखाता है। चैट विंडो में अंतर इन आँकड़ों के अंतर से छोटा होता है।
अपने ट्रैफ़िक के लिए परत चुनना
सही परत इस पर निर्भर करती है कि आपके अनुरोध कैसे दोहराते हैं, और आप कुछ भी बनाने से पहले इसे माप सकते हैं।
परत को ट्रैफ़िक से मिलाएँ
परत को इससे मिलाएँ कि आपके अनुरोध कैसे दोहराते हैं।
- लंबा, स्थिर system prompt या tool सूची। प्रोवाइडर prompt caching इस्तेमाल करें। इसे चालू करना सस्ता है और यह कोई जवाब नहीं बदलता।
- वही सवाल उन्हीं शब्दों में, जैसे बटन, टेम्पलेट या retry। Exact response cache इस्तेमाल करें। यह सुरक्षित और तेज़ है।
- सहायता, खोज और FAQ ट्रैफ़िक, जहाँ लोग वही बात अलग शब्दों में पूछते हैं। Semantic cache जोड़ें, threshold ऊँचा रखें, और उस पर भरोसा करने से पहले अपने सवालों पर जवाब की गुणवत्ता जाँचें।
- ऐसे जवाब जो यूज़र, घड़ी या लाइव डेटा पर निर्भर हैं। इनमें से किसी को cache न करें, या cache की key उन तथ्यों पर रखें जो जवाब बदलते हैं।
बचत दोहराव के साथ चलती है। जब हमने हर intent को skewed की जगह बराबर संभावना वाला बनाया, तो जिन दो मॉडल पर हमने दोबारा रन किया उन पर लागत 56% गिरी, और 3,000 सब अलग सवालों के साथ वह 38% गिरी। जिस workload में कोई दोहराया या मिलता-जुलता सवाल नहीं, उसमें कुछ नहीं बचता।
पहले अपना दोहराव मापें
कुछ भी बनाने से पहले पता करें कि आपका कितना ट्रैफ़िक दोहराता है। यही संख्या तय करती है कि exact cache रखना सार्थक है या नहीं। जो सवाल आप पहले से लॉग करते हैं, उनके साथ इसमें दस मिनट लगते हैं। हर सवाल को वैसे normalize करें जैसे आपकी cache key करेगी, अलग-अलग सवाल गिनें, और देखें कि ट्रैफ़िक का कितना हिस्सा दोहराव था।
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share अनुरोधों का वह अंश है जिनका जवाब exact cache देता, हर सवाल को पहली बार देख लेने के बाद। हमारे परीक्षण सेट में 3,000 अनुरोधों में 1,264 अलग सवाल थे, इसलिए आँकड़ा लगभग 58% था। अगर आपका लगभग 5% आए, तो exact cache बहुत कम करेगा, और केवल semantic परत मदद कर सकती है।
दो सावधानियाँ लागू होती हैं। Cache खाली से शुरू होता है, इसलिए शुरुआती अनुरोध हमेशा मॉडल तक पहुँचते हैं। हमारे रन में पहले हज़ार अनुरोधों में से लगभग 52% cache से मिले और आख़िरी हज़ार में से लगभग 81%। और पिछले महीने के ट्रैफ़िक का लॉग आपको पिछले महीने के बारे में ही बताता है। अगर आप ऐसा फ़ीचर लॉन्च करने वाले हैं जो लोगों के पूछने का तरीका बदल दे, तो इस आँकड़े को मोटा अंदाज़ा मानें।
परतों को साथ जोड़ना
एक अनुरोध को परतों से सबसे सस्ती और सबसे सुरक्षित से लेकर सबसे महँगी तक गुज़रना चाहिए, और आपको दिखना चाहिए कि हर परत ने क्या बचाया।
Lookup का क्रम
क्रम मायने रखता है। सबसे सस्ती और सबसे सुरक्षित परत पहले जाँचें और मॉडल को तभी कॉल करें जब सब miss हो जाएँ। यह स्केच मानता है कि decode_responses=True वाला redis-py जैसा क्लाइंट है, दो namespace पहले से बने हैं, और आपके अपने embed और llm फ़ंक्शन हैं।
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # same words

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # same meaning

    reply = llm.complete(question)                   # provider prompt caching applies here
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Namespace एक बार बनाएँ, PCACHE.CREATE answers_exact और SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90 से, अपने embedding मॉडल की dimension के साथ। AI कमांड सेट HotKV Cloud के Performance और Scale इंस्टेंस के साथ आता है, और AI पेज बताता है कि हर इंजन क्या करता है। Pricing पेज दिखाता है कि किस प्लान में क्या शामिल है।
Production में हिसाब रखना
जिस cache को आप देख नहीं सकते, उस पर भरोसा नहीं कर सकते। HotKV प्रति namespace hit और miss की गिनती रखता है। अगर आप हर एंट्री के साथ मूल कॉल का token उपयोग स्टोर करें, तो वह यह भी बता सकता है कि हर बाद के hit ने कितने token और कितनी लागत बचाई। तब PCACHE.STATS और SCACHE.STATS के जवाबों में usage_saved_requests, usage_saved_input_tokens और usage_saved_cost_usd जैसे फ़ील्ड आते हैं।
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
<model> की जगह अपने मॉडल की id डालें। INPUT बिना cache वाले prompt token गिनता है और CACHEREAD वे token जो प्रोवाइडर ने अपने cache से परोसे, इसलिए दोनों एक-दूसरे में नहीं आते। लागत वाले फ़ील्ड का कोई मतलब हो, इसके लिए मॉडल का HotKV की कीमत तालिका में होना ज़रूरी है। LLMSTATS.PRICE LIST दिखाता है कि कौन से मॉडल ज्ञात हैं, और LLMSTATS.PRICE SET आपके अपने जोड़ता है। जिस मॉडल की कीमत नहीं है, उसके token फिर भी गिने जाते हैं, पर उसकी लागत शून्य दर्ज होती है और एक अलग काउंटर दिखाता है कि अनुरोध बिना कीमत के रहे।
Cache खर्च घटाते हैं, और बजट बचे हुए की सीमा तय करता है। LLMBUDGET.SET किसी समय-अवधि के लिए token और डॉलर की सीमा तय करता है। LLMBUDGET.CONSUME मॉडल कॉल से पहले जाँचा जाता है, इसलिए बेकाबू एजेंट पैसा खर्च करने के बाद नहीं, खर्च करने से पहले रोक दिया जाता है। LLMSTATS.RECORD प्रति-tenant कुल रखता है, जो प्रोवाइडर के cache-read और cache-write token को समझते हैं। मॉडल का नाम देने पर तीनों एक ही कीमत तालिका इस्तेमाल करते हैं, इसलिए बचत, बजट और डैशबोर्ड का आँकड़ा आपस में टकरा नहीं सकते।
वे गलतियाँ जिनसे cache गलत जवाब लौटाता है
ज़्यादातर गलत cache hit उस key से आते हैं जिसमें कुछ छूटा हो। मॉडल, prompt का संस्करण और कोई भी tool या policy का संस्करण exact key में रखें, ताकि prompt बदलने पर पुराने prompt के लिखे जवाब न परोसे जाएँ।
एंट्री को ऐसी अवधि दें जो इस पर बैठे कि आपके तथ्य कितनी तेज़ी से बदलते हैं। Tenant को अलग namespace से अलग रखें, ताकि एक ग्राहक का जवाब कभी दूसरे को न दिया जाए। निजी डेटा वाला जवाब कभी cache न करें, जब तक key में यह न हो कि वह डेटा किसका है।
अंत में, अपने ट्रैफ़िक पर मापें। हमारे आँकड़े छोटे बैंकिंग सवालों के एक सार्वजनिक डेटासेट, एक काल्पनिक पॉलिसी और प्रति शर्त एक रन से आए हैं, और वे आपके workload के लिए कोई वादा नहीं हैं।
अक्सर पूछे जाने वाले प्रश्न
Prompt caching क्या है?
Prompt caching मॉडल प्रोवाइडर का फ़ीचर है, जो prompt के प्रोसेस किए हुए शुरुआती हिस्से को थोड़े समय के लिए रखता है। बाद का जो अनुरोध बिल्कुल उसी टेक्स्ट से शुरू होता है, उसमें उस हिस्से का बिल कम दर पर बनता है। मॉडल फिर भी चलता है और नया जवाब बनाता है, इसलिए आप output token के लिए फिर भी भुगतान करते हैं।
क्या prompt caching और semantic caching एक ही चीज़ हैं?
नहीं। Prompt caching दोहराए गए prompt prefix को दोबारा इस्तेमाल करता है और फिर भी मॉडल को कॉल करता है। Semantic caching मिलते-जुलते अर्थ वाले सवाल का रखा हुआ जवाब लौटाता है और मॉडल कॉल छोड़ देता है। ये अलग लागतों को संबोधित करते हैं और साथ इस्तेमाल हो सकते हैं।
क्या prompt caching output token की लागत घटाता है?
नहीं। यह सिर्फ़ cache किए गए prefix को पढ़ने की कीमत घटाता है। हमारे benchmark में, prompt caching पहले से चालू होने पर output 6% से 9% token था पर baseline लागत का 73% से 92%, और इसीलिए पूरे जवाबों को cache करने से कहीं ज़्यादा बचत हुई।
Anthropic का prompt cache कितनी देर चलता है?
डिफ़ॉल्ट पाँच मिनट है, जो एंट्री के हर उपयोग पर रीफ़्रेश होता है। ज़्यादा लिखने की कीमत पर एक घंटे का विकल्प उपलब्ध है। मौजूदा दस्तावेज़ीकरण देखें, क्योंकि सीमाएँ और कीमतें बदलती रहती हैं।
क्या मैं prompt caching और semantic caching साथ इस्तेमाल कर सकता हूँ?
हाँ, और हमारे benchmark ने ठीक यही किया। दोनों रन में प्रोवाइडर का prompt caching चालू रहा, और semantic व exact परतें मॉडल के आगे लगीं। Cache hit कॉल छोड़ देते हैं, और miss को फिर भी छूट वाले prefix का लाभ मिलता है।
Semantic cache को कौन सा similarity threshold इस्तेमाल करना चाहिए?
कोई सार्वभौमिक मान नहीं है। हमने 0.81 एक अलग training split पर चुना, और Sonnet 5.5 पर 0.88 से ऊपर cache किए जवाबों में नए जवाबों के मुकाबले गुणवत्ता की कोई कमी नहीं दिखी, पर प्रमाण कमज़ोर है। ऊँचे से शुरू करें, अपने सवालों पर cache किए जवाबों को नए जवाबों के सामने परखें, और threshold तभी घटाएँ जब गुणवत्ता बनी रहे।
बातचीत आगे बढ़ाएँ
टिप्पणियाँ
तरीके के बारे में कोई सवाल है? आपके हार्डवेयर पर नतीजा अलग आया? जो मिला, वह साझा करें। टिप्पणियाँ दिखने से पहले जाँची जाती हैं।