
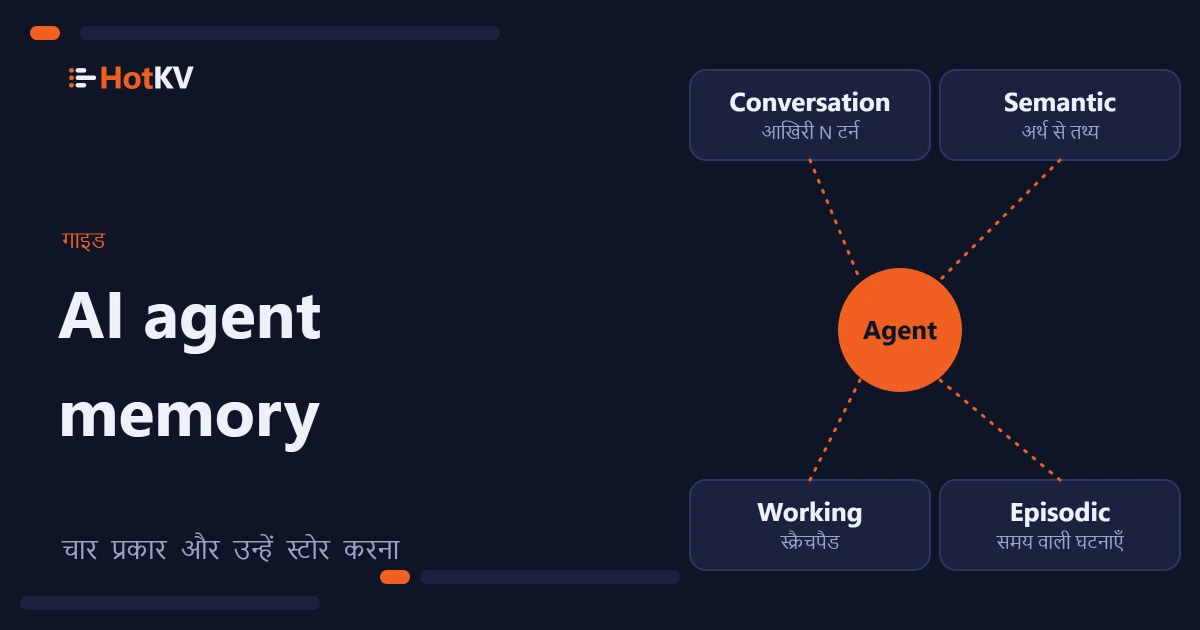
AI agent memory वह चीज़ है जो एजेंट को किसी एक स्टेप या सेशन से अगले तक कुछ साथ ले जाने देती है। अकेला भाषा मॉडल दो कॉल के बीच कुछ याद नहीं रखता। जो कुछ वह याद रखता दिखता है, उसे आपके कोड ने वापस prompt में डाला होता है। आप इस सामग्री को कैसे स्टोर और रिट्रीव करते हैं, इसी से तय होता है कि एजेंट क्या याद कर सकता है, कितनी जल्दी और हर टर्न पर किस लागत से।
संक्षेप में। एजेंट को चार तरह की मेमोरी चाहिए: एक छोटी conversation window, अर्थ से खोजे जाने वाले दीर्घकालिक तथ्य, चल रहे टास्क के लिए एक scratchpad और जो हुआ उसका एक लॉग। हर एक का आकार, जीवनकाल और लुकअप अलग है, इसलिए एक अकेली मेमोरी तालिका इनमें से किसी के लिए ठीक नहीं बैठती। HotKV
AMEM.*कमांड के साथ चारों को एक ही in-memory इंजन में स्टोर करता है। हमने HotKV की caching और vector search को बेंचमार्क किया है, agent memory को नहीं, इसलिए यह लेख डिज़ाइन समझाता है और किसी speed-up का दावा नहीं करता।
Context window मेमोरी क्यों नहीं है
Context window वह टेक्स्ट है जो आप हर रिक्वेस्ट के साथ भेजते हैं। उसकी एक साइज़ सीमा होती है, उसमें मौजूद हर चीज़ के लिए आप हर टर्न पर input token चुकाते हैं, और सेशन खत्म होते ही वह गायब हो जाती है। साथ ही उसमें खोज नहीं की जा सकती। अगर एजेंट को तीन हफ़्ते पुराना कोई एक तथ्य चाहिए, तो पूरा इतिहास चिपका देना कोई जवाब नहीं है।
मेमोरी वह परत है जो तय करती है कि window में आगे क्या जाएगा। वह हाल के टर्न रखती है और उन थोड़े पुराने तथ्यों को खोजती है जो मायने रखते हैं। वह मौजूदा टास्क की स्थिति रखती है और दर्ज करती है कि एजेंट ने क्या किया है। शोधकर्ता भी एजेंटों को इसी तरह के शब्दों में बताते हैं। Sumers, Yao, Narasimhan और Griffiths का CoALA framework working memory को दीर्घकालिक episodic, semantic और procedural memory से अलग करता है।
AI agent memory के चार प्रकार
HotKV के चार स्टोर लगभग उसी दायरे को कवर करते हैं, इस तरह ढाले हुए कि किसी एप्लिकेशन को क्या बनाना पड़ता है। Procedural memory, यानी एजेंट के कोड और prompt में रखा know-how, आमतौर पर आपके रिपॉज़िटरी या prompt registry में रहता है और अलग स्टोर नहीं है।
Conversation memory
यह एक सेशन का अल्पकालिक ट्रांसक्रिप्ट है। संदेशों के साथ एक role होता है (system, user, assistant या tool)। वे एक सीमित sliding window में रहते हैं, इसलिए सीमा पूरी होने पर सबसे पुराने टर्न गिर जाते हैं। यह एक ही सवाल का जवाब देती है। हाल में क्या कहा गया? HotKV में यह AMEM.CONV.CREATE, AMEM.CONV.APPEND और AMEM.CONV.WINDOW है।
Semantic memory
Semantic memory दीर्घकालिक ज्ञान है, जो embedding vector के साथ तथ्यों के रूप में स्टोर होता है। एजेंट उन्हें key से नहीं, अर्थ से याद करता है। इसके पीछे एक HNSW vector index है, वही जो vector search को चलाता है। AMEM.SEM.STORE एक तथ्य सेव करता है और AMEM.SEM.RECALL समानता स्कोर के साथ सबसे अच्छे मैच लौटाता है। दस्तावेज़, यूज़र की पसंद और सीखे गए सुधार यहीं रखे जाते हैं।
Working memory
Working memory चल रहे टास्क के लिए scratchpad है, यानी सेशन तक सीमित keys और values का एक सपाट सेट। इसमें मौजूदा स्टेप, जिस टिकट पर काम हो रहा है या कोई आंशिक नतीजा रहता है। टास्क खत्म होने पर इसे गायब हो जाना चाहिए। AMEM.WORK.SET इसी कारण से time to live स्वीकार करता है।
Episodic memory
Episodic memory टाइमस्टैम्प वाली घटनाओं का append-only लॉग है, जैसे की गई कोई कार्रवाई, किया गया कोई अवलोकन या लिया गया कोई निर्णय। इससे एजेंट, या उसकी समीक्षा करने वाला व्यक्ति, पूछ सकता है कि क्या हुआ और कब। AMEM.EPIS.LOG एक घटना लिखता है और AMEM.EPIS.QUERY उन्हें प्रकार और समय सीमा के हिसाब से वापस पढ़ता है।
व्यवहार में AI agent memory
व्यवहार में दो बातें मायने रखती हैं। आप मेमोरी में कैसे लिखते हैं, और हर टर्न पर आप क्या वापस पढ़ते हैं।
कमांड से मेमोरी स्टोर करना
यहाँ एक सपोर्ट एजेंट है जो एक बातचीत सँभाल रहा है। काल्पनिक पॉलिसी टेक्स्ट और तीन संख्याओं वाले vector केवल उदाहरण के लिए हैं। असली embedding मॉडल 768 या 1,536 संख्याओं के vector बनाता है, और आप namespace उसी dimension के साथ बनाते हैं।
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
हर टर्न पर एजेंट हाल की window पढ़ता है और सवाल से मेल खाने वाले थोड़े तथ्य recall करता है। वह अपना working note देखता है और इन्हीं टुकड़ों से prompt बनाता है। कार्रवाई करने के बाद वह घटना लॉग करता है। इस लूप में किसी भी जगह पूरे इतिहास की ज़रूरत नहीं पड़ती।
हर टर्न पर मेमोरी पढ़ना
मेमोरी स्टोर करना आसान आधा हिस्सा है। असली हुनर यह तय करने में है कि क्या वापस पढ़ना है, क्योंकि आप जो भी पढ़ते हैं वह prompt में जाता है और input token खर्च करता है। एक ठीक-ठाक लूप कुछ चीज़ें एक तय क्रम में पढ़ता है। पहले हाल के टर्न, फिर सवाल से मेल खाने वाले थोड़े तथ्य, फिर टास्क की स्थिति। यहाँ यह आधिकारिक Python क्लाइंट के साथ है, आपके अपने embedding function और prompt template के साथ।
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # अपने डेटा पर ट्यून करें

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # एक बार बनाएँ, पहले append से पहले

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # आपका prompt template

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
समानता की कटऑफ़ आपको ट्यून करनी है। जो मान एक embedding मॉडल और तथ्यों के एक सेट के लिए ठीक बैठता है, वह दूसरे के लिए गलत होगा, इसलिए उन सवालों पर recall जाँचें जिनके जवाब आप जानते हैं। कमज़ोर मैच हटाना जितना लगता है उससे ज़्यादा मायने रखता है, क्योंकि prompt में एक खराब तथ्य होना, कोई तथ्य न होने से बुरा है।
इस prompt के स्थिर हिस्से, जैसे system निर्देश, वही हैं जिन्हें provider-side prompt caching सस्ता बनाती है। आप जो मेमोरी पढ़ते हैं उसे स्थिर टेक्स्ट के बाद, अंत में रखें, ताकि उसके बदलने से वह cache अमान्य न हो।
अंतहीन लंबी window की जगह summary
Window पुराने टर्न पूरी तरह गिरा देती है। हल्की बातचीत के लिए यह ठीक है, पर लंबे टास्क के लिए बुरा है, जहाँ टर्न 3 टर्न 300 पर भी मायने रख सकता है। आमतौर पर इसका जवाब rolling summary है। बातचीत के हर हिस्से के बाद एजेंट, या कोई सस्ता मॉडल, लिख देता है कि क्या सीखा गया है, और summary prompt में पुराने टर्न की जगह ले लेती है।
HotKV AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND और AMEM.SUMMARY.GET के साथ हर एजेंट के लिए एक summary रखता है। SET टेक्स्ट को बदल देता है और APPEND एक पंक्ति जोड़ता है। हर अपडेट version number बढ़ाता है, इसलिए कोई दूसरा कंपोनेंट सस्ते में जान सकता है कि summary बदली और कब।
Summary में जानकारी घटती है, और summary की summary बनाने पर हर बार और ज़्यादा घटती है। पहचानकर्ता, राशियाँ और तारीखें जैसे सटीक मान गद्य से बाहर रखें और working memory या semantic तथ्यों में रखें, जहाँ वे बचे रहते हैं। Summary का इस्तेमाल काम की रूपरेखा के लिए करें, जैसे पसंद, लिए गए निर्णय और जो बाकी है।
डिज़ाइन नियम और retention
मेमोरी बिना सीमा के बढ़ती रहती है जब तक आप उसे रोकें नहीं, इसलिए पहला write करने से पहले सीमाएँ तय करें।
मेमोरी को उपयोगी रखने वाले नियम
- हर चीज़ को सीमित करें। Conversation पर
WINDOWऔर सेशन तथा working values परTTLसेट करें। Conversation, working values और तथ्यों के लिए HotKV append-only फ़ाइल और replicas के लिए expiry का समय दर्ज करता है, इसलिए जो एंट्री expire हो चुकी है वह रीस्टार्ट के बाद फ़ाइल replay होने पर वापस नहीं आती। - तथ्य स्टोर करें, ट्रांसक्रिप्ट नहीं। Semantic memory में लिखने से पहले summarize करें। संवाद के एक पन्ने की तुलना में एक तथ्य recall करना आसान है।
- एजेंटों को अलग रखें। हर एजेंट और हर tenant के लिए अलग पहचानकर्ता या namespace इस्तेमाल करें, ताकि एक ग्राहक की मेमोरी कभी दूसरे के लिए recall न हो।
- थोड़े recall करें, ज़्यादा नहीं। सबसे अच्छे तीन से पाँच मैच लें और कमज़ोर मैच को prompt में आने से पहले समानता स्कोर से हटा दें।
- Secrets बाहर रखें। मेमोरी वापस prompt में पढ़ी जाती है, इसलिए पासवर्ड, कुंजियाँ या ऐसा डेटा कभी स्टोर न करें जो आप मॉडल को न दिखाते।
हर प्रकार को कितने समय रखें
ये जीवनकाल हमारे सुझाव हैं, डिफ़ॉल्ट नहीं। अपना जीवनकाल इस आधार पर चुनें कि अंतर्निहित तथ्य कितनी तेज़ी से बदलते हैं और आपको क्या रखने की अनुमति है।
| मेमोरी प्रकार | सुझाया गया जीवनकाल | HotKV में नियंत्रण |
|---|---|---|
| Conversation | सेशन, या कोई तय अवधि जैसे एक दिन | AMEM.CONV.CREATE पर WINDOW और TTL |
| Working | टास्क, फिर साफ़ | AMEM.WORK.SET पर TTL, और AMEM.WORK.CLEAR |
| Semantic | जब तक तथ्य सच रहना बंद न कर दे | AMEM.SEM.STORE पर TTL, और AMEM.SEM.FORGET |
| Episodic | जब तक आपके audit या सपोर्ट की ज़रूरतें हों | समय सीमा के हिसाब से AMEM.EPIS.QUERY, और AMEM.EPIS.CLEAR (घटनाओं का कोई time to live नहीं होता) |
Retention एक privacy का सवाल भी है। अगर मेमोरी में किसी व्यक्ति के बारे में कुछ भी है, तो आप जो जीवनकाल चुनते हैं वह उस वादे का हिस्सा है जो आप उससे करते हैं, इसलिए उसे लिखकर रखें।
Agent memory कैसे गड़बड़ होती है
ज़्यादातर मेमोरी बग धीमे होते हैं। एजेंट एक हफ़्ते अच्छा चलता है और फिर बिगड़ने लगता है। डिज़ाइन में इन विफलताओं से बचना चाहिए।
आम विफलताएँ
- पुराने तथ्य। मार्च में सच रहा तथ्य अक्टूबर में recall होता है। तथ्यों को time to live दें, या उन्हें हर entity की एक key के तहत स्टोर करें ताकि नया मान पुराने को ओवरराइट कर दे।
- विरोधाभास। दो स्टोर किए गए तथ्य असहमत हैं और एजेंट कोई एक यूँ ही चुन लेता है। पुराने नोट के बगल में नए नोट जोड़ने की बजाय हर key पर एक तथ्य रखना बेहतर है।
- ज़रूरत से ज़्यादा recall। बहुत सारे मैच prompt को ढीले-ढाले संबंधित टेक्स्ट से भर देते हैं। थोड़े recall करें, और कमज़ोर मैच हटा दें।
- यूज़रों के बीच लीक। एक ग्राहक की मेमोरी दूसरे के लिए recall हो जाती है। हर tenant के लिए अलग पहचानकर्ता या namespace रखें, जिन्हें हर पढ़ाई से पहले कोड में जाँचा जाए।
- असीमित वृद्धि। कुछ भी कभी expire नहीं होता, इसलिए लुकअप धीमे होते हैं और लागत धीरे-धीरे बढ़ती है। हर प्रकार को एक जीवनकाल चाहिए। जहाँ HotKV में time to live नहीं है, जैसे episodic लॉग में, वहाँ clear या export खुद शेड्यूल करें।
- Summary का भटकाव। Summary की summary धीरे-धीरे जो हुआ उससे मेल खाना बंद कर देती है। घटना लॉग को सच्चाई का स्रोत रखें और summary उसी से दोबारा बनाएँ।
स्टोर किए गए टेक्स्ट को अविश्वसनीय मानें
आखिरी बिंदु पर ज़्यादा ध्यान देना चाहिए। एजेंट जो कुछ भी मेमोरी में लिखता है, उसे बाद में prompt में पढ़ा जा सकता है। इसमें वह टेक्स्ट भी शामिल है जो किसी वेब पेज, ईमेल या यूज़र से आया हो। यह prompt injection का वही अप्रत्यक्ष रूप है जिसे OWASP LLM01 के रूप में सूचीबद्ध करता है। हर तथ्य के साथ उसका स्रोत स्टोर करें। बाहरी सामग्री से लिखी गई मेमोरी पर कम भरोसा करें, और कभी recall किए गए नोट को अपने system prompt को override न करने दें।
हमने क्या मापा है और क्या नहीं
HotKV के प्रकाशित बेंचमार्क कमांड थ्रूपुट, vector search और response caching से होने वाली token बचत को कवर करते हैं। Agent memory का अपना अभी कोई बेंचमार्क नहीं है। हम उसकी latency के बारे में या इस बारे में कोई दावा नहीं करते कि वह एजेंट की गुणवत्ता को कितना सुधारती है। जो हम कह सकते हैं वह आर्किटेक्चर से जुड़ा है। चारों स्टोर cache और vector index वाले उसी प्रोसेस में चलते हैं। एक मेमोरी लुकअप उस सिस्टम को की गई एक कॉल है जिसे आप पहले से चला रहे हैं।
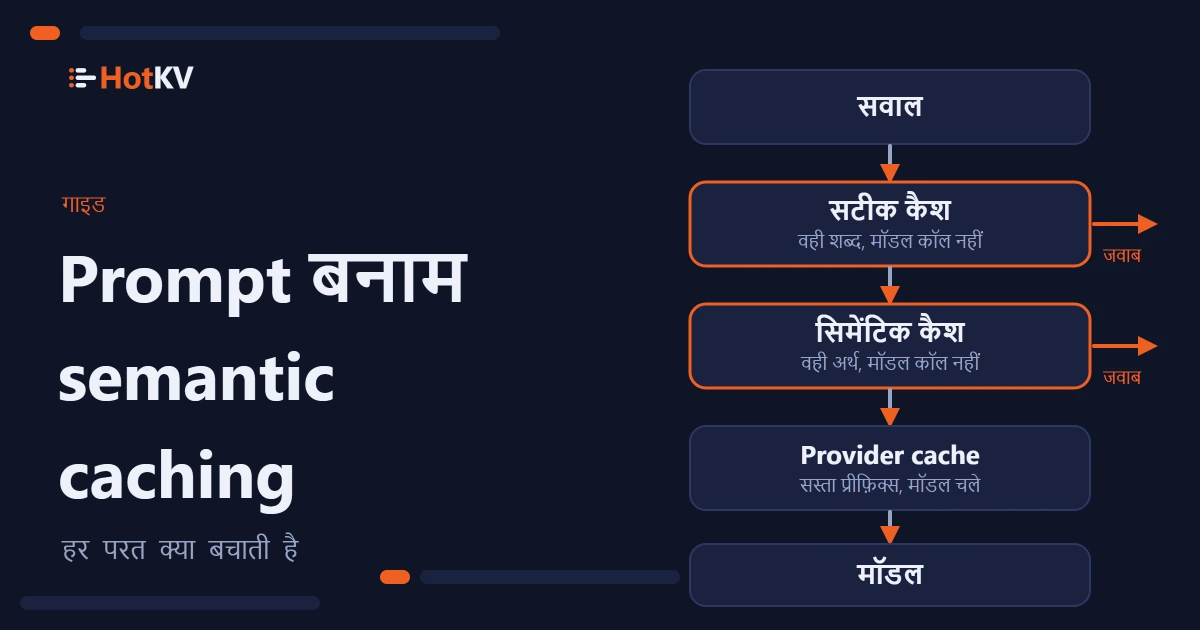
Token savings बेंचमार्क और prompt caching तथा semantic caching की तुलना मापा हुआ पक्ष दिखाते हैं। Agent memory का use case कमांड को एक पूरे परिदृश्य में दिखाता है।
Claude Code या Cursor से agent memory इस्तेमाल करना
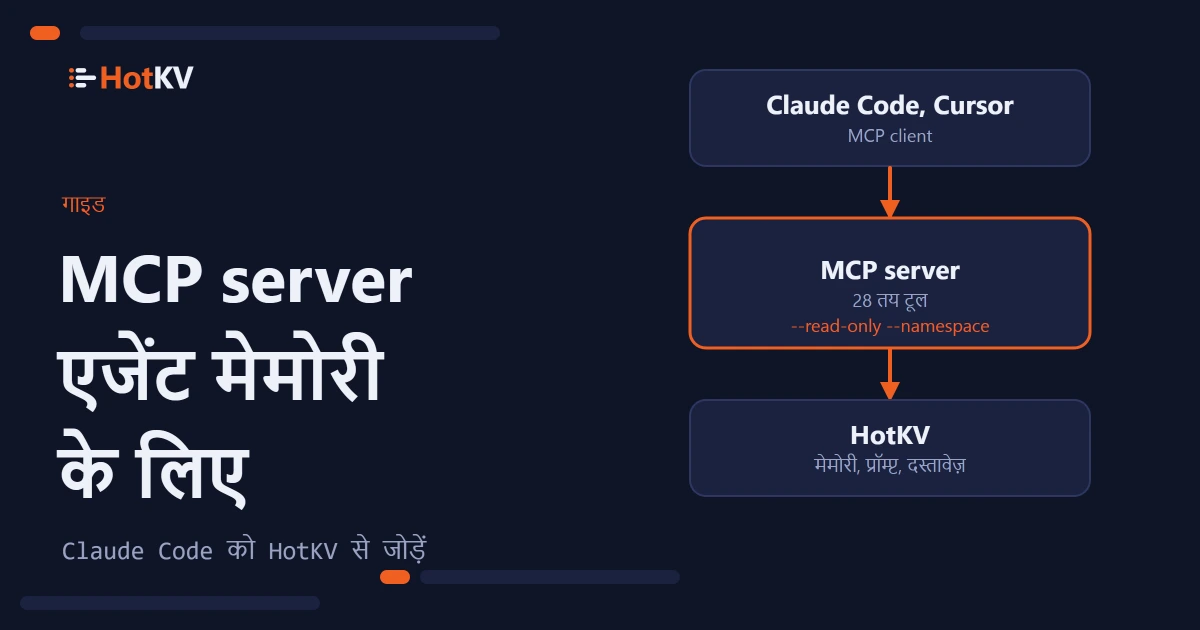
Model Context Protocol सपोर्ट करने वाला असिस्टेंट इस मेमोरी का एक हिस्सा बिना कस्टम कोड के इस्तेमाल कर सकता है। ओपन-सोर्स hotkv-mcp सर्वर conversation memory, working notes, एक घटना लॉग और एक rolling summary को tools के रूप में उपलब्ध कराता है। इसमें एक read-only मोड और एजेंट को सीमित करने वाला एक namespace है। यह semantic memory उपलब्ध नहीं कराता, और इसके tools window या time to live सेट नहीं कर सकते, इसलिए उनके लिए क्लाइंट लाइब्रेरी इस्तेमाल करें। अगला लेख, agent memory के लिए एक MCP सर्वर, दिखाता है कि इसे कैसे कनेक्ट करें और इसकी सुरक्षा व्यवस्थाएँ क्या कवर करती हैं।
अक्सर पूछे जाने वाले सवाल
AI agent memory क्या है?
AI agent memory वह स्टोरेज और रिट्रीवल परत है जो एजेंट को स्टेप और सेशन के पार जानकारी रखने देती है। यह आमतौर पर हाल की conversation window, अर्थ से खोजे जाने वाले दीर्घकालिक तथ्य, मौजूदा टास्क के लिए एक scratchpad और एक घटना लॉग को मिलाती है।
अल्पकालिक और दीर्घकालिक agent memory में क्या अंतर है?
अल्पकालिक मेमोरी में वह रहता है जो अभी हो रहा है, जैसे हाल के टर्न और टास्क की स्थिति, और वह सीमित तथा अस्थायी होती है। दीर्घकालिक मेमोरी में वह ज्ञान रहता है जो सेशन से आगे भी बचना चाहिए, जैसे तथ्य, पसंद और पिछली घटनाएँ, और ज़रूरत पड़ने पर उसमें खोज की जाती है।
Agent memory में rolling summary क्या है?
Rolling summary इसका एक छोटा चलता हुआ विवरण है कि एजेंट ने अब तक क्या सीखा या तय किया है, जो काम आगे बढ़ने के साथ अपडेट होता है। यह prompt में पुराने टर्न की जगह लेती है ताकि prompt बढ़ता न रहे। HotKV हर एजेंट के लिए एक रखता है और हर अपडेट पर version number बढ़ाता है।
क्या agent memory के लिए मुझे vector डेटाबेस चाहिए?
केवल semantic memory के लिए, जहाँ तथ्य अर्थ से खोजे जाते हैं। Conversation window, working state और घटना लॉग को vector की ज़रूरत नहीं। HotKV चारों को एक इंजन में रखता है, इसलिए vector index और बाकी स्टोर अलग सिस्टम नहीं हैं।
Agent memory को कितने समय तक रखना चाहिए?
यह प्रकार पर निर्भर करता है। Working memory को टास्क खत्म होने पर expire होना चाहिए, conversation को सेशन के बाद या किसी तय अवधि के बाद, और episodic लॉग को तब तक जब तक आपके audit की ज़रूरतें हों। Semantic memory के तथ्यों की समीक्षा होनी चाहिए और जब वे सच रहना बंद करें तो हटा देने चाहिए।
क्या agent memory पर हमला हो सकता है?
हाँ। मेमोरी में लिखा गया टेक्स्ट बाद में prompt में पढ़ा जाता है, इसलिए एक ज़हरीला नोट एजेंट को भटका सकता है। दर्ज करें कि हर तथ्य कहाँ से आया, बाहरी सामग्री पर कम भरोसा करें, और recall की गई मेमोरी को अधिकार में अपने system prompt से नीचे रखें।
क्या HotKV agent memory को RAM में स्टोर करता है?
HotKV एक in-memory इंजन है, इसलिए पढ़ाई मेमोरी से होती है। प्रोडक्ट डॉक्यूमेंटेशन के अनुसार, चारों स्टोर में writes append-only फ़ाइल और replicas के लिए दर्ज होते हैं, और expiry समय साथ ले जाए जाते हैं।
बातचीत आगे बढ़ाएँ
टिप्पणियाँ
तरीके के बारे में कोई सवाल है? आपके हार्डवेयर पर नतीजा अलग आया? जो मिला, वह साझा करें। टिप्पणियाँ दिखने से पहले जाँची जाती हैं।