

언어 모델 캐싱이라는 이름으로 서로 다른 두 가지가 판매되고 있으며, 팀들은 하나를 사 놓고 다른 하나를 기대하는 일이 자주 있습니다. 프롬프트 캐싱은 반복되는 프롬프트 앞부분을 더 싸게 읽도록 해 주는 공급자 기능입니다. 시맨틱 캐싱은 직접 운영하는 계층으로, 질문에 메모리에서 답하여 모델을 아예 호출하지 않게 합니다. 두 가지는 청구서의 서로 다른 절반을 해결하며, 함께 쓸 때 가장 효과적입니다.
요약. 프롬프트 캐싱은 긴 시스템 프롬프트처럼 프롬프트의 반복되는 앞부분을 할인해 주지만, 모델은 여전히 실행되고 출력 토큰은 모두 비용을 내야 합니다. 완전 일치 캐싱과 시맨틱 캐싱은 이미 답한 적이 있는 질문에 대해 호출 자체를 없앱니다. 공급자의 프롬프트 캐싱을 이미 켜 둔 3,000건 요청 벤치마크에서 HotKV를 앞에 두자 모델 호출, 토큰, 비용이 약 70% 줄었습니다. 출력 토큰이 기준선 비용의 73%~92%를 차지했기 때문입니다.
프롬프트 캐싱의 작동 방식
프롬프트 캐싱은 모델 공급자 쪽에 있습니다. 요청에서 변하지 않는 앞부분, 보통은 도구와 시스템 프롬프트를 표시해 두면 공급자가 그 처리 결과를 잠시 저장합니다. 이후 똑같은 텍스트로 시작하는 요청은 그 부분에 대해 낮은 요율로 청구됩니다. 여기서는 저희가 측정한 Anthropic의 방식을 설명합니다. 아래 내용은 프롬프트 캐싱 문서를 2026년 10월 18일에 확인하여 정리한 것입니다.
캐시되는 대상
적중하려면 정확히 일치해야 합니다. cache_control로 표시한 블록까지 모든 블록이 도구, 시스템 프롬프트, 메시지 순서로 동일해야 합니다. 프롬프트 앞쪽에서 한 글자만 바뀌어도 그 뒤는 전부 미스가 됩니다. 질문 자체는 맨 마지막에 오므로 캐시되는 앞부분에 포함되지 않습니다.
최소 길이에 못 미치는 프롬프트는 캐시되지 않으며 오류도 반환되지 않습니다. 저희가 사용한 현재 Claude 모델인 Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5의 문서상 최소 길이는 512토큰입니다. 캐시 항목은 조직별로 분리되며, Claude API에서는 워크스페이스별로도 분리됩니다.
비용
기본 수명은 5분이며, 항목을 사용할 때마다 추가 요금 없이 수명이 갱신됩니다. 1시간 수명도 선택할 수 있습니다. 항목을 쓰는 비용은 기본 입력 가격의 5분 수명일 때 1.25배, 1시간 수명일 때 2배입니다. 읽는 비용은 요금 페이지에 따르면 대부분의 모델에서 기본 입력 가격의 0.1배, Opus 5.5와 Sonnet 5.5에서 0.05배, Fable 5.1에서 0.025배입니다. 이 배율은 바뀔 수 있으므로 계산하기 전에 현재 페이지를 확인하십시오.
프롬프트 캐싱이 없앨 수 없는 것
프롬프트 캐싱은 앞부분을 읽는 비용을 깎아 줄 뿐, 모델을 건너뛰지는 않습니다. 요청마다 여전히 새 답변을 만들어 내야 하고, 그 답변을 기다려야 하며, 출력 토큰은 모두 정가로 청구됩니다.
저희 벤치마크는 이것이 얼마나 중요한지 보여 줍니다. 2,200토큰 분량의 정책을 시스템 프롬프트로 두고 공급자 캐싱을 켠 상태에서, Claude 모델 4개에 각각 고객 지원 질문 3,000개를 보냈습니다. 집계된 토큰의 90%~93%는 그 정책의 캐시 읽기였습니다. 출력은 토큰의 6%~9%에 불과했지만 기준선 비용의 73%~92%를 차지했습니다. 앞부분은 이미 저렴했으므로, 남은 지출은 답변에 있었습니다.
다른 계층이 채우는 부분이 바로 이 공백입니다. 전체 방법과 결과는 토큰 절감 벤치마크에 있습니다.
완전 일치 응답 캐싱과 시맨틱 응답 캐싱
두 계층 모두 요청에 메모리에서 답합니다. 새 요청이 이전 요청과 일치한다고 판단하는 방식이 다릅니다.
완전 일치 응답 캐싱
완전 일치 캐시는 최종 답변을 그 답변을 결정하는 모든 요소로 만든 키 아래에 저장합니다. 보통은 모델, 프롬프트 버전, 정규화한 질문입니다. 같은 요청이 다시 들어오면 저장된 답변을 반환하고 모델은 호출하지 않습니다. 유사도 점수도 없고, 다른 질문을 위한 답변이 반환될 위험도 없습니다.
저희 실행에서 완전 일치 캐시는 요청의 약 39%에 응답했습니다. 반복된 질문은 중앙값 약 0.05 ms 만에 돌아왔습니다. 이는 같은 머신에서 루프백을 통해 Python 클라이언트로 측정한 값이므로 네트워크 수치가 아니라 로컬 수치로 읽으십시오. 벤치마크는 이 계층에 일반 GET과 SET을 사용했습니다. HotKV Enterprise에는 네임스페이스별 한도와 비용 추적을 갖춘 전용 완전 일치 프롬프트 캐시 PCACHE.*도 있습니다.
완전 일치 캐싱은 표현이 다르면 알아보지 못합니다. "How do I reset my password?"와 "I forgot my password"는 서로 다른 키입니다.
시맨틱 캐싱
시맨틱 캐시는 질문의 의미로 조회합니다. 질문을 임베딩으로 바꾸고, 가장 가까운 저장된 질문을 찾아, 코사인 유사도가 임계값을 넘으면 그 답변을 반환합니다. HotKV에서는 벡터 검색과 같은 벡터 인덱스를 기반으로 만든 SCACHE.*가 이 역할을 합니다.
저희 요청의 약 31%가 이 방식으로 응답되었습니다. 바꿔 말한 질문은 중앙값 약 130 ms가 걸렸으며, 그중 거의 전부가 임베딩 서비스 호출 시간이었으므로, 시맨틱 적중은 모델 호출보다 훨씬 빠르지만 즉각적이지는 않습니다. 시맨틱 계층이 없었다면 완전 일치 캐시만으로는 3,000건 중 최대 1,264건의 모델 호출이 필요했을 것이며, 이는 약 58% 적은 수치입니다. 시맨틱 계층이 절감 효과를 약 70%로 끌어올렸습니다.
위험도 이곳에 있습니다. 비슷한 질문이 항상 같은 질문은 아닙니다. 저희는 두 번째 Claude 모델에게 모든 시맨틱 적중을 새 답변과 비교해 판정하게 했습니다. 기본 임계값 0.81에서 캐시된 답변이 정확한 질문에 맞는 비율은 새 답변보다 5.8~10.7퍼센트포인트 낮았습니다. Sonnet 5.5에서는 0.88 이상의 임계값에서 이러한 격차가 나타나지 않았지만 근거는 빈약합니다. 결정적인 세부 사항 하나만 다르게 작성한 질문도 0.81에서는 62%, 0.95에서는 10%가 여전히 일치로 처리되었습니다.
프롬프트 캐싱과 시맨틱 캐싱 나란히 비교
| 공급자 프롬프트 캐싱 | 완전 일치 응답 캐시 | 시맨틱 캐시 | |
|---|---|---|---|
| 없애는 것 | 입력 가격의 일부 | 모델 호출 전체 | 모델 호출 전체 |
| 일치 규칙 | 동일한 앞부분 | 동일한 요청 | 임계값 이상으로 의미가 유사함 |
| 출력 토큰 청구 | 예, 매번 | 아니요, 적중 시 | 아니요, 적중 시 |
| 오답 위험 | 없음 | 동일한 요청에는 없음 | 실재하며 임계값으로 조절 |
| 실행 위치 | 공급자 쪽 | 직접 운영하는 캐시 | 직접 운영하는 캐시와 임베딩 호출 |
| 저희 실행에서 요청 비중 | 항상 켜짐 | 약 39% | 약 31% |
공급자 프롬프트 캐싱과 응답 캐싱은 서로 대안이 아닙니다. 하나는 계속 하게 되는 호출의 가격을 낮추고, 다른 하나는 호출 횟수를 줄입니다.
캐싱이 지연 시간에 미치는 영향
모델을 건너뛰면 비용뿐 아니라 답변이 도착하는 속도도 달라집니다. 저희 실행에서 완전한 답변까지의 응답 시간 중앙값은 Fable 5.1에서 2.7초에서 127 ms로, Opus 5.5에서 2.9초에서 126 ms로, Sonnet 5.5에서 1.8초에서 128 ms로, Haiku 5.5에서 1.4초에서 125 ms로 줄었습니다. 중앙값 기준으로 11~23배 빨라진 것입니다.
느린 쪽은 거의 움직이지 않았습니다. 요청의 약 30%는 여전히 모델에 도달했고, Fable 5.1의 99번째 백분위수는 HotKV 사용 시 약 6.4초, 미사용 시 6.6초였습니다. 캐시는 자신이 응답하는 요청의 대기 시간을 없애 주지만, 놓친 요청에는 아무 효과가 없습니다. 불만이 평소가 아니라 최악의 경우가 느리다는 것이라면 캐싱만으로는 해결되지 않습니다.
이 시간은 호출을 스트리밍하지 않았기 때문에 완전한 답변까지의 시간입니다. 스트리밍 답변은 첫 단어가 더 일찍 나타납니다. 채팅 창에서 체감하는 차이는 이 수치의 차이보다 작습니다.
트래픽에 맞는 계층 선택
적절한 계층은 요청이 어떻게 반복되느냐에 달려 있으며, 무언가를 만들기 전에 그것을 측정할 수 있습니다.
트래픽에 맞는 계층 고르기
요청이 반복되는 방식에 계층을 맞추십시오.
- 길고 변하지 않는 시스템 프롬프트나 도구 목록: 공급자 프롬프트 캐싱을 사용하십시오. 켜는 데 드는 비용이 적고 답변을 바꾸지 않습니다.
- 버튼, 템플릿, 재시도처럼 같은 질문이 같은 단어로 들어오는 경우: 완전 일치 응답 캐시를 사용하십시오. 안전하고 빠릅니다.
- 사람들이 같은 내용을 다른 말로 묻는 지원, 검색, FAQ 트래픽: 시맨틱 캐시를 추가하고 임계값을 높게 설정하며, 신뢰하기 전에 자체 질문으로 답변 품질을 확인하십시오.
- 사용자, 시각, 실시간 데이터에 따라 달라지는 답변: 캐시하지 말거나, 답변을 바꾸는 요소를 캐시 키에 넣으십시오.
절감액은 반복률을 따라갑니다. 모든 인텐트가 같은 확률로 나오도록 바꾸자, 다시 실행한 두 모델에서 비용이 56% 줄었고, 모두 다른 질문 3,000개로는 38% 줄었습니다. 반복되거나 유사한 질문이 없는 워크로드는 아무것도 절감하지 못합니다.
먼저 자신의 반복률 측정하기
무언가를 만들기 전에 트래픽의 얼마나 많은 부분이 반복되는지 알아보십시오. 이 수치가 완전 일치 캐시를 둘 만한 가치가 있는지 결정합니다. 이미 기록해 둔 질문만 있으면 10분이면 됩니다. 캐시 키와 같은 방식으로 각 질문을 정규화하고, 서로 다른 질문의 수를 세어, 트래픽 중 얼마나 많은 부분이 반복이었는지 확인하십시오.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share는 각 질문을 처음 한 번 본 뒤라면 완전 일치 캐시가 응답했을 요청의 비율입니다. 저희 테스트 세트는 요청 3,000건 중 서로 다른 질문이 1,264개였으므로 수치는 약 58%였습니다. 여러분의 수치가 5% 근처라면 완전 일치 캐시는 거의 도움이 되지 않으며, 시맨틱 계층만 도움이 될 수 있습니다.
주의할 점이 두 가지 있습니다. 캐시는 빈 상태에서 시작하므로 초기 요청은 항상 모델에 도달합니다. 저희 실행에서는 처음 천 건의 약 52%, 마지막 천 건의 약 81%가 캐시로 응답되었습니다. 또한 지난달 트래픽 기록은 지난달에 대해서만 알려 줍니다. 사람들이 묻는 내용을 바꿀 기능을 곧 출시한다면 이 수치는 대략적인 참고로만 보십시오.
계층 결합하기
요청은 가장 저렴하고 안전한 계층부터 가장 비싼 계층까지 순서대로 거쳐야 하며, 각 계층이 얼마나 절감했는지 볼 수 있어야 합니다.
조회 순서
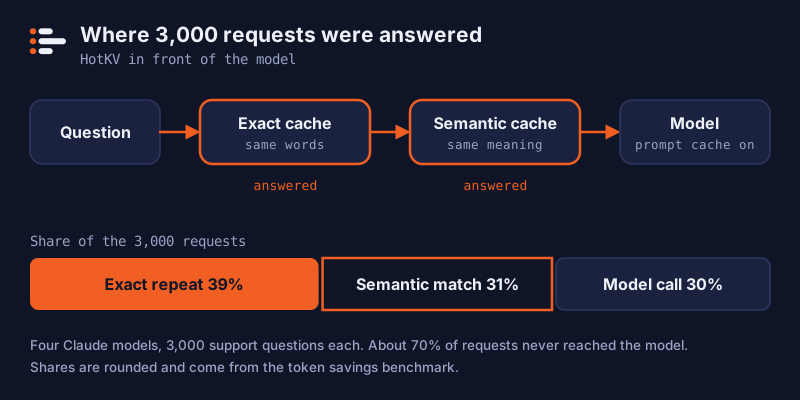
순서가 중요합니다. 가장 저렴하고 안전한 계층을 먼저 확인하고, 모두 미스일 때만 모델을 호출하십시오. 이 예시는 decode_responses=True를 설정한 redis-py 방식 클라이언트, 미리 만들어 둔 네임스페이스 두 개, 그리고 직접 작성한 embed 및 llm 함수를 가정합니다.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # 같은 단어

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # 같은 의미

    reply = llm.complete(question)                   # 여기서는 공급자 프롬프트 캐싱이 적용됩니다
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
네임스페이스는 PCACHE.CREATE answers_exact와 SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90으로 한 번만 만드십시오. 차원 값은 사용하는 임베딩 모델의 차원으로 바꾸십시오. AI 명령어 세트는 HotKV Cloud의 Performance 및 Scale 인스턴스에 포함되며, 각 엔진의 기능은 AI 페이지에 정리되어 있습니다. 요금 페이지에서 플랜별 포함 내용을 확인할 수 있습니다.
운영 환경에서 성과 추적하기
볼 수 없는 캐시는 신뢰할 수 없는 캐시입니다. HotKV는 네임스페이스별로 적중 및 미스 횟수를 기록합니다. 항목마다 원래 호출의 토큰 사용량을 함께 저장하면, 이후의 적중마다 회피한 토큰과 비용도 집계할 수 있습니다. 그러면 PCACHE.STATS와 SCACHE.STATS 응답에 usage_saved_requests, usage_saved_input_tokens, usage_saved_cost_usd 같은 필드가 포함됩니다.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
<model>은 사용하는 모델의 id로 바꾸십시오. INPUT은 캐시되지 않은 프롬프트 토큰을, CACHEREAD는 공급자가 자체 캐시에서 제공한 토큰을 센 값이므로 둘은 겹치지 않습니다. 비용 필드가 의미를 가지려면 모델이 HotKV 가격표에 있어야 합니다. LLMSTATS.PRICE LIST는 알려진 모델을 보여 주고, LLMSTATS.PRICE SET은 직접 모델을 추가합니다. 가격이 없는 모델도 토큰은 집계되지만 비용은 0으로 기록되며, 별도의 카운터가 가격이 없는 요청이 있었음을 알려 줍니다.
캐시는 지출을 줄이고, 예산은 남은 지출의 상한을 정합니다. LLMBUDGET.SET은 시간 구간에 대한 토큰 및 달러 한도를 정의합니다. LLMBUDGET.CONSUME은 모델을 호출하기 전에 확인하므로, 폭주하는 에이전트가 돈을 쓰고 난 뒤가 아니라 쓰기 전에 멈춥니다. LLMSTATS.RECORD는 공급자의 캐시 읽기 및 캐시 쓰기 토큰을 이해하는 테넌트별 합계를 보관합니다. 세 가지 모두 모델 이름을 전달하면 하나의 가격표를 사용하므로, 절감액, 예산, 대시보드 수치가 서로 어긋날 수 없습니다.
캐시가 오답을 반환하게 만드는 실수
잘못된 캐시 적중은 대부분 키에 무언가가 빠져 있어서 생깁니다. 모델, 프롬프트 버전, 도구나 정책 버전을 완전 일치 키에 넣으면, 프롬프트가 바뀌어도 이전 프롬프트용으로 작성된 답변이 제공되지 않습니다.
항목의 수명은 사실이 바뀌는 속도에 맞추십시오. 한 고객의 답변이 다른 고객에게 제공되는 일이 없도록 네임스페이스를 분리해 테넌트를 구분하십시오. 키에 누구의 데이터인지가 포함되어 있지 않다면 개인 정보가 담긴 답변은 절대 캐시하지 마십시오.
마지막으로, 자신의 트래픽에서 측정하십시오. 저희 수치는 짧은 은행 업무 질문으로 구성된 공개 데이터셋 하나, 가상의 정책, 조건당 한 번의 실행에서 나온 것이며, 여러분의 워크로드에 대한 약속이 아닙니다.
자주 묻는 질문
프롬프트 캐싱이란 무엇입니까?
프롬프트 캐싱은 모델 공급자가 프롬프트의 처리된 앞부분을 잠시 저장하는 기능입니다. 이후 똑같은 텍스트로 시작하는 요청은 그 부분에 대해 더 낮은 요율로 청구됩니다. 모델은 여전히 실행되어 새 답변을 만들기 때문에 출력 토큰 비용은 계속 냅니다.
프롬프트 캐싱과 시맨틱 캐싱은 같은 것입니까?
아닙니다. 프롬프트 캐싱은 반복되는 프롬프트 앞부분을 재사용하되 여전히 모델을 호출합니다. 시맨틱 캐싱은 의미가 비슷한 질문에 저장된 답변을 반환하고 모델 호출을 건너뜁니다. 두 방식은 서로 다른 비용을 다루며 함께 사용할 수 있습니다.
프롬프트 캐싱은 출력 토큰 비용을 줄여 줍니까?
아니요. 캐시된 앞부분을 읽는 가격만 낮춥니다. 저희 벤치마크에서는 프롬프트 캐싱을 이미 켠 상태에서 출력이 토큰의 6%~9%였지만 기준선 비용의 73%~92%를 차지했으며, 그래서 답변 전체를 캐싱하는 쪽이 훨씬 더 많이 절감했습니다.
Anthropic의 프롬프트 캐시는 얼마나 유지됩니까?
기본값은 5분이며 항목을 사용할 때마다 갱신됩니다. 더 높은 쓰기 가격으로 1시간 옵션을 사용할 수 있습니다. 한도와 가격은 바뀔 수 있으므로 현재 문서를 확인하십시오.
프롬프트 캐싱과 시맨틱 캐싱을 함께 사용할 수 있습니까?
예, 저희 벤치마크도 정확히 그렇게 했습니다. 두 실행 모두 공급자 프롬프트 캐싱을 켜 두었고, 완전 일치 계층과 시맨틱 계층은 모델 앞에 위치했습니다. 캐시 적중은 호출을 건너뛰고, 미스는 여전히 할인된 앞부분의 혜택을 받습니다.
시맨틱 캐시에는 어떤 유사도 임계값을 사용해야 합니까?
보편적인 값은 없습니다. 저희는 별도의 학습 분할에서 0.81을 골랐고, Sonnet 5.5에서는 0.88 이상에서 캐시된 답변이 새 답변에 비해 품질 격차를 보이지 않았지만 근거는 빈약합니다. 높게 시작하여 자신의 질문으로 캐시된 답변을 새 답변과 비교 평가하고, 품질이 유지될 때만 임계값을 낮추십시오.

대화 이어가기
댓글
방법에 대해 궁금한 점이 있으십니까? 사용하시는 하드웨어에서 다른 결과가 나왔습니까? 발견한 내용을 공유해 주십시오. 댓글은 검토 후에 게시됩니다.