

A memória de agentes de IA é o que permite a um agente levar algo de um passo, ou de uma sessão, para o seguinte. Um modelo de linguagem sozinho não se lembra de nada entre as chamadas. Tudo o que ele parece lembrar foi recolocado no prompt pelo seu código. A forma como você armazena e recupera esse material decide o que o agente consegue recordar, com que rapidez e a que custo por turno.
Em resumo. Os agentes precisam de quatro tipos de memória: uma janela curta de conversa, fatos de longo prazo encontrados pelo significado, um rascunho para a tarefa em andamento e um log do que aconteceu. Cada um tem uma forma, um tempo de vida e uma consulta diferentes, então uma única tabela de memória não serve bem a nenhum deles. O HotKV guarda os quatro em um único motor em memória, com os comandos
AMEM.*. Fizemos benchmarks do cache e da busca vetorial do HotKV, não da memória de agentes, então este artigo explica o design e não afirma nenhum ganho de velocidade.
Por que uma janela de contexto não é memória
Uma janela de contexto é o texto que você envia a cada requisição. Ela tem um limite de tamanho, você paga tokens de entrada por tudo o que há nela a cada turno, e ela desaparece quando a sessão termina. Também não dá para pesquisar nela. Se um agente precisa de um único fato de três semanas atrás, colar o histórico inteiro não é uma resposta.
A memória é a camada que decide o que entra na janela em seguida. Ela mantém os turnos recentes e encontra os poucos fatos antigos que importam. Guarda o estado da tarefa atual e registra o que o agente fez. Os pesquisadores descrevem os agentes em termos parecidos. O framework CoALA, de Sumers, Yao, Narasimhan e Griffiths, separa a memória de trabalho das memórias de longo prazo episódica, semântica e procedural.
Os quatro tipos de memória de agentes de IA
Os quatro armazenamentos do HotKV cobrem quase o mesmo território, adaptado ao que uma aplicação precisa construir. A memória procedural, o saber fazer que fica no código e nos prompts do agente, normalmente mora no seu repositório ou em um registro de prompts e não é um armazenamento à parte.
Memória de conversa
É a transcrição de curto prazo de uma sessão. As mensagens têm um papel (system, user, assistant ou tool). Elas ficam em uma janela deslizante com limite, então os turnos mais antigos saem quando o limite é atingido. Ela responde a uma pergunta. O que foi dito há pouco? No HotKV isso é AMEM.CONV.CREATE, AMEM.CONV.APPEND e AMEM.CONV.WINDOW.
Memória semântica
A memória semântica é conhecimento de longo prazo guardado como fatos com um vetor de embedding. O agente os recupera pelo significado, não por chave. Ela é sustentada por um índice vetorial HNSW, do mesmo tipo que alimenta a busca vetorial. AMEM.SEM.STORE salva um fato e AMEM.SEM.RECALL devolve as melhores correspondências com uma pontuação de similaridade. É aqui que ficam documentos, preferências do usuário e correções aprendidas.
Memória de trabalho
A memória de trabalho é o rascunho de uma tarefa em andamento, um conjunto simples de chaves e valores restrito a uma sessão. Ela guarda o passo atual, o ticket em atendimento ou um resultado parcial. Deve desaparecer quando a tarefa termina. O AMEM.WORK.SET aceita um tempo de vida (TTL) exatamente por isso.
Memória episódica
A memória episódica é um log somente de acréscimo de eventos com carimbo de data e hora, como uma ação executada, uma observação feita ou uma decisão tomada. Ela permite que um agente, ou uma pessoa que o revisa, pergunte o que aconteceu e quando. AMEM.EPIS.LOG grava um evento e AMEM.EPIS.QUERY os lê de volta por tipo e intervalo de tempo.
Memória de agentes de IA na prática
Duas coisas importam na prática. Como você escreve na memória e o que você lê de volta a cada turno.
Armazenando memória com comandos
Aqui está um agente de suporte atendendo uma conversa. O texto da política fictícia e os vetores de três números servem apenas de ilustração. Um modelo de embedding real produz vetores de 768 ou 1.536 números, e você cria o namespace com essa dimensão.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
A cada turno, o agente lê a janela recente e recupera os poucos fatos que correspondem à pergunta. Ele confere a sua nota de trabalho e monta o prompt com essas peças. Depois de agir, registra o evento. Nada nesse ciclo precisa do histórico inteiro.
Lendo a memória a cada turno
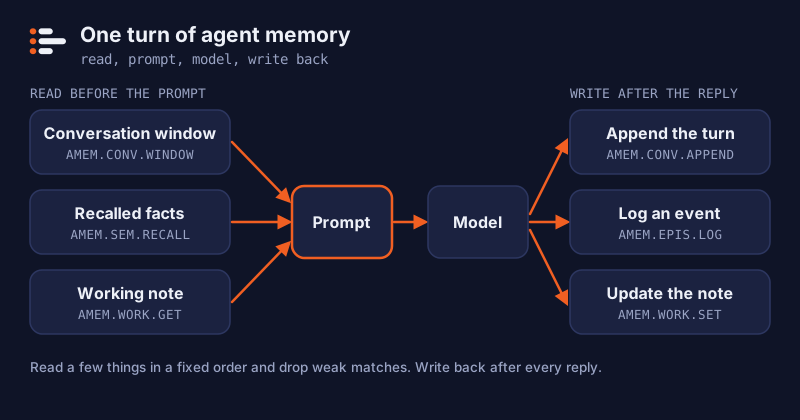
Armazenar memória é a metade fácil. A habilidade está em decidir o que ler de volta, porque tudo o que você lê vai para o prompt e custa tokens de entrada. Um ciclo razoável lê um punhado de coisas em uma ordem fixa. Primeiro vêm os turnos recentes, depois os poucos fatos que correspondem à pergunta, depois o estado da tarefa. Aqui está ele com o cliente Python oficial, com a sua própria função de embedding e o seu próprio modelo de prompt.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # ajuste com os seus próprios dados

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # crie uma vez, antes do primeiro append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # o seu modelo de prompt

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
O corte de similaridade é seu para ajustar. Um valor que serve a um modelo de embedding e a um conjunto de fatos estará errado para outro, então confira a recuperação em perguntas cujas respostas você conhece. Descartar as correspondências fracas importa mais do que parece, porque um fato ruim no prompt é pior do que nenhum fato.
As partes estáveis desse prompt, como as instruções de sistema, são também a parte que o cache de prompts do provedor torna mais barata. Coloque a memória que você lê no final, depois do texto estável, para que mudá-la não invalide esse cache.
Resumos em vez de janelas cada vez mais longas
Uma janela descarta por completo os turnos antigos. Isso é bom para conversa casual e ruim para uma tarefa longa, em que o turno 3 ainda pode importar no turno 300. Um resumo contínuo é a resposta usual. Depois de cada trecho de conversa, o agente, ou um modelo mais barato, anota o que foi aprendido, e o resumo substitui os turnos antigos no prompt.
O HotKV mantém um resumo por agente com AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND e AMEM.SUMMARY.GET. O SET substitui o texto e o APPEND acrescenta uma linha. Cada atualização aumenta um número de versão, então outro componente consegue saber a baixo custo que o resumo mudou e quando.
Um resumo perde informação, e resumir um resumo perde mais a cada vez. Mantenha valores exatos, como identificadores, valores monetários e datas, fora da prosa e na memória de trabalho ou nos fatos semânticos, onde eles sobrevivem. Use o resumo para o formato do trabalho, como preferências, decisões tomadas e o que falta fazer.
Regras de design e retenção
A memória cresce sem limite a menos que você a detenha, então defina os limites antes da primeira gravação.
Regras que mantêm a memória útil
- Limite tudo. Defina uma
WINDOWnas conversas e umTTLnas sessões e nos valores de trabalho. Para conversas, valores de trabalho e fatos, o HotKV registra o horário de expiração para o arquivo append-only e para as réplicas, de modo que uma entrada expirada não volta quando o arquivo é reproduzido após uma reinicialização. - Guarde fatos, não transcrições. Resuma antes de gravar na memória semântica. Um fato é mais fácil de recuperar do que uma página de diálogo.
- Mantenha os agentes separados. Use um identificador ou namespace distinto por agente e por tenant, para que a memória de um cliente nunca seja recuperada para outro.
- Recupere poucos, não muitos. Pegue as três a cinco melhores correspondências e descarte as fracas pela pontuação de similaridade antes de elas entrarem no prompt.
- Deixe os segredos de fora. A memória é lida de volta nos prompts, então nunca guarde senhas, chaves ou dados que você não mostraria ao modelo.
Quanto tempo manter cada tipo
Esses tempos de vida são sugestões nossas, não padrões. Escolha os seus conforme a rapidez com que os fatos de base mudam e o que você tem permissão para guardar.
| Tipo de memória | Tempo de vida sugerido | Controles no HotKV |
|---|---|---|
| Conversa | A sessão, ou um período fixo, como um dia | WINDOW e TTL no AMEM.CONV.CREATE |
| Trabalho | A tarefa, e depois é limpa | TTL no AMEM.WORK.SET e AMEM.WORK.CLEAR |
| Semântica | Até o fato deixar de ser verdadeiro | TTL no AMEM.SEM.STORE e AMEM.SEM.FORGET |
| Episódica | Pelo tempo que as suas necessidades de auditoria ou de suporte exigirem | AMEM.EPIS.QUERY por intervalo de tempo e AMEM.EPIS.CLEAR (os eventos não têm tempo de vida) |
A retenção também é uma questão de privacidade. Se a memória guarda qualquer coisa sobre uma pessoa, o tempo de vida que você escolhe faz parte do que você promete a ela, então deixe isso por escrito.
Como a memória de agentes dá errado
A maioria dos bugs de memória é lenta. O agente funciona bem por uma semana e depois começa a piorar. Estas são as falhas contra as quais projetar.
Falhas comuns
- Fatos desatualizados. Um fato que era verdadeiro em março é recuperado em outubro. Dê aos fatos um tempo de vida, ou guarde-os sob uma chave por entidade, para que o valor novo sobrescreva o antigo.
- Contradições. Dois fatos guardados discordam, e o agente escolhe um ao acaso. Prefira um fato por chave a acrescentar notas novas ao lado das antigas.
- Recuperação em excesso. Correspondências demais enchem o prompt de texto pouco relacionado. Recupere poucos e descarte as correspondências fracas.
- Vazamentos entre usuários. A memória de um cliente é recuperada para outro. Use identificadores ou namespaces separados para cada tenant, verificados no código antes de toda leitura.
- Crescimento sem limite. Nada nunca expira, então as consultas ficam lentas e os custos sobem aos poucos. Todo tipo precisa de um tempo de vida. Onde o HotKV não tem tempo de vida, como no log episódico, agende você mesmo uma limpeza ou uma exportação.
- Deriva do resumo. Um resumo de um resumo deixa aos poucos de corresponder ao que aconteceu. Mantenha o log de eventos como fonte da verdade e gere os resumos de novo a partir dele.
Trate o texto armazenado como não confiável
O último ponto merece mais atenção. Tudo o que um agente grava na memória pode ser lido para dentro de um prompt mais tarde. Isso inclui texto que veio de uma página da web, de um e-mail ou de um usuário. Essa é a forma indireta de injeção de prompt que o OWASP lista como LLM01. Guarde a origem junto com cada fato. Confie menos na memória escrita a partir de conteúdo externo e nunca deixe uma nota recuperada se sobrepor ao seu prompt de sistema.
O que medimos e o que não medimos
Os benchmarks publicados do HotKV cobrem o throughput de comandos, a busca vetorial e a economia de tokens do cache de respostas. A memória de agentes ainda não tem um benchmark próprio. Não fazemos nenhuma afirmação sobre a latência dela nem sobre o quanto ela melhora a qualidade do agente. O que podemos dizer é arquitetural. Os quatro armazenamentos rodam no mesmo processo que o cache e o índice vetorial. Uma consulta de memória é uma única chamada a um sistema que você já opera.
O benchmark de economia de tokens e a comparação entre cache de prompts e cache semântico mostram o lado medido. O caso de uso de memória de agentes mostra os comandos em um cenário completo.
Usando a memória de agentes a partir do Claude Code ou do Cursor
Um assistente que suporta o Model Context Protocol pode usar parte dessa memória sem código personalizado. O servidor de código aberto hotkv-mcp expõe como ferramentas a memória de conversa, as notas de trabalho, um log de eventos e um resumo contínuo. Ele tem um modo somente leitura e um namespace que confina o agente. Não expõe a memória semântica, e as suas ferramentas não conseguem definir uma janela nem um tempo de vida, então use a biblioteca cliente para isso. O próximo artigo, um servidor MCP para memória de agentes, mostra como conectá-lo e o que as suas salvaguardas cobrem.
Perguntas frequentes
O que é memória de agentes de IA?
A memória de agentes de IA é a camada de armazenamento e recuperação que permite a um agente manter informações entre passos e sessões. Normalmente combina uma janela de conversa recente, fatos de longo prazo encontrados pelo significado, um rascunho para a tarefa atual e um log de eventos.
Qual é a diferença entre a memória de curto prazo e a de longo prazo de um agente?
A memória de curto prazo guarda o que está acontecendo agora, como os turnos recentes e o estado da tarefa, e é limitada e temporária. A memória de longo prazo guarda o conhecimento que deve durar mais que uma sessão, como fatos, preferências e eventos passados, e é pesquisada quando necessário.
O que é um resumo contínuo na memória de agentes?
Um resumo contínuo é uma descrição curta e corrente do que um agente aprendeu ou decidiu até agora, atualizada conforme o trabalho avança. Ele substitui os turnos antigos no prompt, para que o prompt não pare de crescer. O HotKV guarda um por agente e aumenta um número de versão a cada atualização.
Preciso de um banco de dados vetorial para a memória de agentes?
Só para a memória semântica, em que os fatos são encontrados pelo significado. Janelas de conversa, estado de trabalho e logs de eventos não precisam de vetores. O HotKV guarda os quatro em um único motor, então o índice vetorial e os demais armazenamentos não são sistemas separados.
Por quanto tempo a memória de agentes deve ser mantida?
Depende do tipo. A memória de trabalho deve expirar quando a tarefa termina, as conversas depois da sessão ou de um período definido, e os logs episódicos pelo tempo que as suas necessidades de auditoria exigirem. Os fatos na memória semântica devem ser revisados e removidos quando deixam de ser verdadeiros.
A memória de agentes pode ser atacada?
Pode. O texto gravado na memória é lido depois para dentro de prompts, então uma nota envenenada pode desviar o agente. Registre de onde veio cada fato, confie menos em conteúdo externo e mantenha a memória recuperada abaixo do seu prompt de sistema em autoridade.
O HotKV guarda a memória de agentes na RAM?
O HotKV é um motor em memória, então as leituras são servidas da memória. As gravações nos quatro armazenamentos são registradas para o arquivo append-only e para as réplicas, com os horários de expiração mantidos, segundo a documentação do produto.

Continue a conversa
Comentários
Dúvidas sobre o método? Um resultado diferente no seu hardware? Compartilhe o que você encontrou. Os comentários são revisados antes de aparecer.