

Duas coisas diferentes são vendidas como cache para modelos de linguagem, e as equipes costumam comprar uma esperando receber a outra. O cache de prompts é um recurso do provedor que torna mais barata a leitura de um prefixo de prompt repetido. O cache semântico é uma camada que você mesmo executa e que responde a uma pergunta a partir da memória, de modo que o modelo nem chega a ser chamado. Eles resolvem metades diferentes da conta e funcionam melhor juntos.
Em resumo. O cache de prompts dá desconto no início repetido de um prompt, como um prompt de sistema longo, mas o modelo continua rodando e você continua pagando por cada token de saída. O cache exato e o cache semântico eliminam a chamada por completo quando uma pergunta já foi respondida antes. No nosso benchmark de 3.000 requisições, com o cache de prompts do provedor já ativado, colocar o HotKV na frente reduziu as chamadas ao modelo, os tokens e o custo em cerca de 70%, porque os tokens de saída ainda eram de 73% a 92% do custo da baseline.
Como funciona o cache de prompts
O cache de prompts fica no provedor do modelo. Você marca o início estável de uma requisição, normalmente as ferramentas e o prompt de sistema, e o provedor guarda a forma já processada dele por um curto período. A próxima requisição que começar com exatamente o mesmo texto é cobrada a uma taxa reduzida por essa parte. Descrevemos aqui a versão da Anthropic porque foi a que medimos. Os detalhes abaixo vêm da documentação de cache de prompts dela, consultada em 18 de outubro de 2026.
O que entra no cache
Um acerto exige correspondência exata. Todo bloco até o bloco marcado com cache_control, inclusive, precisa ser idêntico, na ordem ferramentas, prompt de sistema e depois mensagens. Troque um único caractere no início do prompt e tudo o que vem depois é uma falha. A pergunta em si vem por último, então nunca faz parte do prefixo em cache.
Prompts abaixo de um comprimento mínimo não entram no cache, e nenhum erro é retornado. Nos modelos Claude atuais que usamos, Fable 5.1, Opus 5.5, Sonnet 5.5 e Haiku 5.5, o mínimo documentado é de 512 tokens. As entradas de cache são isoladas por organização e, na API do Claude, por workspace.
Quanto custa
O tempo de vida padrão é de cinco minutos, e cada uso da entrada o renova sem custo extra. Também existe a opção de uma hora. Gravar uma entrada custa 1,25 vez o preço base de entrada para cinco minutos e 2 vezes para uma hora. Ler custa 0,1 vez o preço base de entrada na maioria dos modelos, 0,05 vez no Opus 5.5 e no Sonnet 5.5 e 0,025 vez no Fable 5.1, segundo a página de preços. Esses multiplicadores mudam, então leia a página atual antes de fazer qualquer conta.
O que o cache de prompts não consegue eliminar
O cache de prompts dá desconto na leitura do prefixo. Ele não pula o modelo. Cada requisição ainda gera uma resposta nova, você ainda espera por ela e cada token de saída é cobrado pelo preço cheio de saída.
O nosso benchmark mostra o quanto isso pesa. Enviamos 3.000 perguntas de suporte ao cliente a cada um de quatro modelos Claude, com uma política de 2.200 tokens como prompt de sistema e o cache do provedor ativado. De 90% a 93% dos tokens contados eram leituras de cache dessa política. A saída era de apenas 6% a 9% dos tokens, mas de 73% a 92% do custo da baseline. O prefixo já era barato, então o gasto restante estava nas respostas.
Essa é a lacuna que as outras camadas preenchem. O método completo e os resultados estão no benchmark de economia de tokens.
Cache de respostas exato e semântico
Duas camadas respondem a uma requisição a partir da memória. Elas diferem na forma de decidir que uma requisição nova corresponde a uma antiga.
Cache de respostas exato
Um cache exato guarda a resposta final sob uma chave construída a partir de tudo o que a molda. Normalmente isso é o modelo, a versão do prompt e a pergunta normalizada. Quando a mesma requisição chega de novo, a resposta guardada é devolvida e o modelo não é chamado. Não há pontuação de similaridade e não há risco de devolver uma resposta pensada para outra pergunta.
Na nossa execução, o cache exato respondeu a cerca de 39% das requisições. Uma pergunta repetida voltou em uma mediana de cerca de 0,05 ms. Isso foi medido com um cliente Python via loopback na mesma máquina, então leia como um valor local, não de rede. O benchmark usou GET e SET simples nesta camada. O HotKV Enterprise também tem um cache de prompts de correspondência exata dedicado, o PCACHE.*, com limites por namespace e controle de custos.
O cache exato é cego à redação. "How do I reset my password?" e "I forgot my password" são duas chaves diferentes.
Cache semântico
Um cache semântico consulta o significado da pergunta. Ele transforma a pergunta em um embedding, encontra a pergunta guardada mais próxima e devolve a resposta dela se a similaridade de cosseno passar de um limiar. No HotKV isso é o SCACHE.*, construído sobre o mesmo índice vetorial da busca vetorial.
Cerca de 31% das nossas requisições foram respondidas assim. Uma paráfrase levou uma mediana de cerca de 130 ms, quase tudo da chamada ao serviço de embedding, então um acerto semântico é bem mais rápido que uma chamada ao modelo, mas não é instantâneo. Sem a camada semântica, um cache exato sozinho teria precisado de no máximo 1.264 chamadas ao modelo em 3.000, cerca de 58% menos. A camada semântica levou a economia a cerca de 70%.
É também onde mora o risco. Uma pergunta parecida nem sempre é a mesma pergunta. Pedimos a um segundo modelo Claude que avaliasse cada acerto semântico contra uma resposta nova. No nosso limiar padrão de 0,81, as respostas em cache se adequaram à pergunta exata de 5,8 a 10,7 pontos percentuais menos vezes do que as novas. No Sonnet 5.5, limiares de 0,88 ou maiores não mostraram esse déficit, com evidência frágil. Perguntas escritas para diferir em um detalhe decisivo ainda corresponderam em 62% das vezes com 0,81 e em 10% com 0,95.
Cache de prompts vs. cache semântico lado a lado
| Cache de prompts do provedor | Cache de respostas exato | Cache semântico | |
|---|---|---|---|
| O que elimina | Parte do preço de entrada | A chamada inteira ao modelo | A chamada inteira ao modelo |
| Regra de correspondência | Prefixo idêntico | Requisição idêntica | Significado semelhante acima de um limiar |
| Tokens de saída cobrados | Sim, toda vez | Não, em um acerto | Não, em um acerto |
| Risco de resposta errada | Nenhum | Nenhum para requisições idênticas | Real, ajustado pelo limiar |
| Onde roda | No provedor | No seu cache | No seu cache, mais uma chamada de embedding |
| Parcela das requisições na nossa execução | Sempre ativo | Cerca de 39% | Cerca de 31% |
O cache de prompts do provedor e o cache de respostas não são alternativas. Um reduz o preço das chamadas que você ainda faz, e o outro reduz quantas chamadas você faz.
O que o cache faz com a latência
Pular o modelo muda a rapidez das respostas, além do que elas custam. Na nossa execução, o tempo mediano até uma resposta completa caiu de 2,7 segundos para 127 ms no Fable 5.1, de 2,9 segundos para 126 ms no Opus 5.5, de 1,8 segundo para 128 ms no Sonnet 5.5 e de 1,4 segundo para 125 ms no Haiku 5.5. Isso é de 11 a 23 vezes mais rápido na mediana.
A ponta lenta quase não se moveu. Cerca de 30% das requisições ainda chegaram ao modelo, e o percentil 99 no Fable 5.1 foi de cerca de 6,4 segundos com o HotKV contra 6,6 segundos sem ele. Um cache elimina a espera das requisições que ele responde e não faz nada pelas que ele deixa passar. Se a sua queixa é um pior caso lento, e não um caso típico lento, só o cache não resolve.
Esses são tempos até a resposta completa, porque as chamadas não usaram streaming. Uma resposta em streaming mostra as primeiras palavras mais cedo. Em uma janela de chat, a diferença é menor que a destes números.
Como escolher uma camada para o seu tráfego
A camada certa depende de como as suas requisições se repetem, e você pode medir isso antes de construir qualquer coisa.
Combine a camada com o tráfego
Combine a camada com a forma como as suas requisições se repetem.
- Um prompt de sistema longo e estável ou uma lista de ferramentas: use o cache de prompts do provedor. Custa pouco para ativar e não muda nenhuma resposta.
- A mesma pergunta com as mesmas palavras, como um botão, um modelo ou uma nova tentativa: use um cache de respostas exato. É seguro e rápido.
- Tráfego de suporte, busca e FAQ em que as pessoas perguntam a mesma coisa com palavras diferentes: adicione um cache semântico, defina o limiar alto e verifique a qualidade das respostas nas suas próprias perguntas antes de confiar nele.
- Respostas que dependem do usuário, do relógio ou de dados ao vivo: não coloque nenhuma em cache, ou monte a chave do cache com os fatos que mudam a resposta.
A economia acompanha a repetição. Quando tornamos todas as intenções igualmente prováveis, em vez de assimétricas, o custo caiu 56% nos dois modelos que executamos de novo, e com 3.000 perguntas todas diferentes caiu 38%. Uma carga de trabalho sem perguntas repetidas ou semelhantes não economiza nada.
Meça primeiro a sua própria repetição
Antes de construir qualquer coisa, descubra quanto do seu tráfego se repete. O número decide se um cache exato vale a pena. Leva dez minutos com as perguntas que você já registra em log. Normalize cada pergunta do jeito que a chave do seu cache vai fazer, conte as distintas e veja quanto do tráfego foi repetição.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share é a fração das requisições que um cache exato teria respondido, depois de ter visto cada pergunta uma primeira vez. O nosso conjunto de teste tinha 1.264 perguntas distintas em 3.000 requisições, então o valor foi de cerca de 58%. Se o seu der perto de 5%, um cache exato fará pouco, e só uma camada semântica pode ajudar.
Há duas ressalvas. Um cache começa vazio, então as primeiras requisições sempre chegam ao modelo. Na nossa execução, cerca de 52% das primeiras mil requisições foram servidas pelo cache e cerca de 81% das últimas mil. E um log do tráfego do mês passado informa sobre o mês passado. Se você está prestes a lançar um recurso que muda o que as pessoas perguntam, trate o número como uma referência aproximada.
Como combinar as camadas
Uma requisição deve passar pelas camadas da mais barata e segura para a mais cara, e você deve poder ver quanto cada uma economizou.
A ordem das consultas
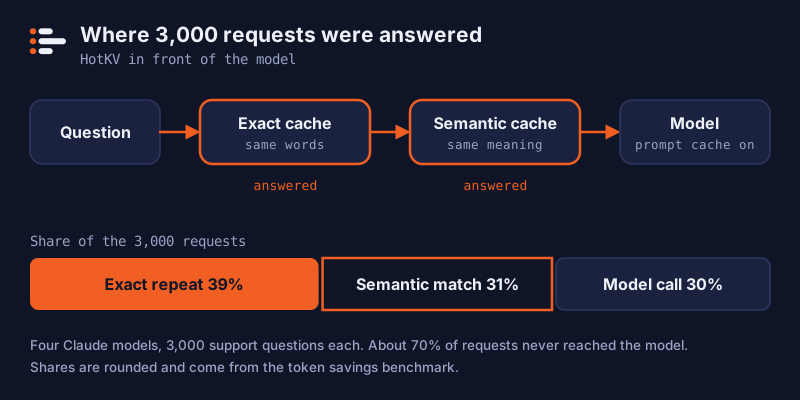
A ordem importa. Consulte primeiro a camada mais barata e segura e chame o modelo só quando todas falharem. Este esboço supõe um cliente no estilo redis-py com decode_responses=True, dois namespaces criados de antemão e as suas próprias funções embed e llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # mesmas palavras

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # mesmo significado

    reply = llm.complete(question)                   # o cache de prompts do provedor se aplica aqui
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Crie os namespaces uma única vez com PCACHE.CREATE answers_exact e SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, usando a dimensão do seu modelo de embedding. O conjunto de comandos de IA vem com as instâncias HotKV Cloud Performance e Scale, e a página de IA lista o que cada motor faz. A página de preços mostra o que cada plano inclui.
Acompanhando os resultados em produção
Um cache que você não vê é um cache em que você não pode confiar. O HotKV mantém contagens de acertos e falhas por namespace. Se você guardar o uso de tokens da chamada original junto com cada entrada, ele também pode atribuir os tokens e o custo que cada acerto posterior evitou. As respostas de PCACHE.STATS e SCACHE.STATS passam então a trazer campos como usage_saved_requests, usage_saved_input_tokens e usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Substitua <model> pelo id do seu modelo. INPUT conta os tokens do prompt sem cache e CACHEREAD os tokens que o provedor serviu do próprio cache, então os dois não se sobrepõem. O modelo precisa estar na tabela de preços do HotKV para que o campo de custo signifique alguma coisa. LLMSTATS.PRICE LIST mostra quais modelos são conhecidos, e LLMSTATS.PRICE SET adiciona os seus. Um modelo sem preço ainda tem os tokens contados, mas o custo dele é registrado como zero, e um contador separado mostra que houve requisições sem preço.
Os caches reduzem o gasto, e um orçamento limita o que sobra. LLMBUDGET.SET define um limite de tokens e de dólares em uma janela de tempo. LLMBUDGET.CONSUME é verificado antes da chamada ao modelo, então um agente descontrolado é interrompido antes de gastar o dinheiro, e não depois. LLMSTATS.RECORD mantém totais por tenant que entendem os tokens de leitura e de gravação de cache do provedor. Os três usam uma única tabela de preços quando você informa o nome do modelo, então uma economia, um orçamento e um número do painel não podem discordar.
Erros que fazem um cache devolver respostas erradas
A maioria dos acertos ruins de cache vem de uma chave a que falta alguma coisa. Coloque na chave exata o modelo, a versão do prompt e qualquer versão de ferramenta ou de política, para que uma mudança no prompt não sirva respostas escritas para o antigo.
Dê às entradas um tempo de vida que acompanhe a rapidez com que os seus fatos mudam. Separe os tenants com namespaces distintos, para que a resposta de um cliente nunca seja oferecida a outro. Nunca coloque em cache uma resposta que contenha dados pessoais, a menos que a chave inclua de quem são os dados.
Por fim, meça no seu próprio tráfego. Os nossos números vêm de um conjunto de dados público de perguntas bancárias curtas, de uma política fictícia e de uma execução por condição, e não são uma promessa para a sua carga de trabalho.
Perguntas frequentes
O que é cache de prompts?
O cache de prompts é um recurso do provedor do modelo que guarda por um curto período o início já processado de um prompt. Uma requisição posterior que comece exatamente com o mesmo texto é cobrada a uma taxa menor por essa parte. O modelo ainda roda e produz uma resposta nova, então você continua pagando pelos tokens de saída.
Cache de prompts é a mesma coisa que cache semântico?
Não. O cache de prompts reaproveita um prefixo de prompt repetido e ainda chama o modelo. O cache semântico devolve uma resposta guardada para uma pergunta de significado semelhante e pula a chamada ao modelo. Eles atacam custos diferentes e podem ser usados juntos.
O cache de prompts reduz o custo dos tokens de saída?
Não. Ele só reduz o preço da leitura do prefixo em cache. No nosso benchmark, a saída era de 6% a 9% dos tokens, mas de 73% a 92% do custo da baseline com o cache de prompts já ativado, e é por isso que colocar respostas inteiras em cache economizou muito mais.
Quanto tempo dura o cache de prompts da Anthropic?
O padrão é de cinco minutos, renovados a cada uso da entrada. Há uma opção de uma hora, com um preço de gravação maior. Consulte a documentação atual, porque limites e preços mudam.
Posso usar cache de prompts e cache semântico juntos?
Sim, e foi exatamente o que o nosso benchmark fez. O cache de prompts do provedor ficou ativado nas duas execuções, e as camadas semântica e exata ficaram na frente do modelo. Os acertos de cache pulam a chamada, e as falhas ainda se beneficiam do prefixo com desconto.
Que limiar de similaridade um cache semântico deve usar?
Não existe um valor universal. Escolhemos 0,81 em uma divisão de treino separada e, no Sonnet 5.5, as respostas em cache não mostraram déficit de qualidade em relação às novas de 0,88 para cima, com evidência frágil. Comece alto, avalie as respostas em cache contra respostas novas nas suas próprias perguntas e baixe o limiar só se a qualidade se mantiver.

Continue a conversa
Comentários
Dúvidas sobre o método? Um resultado diferente no seu hardware? Compartilhe o que você encontrou. Os comentários são revisados antes de aparecer.