
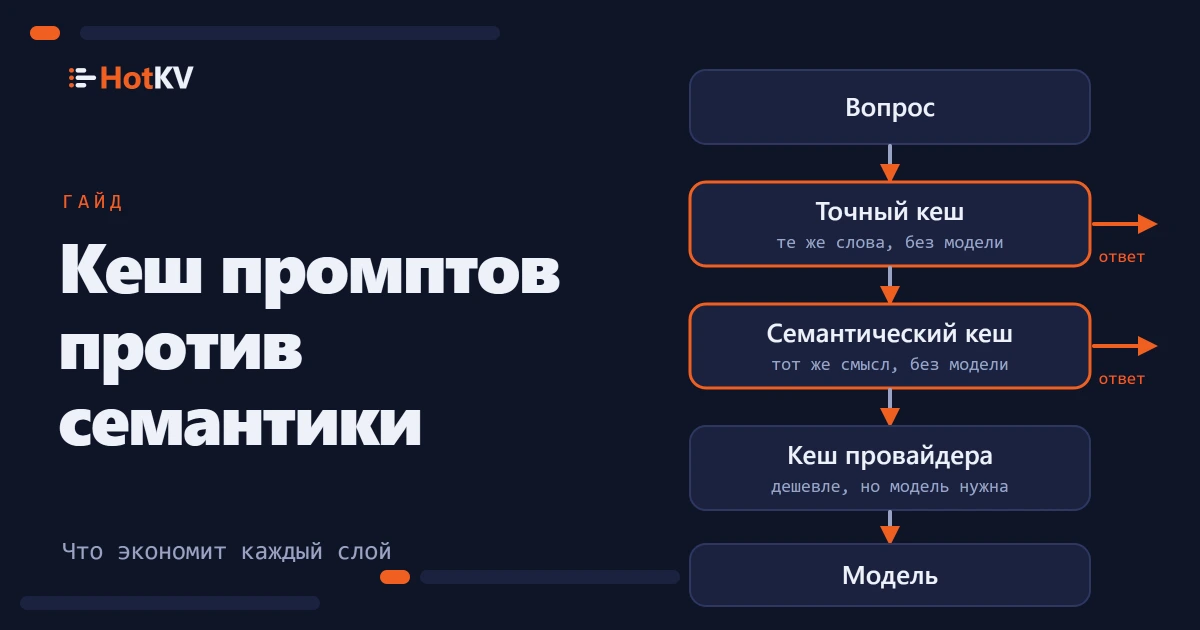
Два разных механизма продаются как кеширование для языковых моделей, и команды регулярно покупают один, ожидая другой. Кеширование промптов - это функция провайдера, которая делает чтение повторяющегося префикса промпта дешевле. Семантическое кеширование - это слой, который вы запускаете сами и который отвечает на вопрос из памяти, так что модель вообще не вызывается. Они решают разные половины счёта и лучше всего работают вместе.
Коротко. Кеширование промптов даёт скидку на повторяющееся начало промпта, например длинный системный промпт, но модель всё равно работает, и вы всё равно платите за каждый выходной токен. Точное и семантическое кеширование полностью убирают вызов, когда на вопрос уже отвечали. В нашем бенчмарке из 3 000 запросов при уже включённом кешировании промптов у провайдера добавление HotKV перед моделью сократило вызовы модели, токены и стоимость примерно на 70%, потому что выходные токены всё равно составляли от 73% до 92% базовой стоимости.
Как работает кеширование промптов
Кеширование промптов находится у провайдера модели. Вы помечаете стабильное начало запроса, обычно инструменты и системный промпт, и провайдер ненадолго сохраняет их обработанный вид. Следующий запрос, начинающийся с идентичного текста, оплачивается по сниженной ставке за эту часть. Здесь мы описываем версию Anthropic, потому что именно её мы измеряли. Подробности ниже взяты из её документации по кешированию промптов, проверенной 18 октября 2026 года.
Что кешируется
Для попадания нужно точное совпадение. Каждый блок вплоть до помеченного cache_control включительно должен быть идентичен, в порядке: инструменты, системный промпт, затем сообщения. Измените один символ в начале промпта, и всё после него будет промахом. Сам вопрос идёт последним, поэтому он никогда не входит в кешируемый префикс.
Промпты короче минимальной длины не кешируются, и ошибка не возвращается. Для актуальных моделей Claude, которые мы использовали, Fable 5.1, Opus 5.5, Sonnet 5.5 и Haiku 5.5, задокументированный минимум составляет 512 токенов. Записи кеша изолированы по организации, а в API Claude - по рабочему пространству.
Сколько это стоит
Срок жизни по умолчанию - пять минут, и каждое использование записи продлевает его без дополнительной платы. Доступен срок в один час. Запись стоит 1,25 базовой цены входа для пяти минут и 2 для одного часа. Чтение стоит 0,1 базовой цены входа на большинстве моделей, 0,05 на Opus 5.5 и Sonnet 5.5 и 0,025 на Fable 5.1 согласно странице цен. Эти множители меняются, поэтому перед любыми расчётами прочитайте актуальную страницу.
Что кеширование промптов убрать не может
Кеширование промптов даёт скидку на чтение префикса. Оно не пропускает модель. Каждый запрос по-прежнему создаёт новый ответ, вы по-прежнему его ждёте, и каждый выходной токен оплачивается по полной цене выхода.
Наш бенчмарк показывает, насколько это важно. Мы отправили 3 000 вопросов службы поддержки каждой из четырёх моделей Claude с политикой на 2 200 токенов в качестве системного промпта и включённым кешированием у провайдера. От 90% до 93% учтённых токенов были чтениями этой политики из кеша. Выход составлял всего от 6% до 9% токенов, но при этом от 73% до 92% базовой стоимости. Префикс уже был дешёвым, поэтому оставшиеся расходы сидели в ответах.
Именно этот разрыв заполняют остальные слои. Полная методика и результаты приведены в бенчмарке экономии токенов.
Точное и семантическое кеширование ответов
Два слоя отвечают на запрос из памяти. Они различаются тем, как решают, что новый запрос совпадает со старым.
Точное кеширование ответов
Точный кеш хранит итоговый ответ под ключом, построенным из всего, что на него влияет. Обычно это модель, версия промпта и нормализованный вопрос. Когда тот же запрос приходит снова, возвращается сохранённый ответ, а модель не вызывается. Нет оценки сходства и нет риска вернуть ответ, предназначенный для другого вопроса.
В нашем запуске точный кеш ответил примерно на 39% запросов. Повторяющийся вопрос возвращался за медиану около 0,05 мс. Это измерено клиентом на Python через loopback на той же машине, поэтому воспринимайте это как локальное, а не сетевое значение. В бенчмарке для этого слоя использовались обычные GET и SET. В HotKV Enterprise есть также специальный кеш промптов с точным совпадением, PCACHE.*, с лимитами на пространство имён и учётом затрат.
Точное кеширование слепо к формулировке. «How do I reset my password?» и «I forgot my password» - два разных ключа.
Семантическое кеширование
Семантический кеш ищет по смыслу вопроса. Он превращает вопрос в эмбеддинг, находит ближайший сохранённый вопрос и возвращает его ответ, если косинусное сходство проходит порог. В HotKV это SCACHE.*, построенный на том же векторном индексе, что и векторный поиск.
Около 31% наших запросов были обслужены таким образом. Перефразированный вопрос занимал в медиане около 130 мс, почти целиком на вызов сервиса эмбеддингов, поэтому семантическое попадание намного быстрее вызова модели, но не мгновенно. Без семантического слоя одному точному кешу понадобилось бы не более 1 264 вызовов модели из 3 000, то есть примерно на 58% меньше. Семантический слой довёл экономию примерно до 70%.
Здесь же живёт и риск. Похожий вопрос не всегда тот же самый вопрос. Мы поручили второй модели Claude оценить каждое семантическое попадание в сравнении со свежим ответом. При нашем пороге по умолчанию 0,81 ответы из кеша подходили к точному вопросу реже свежих на 5,8-10,7 процентных пунктов. На Sonnet 5.5 пороги 0,88 и выше такого отставания не показали, хотя доказательства скудны. Вопросы, написанные так, чтобы отличаться одной решающей деталью, всё равно совпадали в 62% случаев при 0,81 и в 10% при 0,95.
Кеширование промптов и семантическое кеширование рядом
| Кеширование промптов у провайдера | Точный кеш ответов | Семантический кеш | |
|---|---|---|---|
| Что убирает | Часть цены входа | Весь вызов модели | Весь вызов модели |
| Правило совпадения | Идентичный префикс | Идентичный запрос | Сходный смысл выше порога |
| Оплата выходных токенов | Да, каждый раз | Нет, при попадании | Нет, при попадании |
| Риск неверного ответа | Нет | Нет для идентичных запросов | Реальный, настраивается порогом |
| Где работает | У провайдера | В вашем кеше | В вашем кеше, плюс вызов эмбеддинга |
| Доля запросов в нашем запуске | Всегда включено | Около 39% | Около 31% |
Кеширование промптов у провайдера и кеширование ответов - не альтернативы. Одно снижает цену вызовов, которые вы всё же делаете, а другое сокращает их число.
Что кеширование делает с задержкой
Пропуск модели меняет не только стоимость, но и скорость получения ответов. В нашем запуске медианное время до полного ответа упало с 2,7 секунды до 127 мс на Fable 5.1, с 2,9 секунды до 126 мс на Opus 5.5, с 1,8 секунды до 128 мс на Sonnet 5.5 и с 1,4 секунды до 125 мс на Haiku 5.5. Это в 11-23 раза быстрее по медиане.
Медленный конец почти не сдвинулся. Около 30% запросов всё равно доходили до модели, а 99-й перцентиль на Fable 5.1 составлял около 6,4 секунды с HotKV против 6,6 секунды без него. Кеш убирает ожидание для запросов, на которые отвечает, и ничего не делает для тех, которые пропускает. Если ваша проблема - медленный худший случай, а не медленный типичный, одного кеширования будет недостаточно.
Это время до полного ответа, потому что вызовы не передавались потоком. Потоковый ответ показывает первые слова раньше. Разрыв в окне чата меньше, чем в этих цифрах.
Выбор слоя для вашего трафика
Нужный слой зависит от того, как повторяются ваши запросы, и вы можете измерить это ещё до того, как что-то строить.
Подберите слой под трафик
Подберите слой под то, как повторяются ваши запросы.
- Длинный стабильный системный промпт или список инструментов: используйте кеширование промптов у провайдера. Включить его почти ничего не стоит, и оно не меняет ответы.
- Один и тот же вопрос теми же словами, например кнопка, шаблон или повторная попытка: используйте точный кеш ответов. Он безопасен и быстр.
- Трафик поддержки, поиска и FAQ, где люди спрашивают одно и то же разными словами: добавьте семантический кеш, задайте высокий порог и проверьте качество ответов на собственных вопросах, прежде чем ему доверять.
- Ответы, зависящие от пользователя, времени или живых данных: не кешируйте их вовсе или стройте ключ кеша на фактах, меняющих ответ.
Экономия следует за повторяемостью. Когда мы сделали все намерения равновероятными вместо смещённых, стоимость упала на 56% на двух моделях, которые мы запустили заново, а на 3 000 совершенно разных вопросах - на 38%. Нагрузка без повторяющихся или похожих вопросов ничего не экономит.
Сначала измерьте собственную повторяемость
Прежде чем что-то строить, выясните, какая часть вашего трафика повторяется. Это число решает, стоит ли иметь точный кеш. Это занимает десять минут на вопросах, которые вы уже логируете. Нормализуйте каждый вопрос так, как это сделает ключ вашего кеша, посчитайте различные и посмотрите, какая доля трафика была повтором.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share - это доля запросов, на которые ответил бы точный кеш после того, как увидел каждый вопрос в первый раз. В нашем тестовом наборе было 1 264 различных вопроса среди 3 000 запросов, так что значение составило около 58%. Если у вас получится около 5%, точный кеш почти ничего не даст, и поможет только семантический слой.
Нужны две оговорки. Кеш начинается пустым, поэтому ранние запросы всегда доходят до модели. В нашем запуске около 52% первой тысячи запросов были обслужены из кеша и около 81% последней тысячи. И лог трафика прошлого месяца говорит о прошлом месяце. Если вы готовитесь запустить функцию, меняющую то, о чём люди спрашивают, считайте значение грубым ориентиром.
Собираем слои вместе
Запрос должен проходить через слои от самого дешёвого и безопасного к самому дорогому, и вы должны видеть, сколько сэкономил каждый.
Порядок поиска
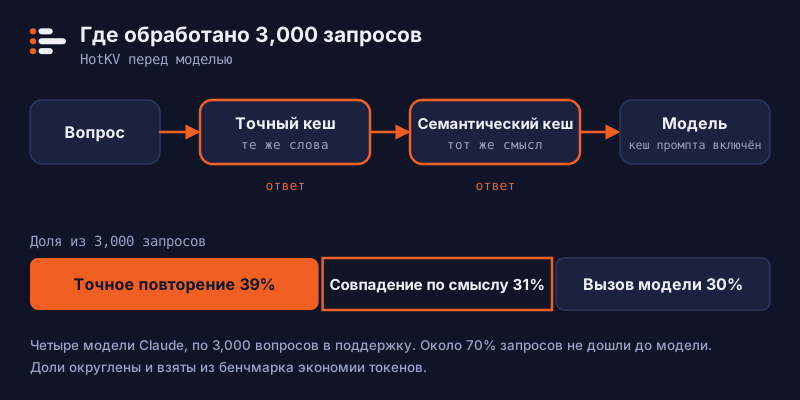
Порядок важен. Сначала проверяйте самый дешёвый и безопасный слой и вызывайте модель только тогда, когда везде промах. Этот набросок предполагает клиент в стиле redis-py с decode_responses=True, два заранее созданных пространства имён и ваши собственные функции embed и llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # те же слова

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # тот же смысл

    reply = llm.complete(question)                   # здесь действует кеширование промптов у провайдера
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Создайте пространства имён один раз командами PCACHE.CREATE answers_exact и SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, указав размерность вашей модели эмбеддингов. Набор команд для ИИ входит в экземпляры HotKV Cloud Performance и Scale, а страница об ИИ перечисляет, что делает каждый движок. Страница цен показывает, какой тариф что включает.
Ведём учёт в продакшене
Кеш, которого вы не видите, - это кеш, которому нельзя доверять. HotKV ведёт число попаданий и промахов по каждому пространству имён. Если вы сохраняете использование токенов исходного вызова вместе с каждой записью, он также может учесть токены и стоимость, которых избежало каждое последующее попадание. Тогда ответы PCACHE.STATS и SCACHE.STATS содержат такие поля, как usage_saved_requests, usage_saved_input_tokens и usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Замените <model> идентификатором вашей модели. INPUT считает некешированные токены промпта, а CACHEREAD - токены, которые провайдер отдал из собственного кеша, так что они не пересекаются. Чтобы поле стоимости имело смысл, модель должна быть в таблице цен HotKV. LLMSTATS.PRICE LIST показывает, какие модели известны, а LLMSTATS.PRICE SET добавляет ваши. У модели без цены токены всё равно учитываются, но её стоимость записывается как нулевая, а отдельный счётчик показывает, что запросы остались без цены.
Кеши сокращают расходы, а бюджет ограничивает остаток. LLMBUDGET.SET задаёт лимит токенов и долларов на временное окно. LLMBUDGET.CONSUME проверяется перед вызовом модели, так что неуправляемый агент останавливается до того, как потратит деньги, а не после. LLMSTATS.RECORD ведёт итоги по арендаторам, учитывающие токены чтения и записи кеша у провайдера. Все три используют одну таблицу цен, когда вы передаёте имя модели, поэтому экономия, бюджет и показатель на дашборде не могут расходиться.
Ошибки, из-за которых кеш возвращает неверные ответы
Большинство плохих попаданий в кеш возникает из-за ключа, в котором чего-то не хватает. Включайте в точный ключ модель, версию промпта и версию любого инструмента или политики, чтобы изменение промпта не приводило к выдаче ответов, написанных для старого.
Задавайте записям срок жизни, соответствующий скорости изменения ваших фактов. Разделяйте арендаторов отдельными пространствами имён, чтобы ответ одного клиента никогда не предлагался другому. Никогда не кешируйте ответ, содержащий персональные данные, если ключ не включает, чьи это данные.
Наконец, измеряйте на собственном трафике. Наши цифры получены на одном публичном наборе данных коротких банковских вопросов, вымышленной политике и одном запуске на условие, и они не являются обещанием для вашей нагрузки.
Часто задаваемые вопросы
Что такое кеширование промптов?
Кеширование промптов - это функция провайдера модели, которая ненадолго сохраняет обработанное начало промпта. Последующий запрос, начинающийся ровно с того же текста, оплачивается по сниженной ставке за эту часть. Модель всё равно работает и создаёт новый ответ, поэтому за выходные токены вы всё равно платите.
Кеширование промптов - это то же самое, что семантическое кеширование?
Нет. Кеширование промптов повторно использует повторяющийся префикс промпта и всё равно вызывает модель. Семантическое кеширование возвращает сохранённый ответ на вопрос со сходным смыслом и пропускает вызов модели. Они направлены на разные затраты и могут использоваться вместе.
Снижает ли кеширование промптов затраты на выходные токены?
Нет. Оно только снижает цену чтения кешируемого префикса. В нашем бенчмарке при уже включённом кешировании промптов выход составлял от 6% до 9% токенов, но от 73% до 92% базовой стоимости, поэтому кеширование целых ответов сэкономило намного больше.
Как долго живёт кеш промптов Anthropic?
По умолчанию пять минут, с продлением при каждом использовании записи. Доступен вариант на один час с более высокой ценой записи. Проверяйте актуальную документацию, потому что лимиты и цены меняются.
Можно ли использовать кеширование промптов и семантическое кеширование вместе?
Да, и наш бенчмарк делал именно это. Кеширование промптов у провайдера оставалось включённым в обоих запусках, а семантический и точный слои стояли перед моделью. Попадания в кеш пропускают вызов, а промахи по-прежнему выигрывают от удешевлённого префикса.
Какой порог сходства должен использовать семантический кеш?
Универсального значения нет. Мы выбрали 0,81 на отдельной обучающей выборке, а на Sonnet 5.5 ответы из кеша не показали отставания по качеству от свежих начиная с 0,88, хотя доказательства скудны. Начните с высокого порога, оценивайте ответы из кеша в сравнении со свежими на собственных вопросах и снижайте порог, только если качество сохраняется.
Продолжите разговор
Комментарии
Есть вопросы о методике? Получили другой результат на своём оборудовании? Поделитесь находками. Комментарии проверяются перед публикацией.