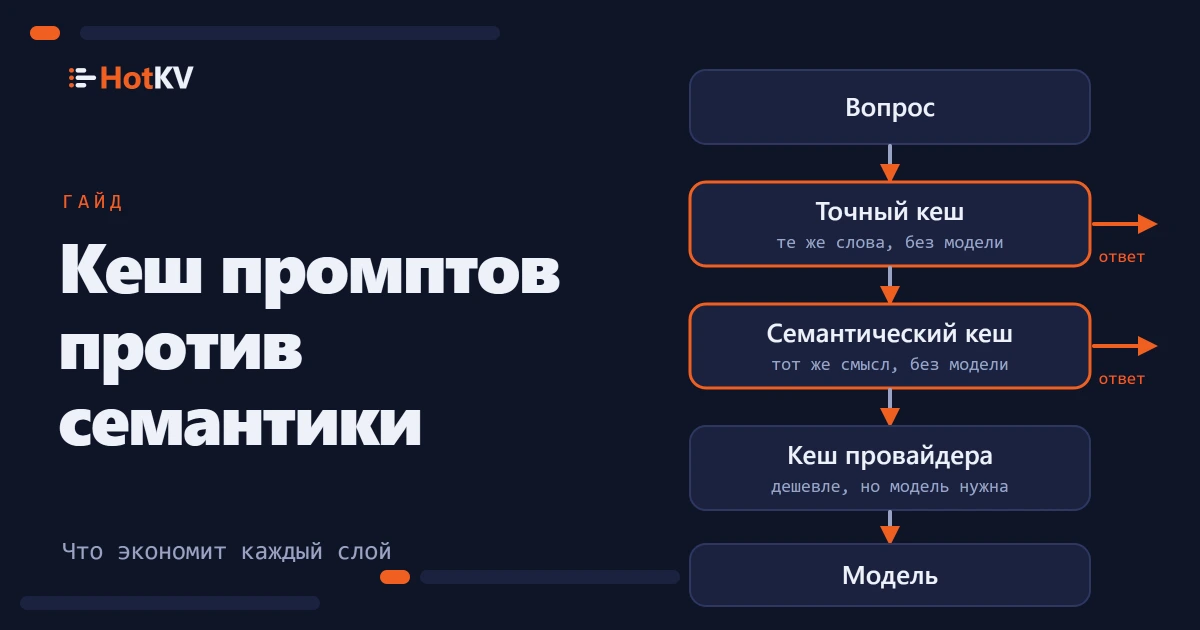
Кеширование промптов и семантическое кеширование: что экономит каждое
Кеширование промптов удешевляет повторяющийся префикс, семантическое кеширование убирает вызов модели. Как работает каждое, что мы измерили и когда что выбрать.
Тег
Кеширование промптов у провайдера и кеширование ответов для приложений на LLM: сколько каждое экономит токенов и денег и где оно перестаёт помогать.
2 статьи в разделе Кеширование промптов
Кеширование промптов удешевляет повторяющийся префикс, семантическое кеширование убирает вызов модели. Как работает каждое, что мы измерили и когда что выбрать.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Следуйте за любопытством