
HotKV är ett flertrådat, Redis-kompatibelt datalager skrivet från grunden i modern C++, byggt för att få ut så mycket fart som möjligt ur moderna servrar med många kärnor till lägsta möjliga kostnad. Jag heter Norbert E. Boros och är grundare och VD för HotKV Ltd. Det här inlägget förklarar varför jag byggde det, vad det kan i dag och hur det mättes.
Kort sagt. HotKV kör kommandon på många trådar samtidigt i en enda process och talar RESP2 och RESP3, Redis-protokollet. I vår benchmark av en enskild instans på 160 vCPU:er i oktober 2026 hade det högst genomströmning på 11 av de 12 kommandon vi mätte, och Dragonfly låg jämsides på det tolfte. Uppställningen och dess begränsningar beskrivs nedan.
Varför jag byggde HotKV
Jag bryr mig om hastighet i allt jag bygger. En webbplats, ett verktyg eller en server ska svara direkt, och när den inte gör det vill jag veta varför. Den vanan har format mitt arbete så länge jag har skrivit mjukvara.
C och C++ har varit mina huvudspråk i många år. I nästan tio år arbetade jag med anti-cheat-programvara för spel som kördes på tusentals spelares datorer. Den skulle skanna minnet efter fusk och samtidigt använda så lite CPU och minne som möjligt, för varje cykel den förbrukade togs från spelet. Det arbetet lärde mig att mäta allt, att utforma efter hårdvaran och att se låg resursanvändning som en egen funktion.
Vid sidan av det använde jag Redis och Valkey i många projekt som behövde en snabb cache: sessionslager, listor över IP-adresser som en brandvägg blockerade och en cache framför hundratals miljoner poster i SQL Server. De är utmärkta verktyg. Men de gjorde mig också nyfiken på vad ett nyckel-värde-lager skulle kunna åstadkomma om det var konstruerat från början för de servrar med många kärnor som vi kör i dag.
HotKV är det svar jag kom fram till. Jag skrev det från grunden i modern C++ för att få ut så mycket fart som möjligt ur hårdvaran, till lägsta möjliga kostnad. Benchmarken nedan visar var det står i dag, och jag räknar med att det finns mer att hämta.
Vad AI kostar
Det fanns ett andra skäl. Att driva AI-applikationer blev dyrt, för mig och, att döma av vad utvecklare delade online, för många andra också. En stor del av den kostnaden kommer ofta av att man skickar en modell frågor som den redan har besvarat. Ett snabbt lager som känner igen en upprepad eller liknande fråga och besvarar den från cachen är ett av de mest direkta sätten att sänka den räkningen, och därför är cache för AI-arbetslaster en central del av HotKV.
Vad HotKV är till för
HotKV Ltd finns för att göra den här sortens mjukvara snabbare och mer prisvärd. Moderna servrar har många kärnor, och ett datalager bör använda dem, så att du får så mycket fart som möjligt till lägsta möjliga kostnad.
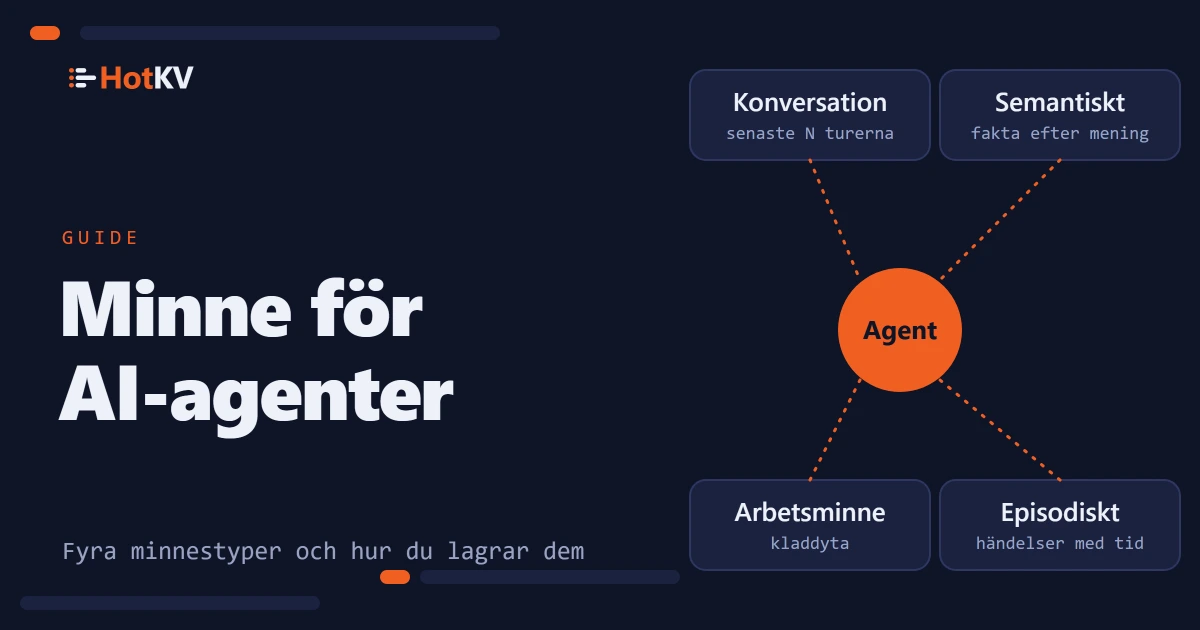
Den andra idén är att hålla mer av stacken på ett ställe. Team som bygger på LLM:er slutar ofta med att drifta en cache, en vektordatabas och någonstans att lagra agentminne, med en hög limkod emellan. Jag vill att cache och det AI-arbete som byggs kring den ska finnas i en enda motor, bredvid din data: exakt och semantisk cache av modellanrop, vektorsökning, agentminne och tokenbudgetar. Färre system att köra bör ge färre rörliga delar och en lägre räkning. AI-sidan listar vad som finns i dag, och benchmarken för tokenbesparingar visar vad cache av modellanrop sparade i vårt test.
HotKV behåller Redis-protokollet och välbekanta klientbibliotek.
Problemet
En enda tråd för kommandoexekvering kan bli en flaskhals på en maskin med många kärnor. Ett datalager som är byggt kring en enda exekveringstråd når oftast resten av maskinen genom att köra flera instanser eller ett kluster, och det för med sig val vid driftsättning och driftarbete. Jag ville att HotKV skulle utgå från andra änden, med kommandon som körs samtidigt inom en instans, så att en enda process kan använda hela maskinen.
Vad HotKV gör annorlunda
HotKV™ är skrivet i C++20 och konstruerat för att köra kommandon på många kärnor samtidigt, så att en enda instans kan utnyttja en hel maskin. Dragonfly, som vi benchmarkar nedan, väljer också ett flertrådat angreppssätt.
- Många kärnor, en instans. Kommandon körs samtidigt över maskinens kärnor, så att en instans kan använda en stor server i stället för flera mindre.
- Välbekanta klienter och protokoll. HotKV stöder RESP2 och RESP3, så att välbekanta klientbibliotek kan ansluta till det. Transaktioner (
MULTI/EXEC) och Lua-skript stöds. Se kommandodokumentationen för de kommandon som stöds och eventuella skillnader.
Hur det byggs och testas
Jag bygger HotKV själv och använder AI-hjälp där den hjälper. Det viktigaste är inte hur en rad kom till utan om den håller, så motorn testas hårt. Den har över 2 000 automatiserade tester och byggs med AddressSanitizer, ThreadSanitizer och UndefinedBehaviorSanitizer. Den har också fuzz-mål för protokolltolken, kommandodispatchen, inläsning av RDB och AOF, replikeringsströmmen och klusterbussen.
Benchmarkens uppställning, dess begränsningar och de fullständiga resultaten finns på sidan Prestanda, så att du kan bedöma siffrorna själv.
Ögonblicksbild av benchmarken
Uppdaterad i oktober 2026: De siffror som först publicerades i det här inlägget kom från benchmarkkörningar som vi senare upptäckte var felaktiga (bland annat använde alla lastgeneratorer samma slumpfrö), så vi ersatte dem med resultat från vår ombyggda benchmark.
Oktober 2026: HotKV, Redis, Valkey och Dragonfly
HotKV Ltd genomförde den här benchmarken. Vi mätte HotKV, byggt från källkod, mot Redis 8.10.2, Valkey 9.1.2 och Dragonfly 2.0.2. Varje server kördes ensam, som en enskild instans på alla 160 vCPU:er i en Azure D160alds_v7 (AMD EPYC 9V45), med persistens avstängd. Tre separata maskiner med 64 vCPU:er vardera genererade lasten med memtier_benchmark: värden på 256 byte, ett pipelinedjup på 30 och 5 000 000 förifyllda nycklar. Varje siffra är medianen av tre körningar på 10 sekunder.
HotKV hade högst genomströmning på 11 av de 12 kommandona. Mot Redis eller Valkey uppmättes mellan 8,6 och minst 69,7 gånger deras genomströmning, beroende på kommando och server; mot Dragonfly mellan 1,97 och 4,41 gånger på de 11 kommandona, flera av dem som nedre gränser. På PING mätte Dragonfly 0,6 procent före. Vi räknar det som oavgjort, eftersom lastgeneratorerna låg nära sin egen gräns. Den högsta siffran på ett datakommando var 90,8 miljoner INCR-operationer per sekund. INCR och PING flyttar lite data och begränsas av lastgeneratorerna, så HotKV:s egen siffra för dem kan vara högre.
| Kommando | HotKV (miljoner ops/s) | HotKV mot Redis | HotKV mot Valkey | HotKV mot Dragonfly |
|---|---|---|---|---|
| SET | 50,5 | ≥ 14,80x | ≥ 17,51x | ≥ 3,36x |
| GET | 36,6 | ≥ 32,34x | ≥ 22,46x | ≥ 2,73x |
| MGET | 4,6 | 16,61x | 8,60x | 1,97x |
| SETNX | 55,3 | ≥ 39,58x | ≥ 29,73x | ≥ 3,83x |
| APPEND | 25,1 | 16,37x | 19,41x | 2,83x |
| INCR | 90,8 | 43,15x | 47,33x | 4,41x |
| LPUSH | 31,6 | 25,34x | 37,55x | 2,99x |
| RPUSH | 43,8 | ≥ 69,67x | ≥ 49,83x | ≥ 3,97x |
| SADD | 50,6 | ≥ 24,65x | ≥ 56,60x | ≥ 4,20x |
| HSET | 29,0 | ≥ 54,05x | ≥ 37,09x | ≥ 2,96x |
| MSET | 11,3 | ≥ 29,78x | ≥ 24,26x | ≥ 3,83x |
| PING | 125,2 | ≥ 38,70x | ≥ 35,98x | 0,99x (oavgjort) |
Så läser du tabellen
MGET läser åtta nycklar och MSET skriver fyra nyckel-värde-par per kommando, och genomströmningen räknar kommandon. Rapporten markerar sju av HotKV:s siffror (GET och sex skrivkommandon) eftersom de nådde dess tröskel på 85% nätverksanvändning, och PING eftersom lastgeneratorerna låg över 85% CPU. Kvoter som bygger på dem är nedre gränser, markerade med ≥. GET och PING är de verkliga gränserna. För de sex skrivkommandona adderar rapportens siffra för nätverksanvändning inkommande och utgående trafik och jämför med taket för utgående trafik, så den överskattar hur nära de var en gräns. Det tyngsta, SETNX, använde högst omkring 80% av det uppmätta taket för inkommande trafik. Vi behåller ≥ på dem som en försiktig konvention. De fullständiga tabellerna, flaggorna och metodanteckningarna finns på sidan Prestanda.
Benchmarkens omfattning
- Bygge och trimning. HotKV kompilerades med
-march=nativeför testprocessorn, medan de andra servrarna var sina vanliga release-byggen. - Trådinställningar. Varje server fick alla maskinens kärnor: HotKV
--threads 160, Dragonfly 160 proactor-trådar, Valkeyio-threads 160och Redisio-threads 128, dess maximum. Redis och Valkey kör kommandon på en tråd och kan nå högre genomströmning med färre I/O-trådar, så deras siffror kan ligga under deras bästa. Vi körde inte kluster eller flera instanser av dem. - Omfång. Tolv kommandon, en värdestorlek, ett pipelinedjup, ingen TLS och ingen persistens.
LPOPochRPOPmättes inte, eftersom en destruktiv läsning vid de här takterna tömmer varje lista som ryms i minnet inom 10 sekunder. Rapporten registrerar latens och minnesanvändning, men vi jämför dem inte här. Servrarna utförde mycket olika mängd arbete under varje körning på 10 sekunder, så minnessiffrorna är inte jämförbara rakt av. Blandade arbetslaster mättes inte. - Variation. Redis varierade kraftigt mellan sina tre körningar på flera kommandon, upp till 7,2 gånger mellan den snabbaste och långsammaste körningen på
HSET, och medianen döljer det. Jämfört med varje konkurrents snabbaste körning i stället för dess median ledde HotKV ändå på alla 11 kommandon.
Redis, Valkey och Dragonfly är varumärken som tillhör respektive ägare. De nämns bara för att identifiera den programvara vi mätte, och det innebär inget sponsorskap, ingen rekommendation och ingen koppling.
Vad som levereras i dag
Kärnkommandofamiljerna omfattar strängar, listor, mängder, hashar, sorterade mängder, strömmar, geospatiala index, bitmappar, HyperLogLog, pub/sub och Lua-skript. AI-modulerna och enterprise-funktionerna körs i licensierade planer. Priser visar vad varje plan innehåller. Se dokumentationen för aktuell kommandotäckning. Utöver Redis kommandouppsättning finns:
- Nyckeltaggning: märk nycklar med valfria taggar och fråga efter tagg (
TAG.SET,TAG.MEMBERSoch fem kommandon till). - TTL i nanosekunder:
NEXPIRE,NTTLochNEXPIREATställer in och läser utgångstider i nanosekunder, så att tidsgränser kan vara finare än en millisekund. Utgångna nycklar frigörs av ett svep i bakgrunden och när de används. - Valfri komprimering av värden: för värden över en storlekströskel (512 byte som standard), avstängd om du inte slår på den.
- Snapshots utan fork:
BGSAVEskriver på en bakgrundstråd i stället för en forkad process. En snapshot är ingen kopia vid en given tidpunkt. Varje nyckel sparas som den såg ut när snapshoten nådde den. Omskrivning av append-only-filen forkar däremot. - Prometheus-mått: en inbyggd HTTP-slutpunkt, avstängd som standard och aktiverad med
metrics-port, så ingen extern exporter behövs.
HotKV har också inbyggd vektorsökning med HNSW-index (VSIM.CREATEINDEX, VSIM.SET, VSIM.SEARCH). Vi mätte den mot Redis 8 i Vektorsökning: HotKV mot vektoruppsättningar i Redis 8, från 1 till 100 klienter.
Kom igång på HotKV Cloud, eller prata med försäljningen om att köra HotKV på dina egna servrar.
Fortsätt samtalet
Kommentarer
Frågor om metoden? Ett annat resultat på din hårdvara? Dela med dig av vad du hittade. Kommentarer granskas innan de visas.