
Minne för AI-agenter är det som låter en agent ta med sig något från ett steg, eller en session, till nästa. En språkmodell ensam minns ingenting mellan anropen. Det den verkar minnas har din kod lagt tillbaka i prompten. Hur du lagrar och hämtar det materialet avgör vad agenten kan återkalla, hur snabbt och till vilken kostnad per vända.
Kort sagt. Agenter behöver fyra slags minne: ett kort konversationsfönster, långsiktiga fakta som hittas efter betydelse, en kladdyta för uppgiften som pågår och en logg över vad som hänt. Vart och ett har olika form, livslängd och uppslag, så en enda minnestabell passar inget av dem särskilt bra. HotKV lagrar alla fyra i en och samma minnesmotor med kommandona
AMEM.*. Vi har benchmarkat HotKV:s cache och vektorsökning, inte agentminne, så den här artikeln förklarar designen och påstår ingen hastighetsökning.
Varför ett kontextfönster inte är minne
Ett kontextfönster är den text du skickar med varje förfrågan. Det har en storleksgräns, du betalar indatatokens för allt i det vid varje vända, och det försvinner när sessionen tar slut. Det går inte heller att söka i. Om en agent behöver ett enda faktum från för tre veckor sedan är det inget svar att klistra in hela historiken.
Minne är lagret som avgör vad som hamnar i fönstret härnäst. Det behåller de senaste vändorna och hittar de få äldre fakta som spelar roll. Det håller tillståndet i den pågående uppgiften och registrerar vad agenten har gjort. Forskare beskriver agenter på liknande sätt. CoALA-ramverket av Sumers, Yao, Narasimhan och Griffiths skiljer arbetsminne från episodiskt, semantiskt och procedurellt långtidsminne.
De fyra typerna av minne för AI-agenter
HotKV:s fyra lager täcker det mesta av samma område, anpassat efter vad en applikation behöver bygga. Procedurellt minne, kunnandet som finns i agentens kod och prompter, ligger normalt i ditt repo eller i ett promptregister och är inget eget lager.
Konversationsminne
Det här är den kortsiktiga avskriften av en session. Meddelanden har en roll (system, användare, assistent eller verktyg). De ligger i ett begränsat glidande fönster, så att de äldsta vändorna faller bort när gränsen nås. Det besvarar en enda fråga. Vad har sagts nyligen? I HotKV är det AMEM.CONV.CREATE, AMEM.CONV.APPEND och AMEM.CONV.WINDOW.
Semantiskt minne
Semantiskt minne är långsiktig kunskap som lagras som fakta med en embedding-vektor. Agenten återkallar dem efter betydelse, inte efter nyckel. Det backas av ett HNSW-vektorindex, av samma slag som driver vektorsökning. AMEM.SEM.STORE sparar ett faktum och AMEM.SEM.RECALL returnerar de bästa träffarna med en likhetspoäng. Hit hör dokument, användarpreferenser och inlärda rättelser.
Arbetsminne
Arbetsminne är kladdytan för en uppgift som pågår, en platt uppsättning nycklar och värden avgränsad till en session. Det håller det aktuella steget, ärendet som hanteras eller ett delresultat. Det bör försvinna när uppgiften är klar. AMEM.WORK.SET accepterar en livstid just därför.
Episodiskt minne
Episodiskt minne är en logg med tidsstämplade händelser som bara läggs till, som en åtgärd som vidtagits, en observation som gjorts eller ett beslut som fattats. Den låter en agent, eller en person som granskar den, fråga vad som hände och när. AMEM.EPIS.LOG skriver en händelse och AMEM.EPIS.QUERY läser tillbaka dem efter typ och tidsintervall.
Minne för AI-agenter i praktiken
Två saker spelar roll i praktiken. Hur du skriver till minnet, och vad du läser tillbaka vid varje vända.
Lagra minne med kommandon
Här är en supportagent som hanterar en konversation. Den fiktiva policytexten och vektorerna med tre tal är bara till för illustration. En riktig embedding-modell producerar vektorer med 768 eller 1 536 tal, och du skapar namnrymden med den dimensionen.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
Vid varje vända läser agenten det senaste fönstret och återkallar de få fakta som matchar frågan. Den kontrollerar sin arbetsanteckning och bygger prompten av de delarna. Efter att den har agerat loggar den händelsen. Inget i den loopen behöver hela historiken.
Läs minnet vid varje vända
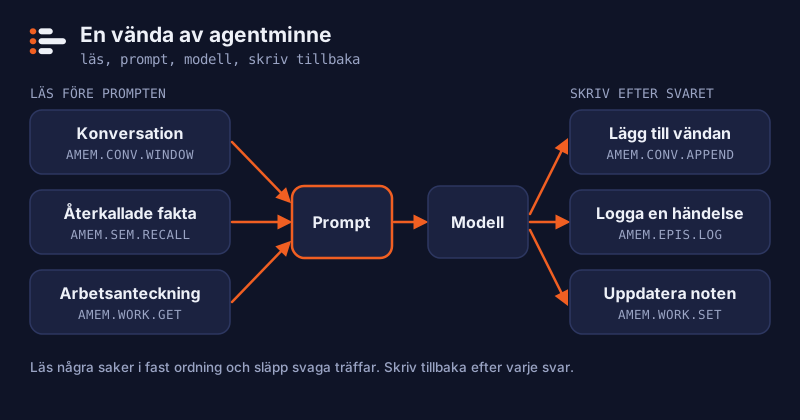
Att lagra minne är den enkla hälften. Konsten är att bestämma vad som ska läsas tillbaka, eftersom allt du läser hamnar i prompten och kostar indatatokens. En rimlig loop läser en handfull saker i fast ordning. De senaste vändorna kommer först, sedan de få fakta som matchar frågan, sedan uppgiftens tillstånd. Här är den med den officiella Python-klienten, med din egen embedding-funktion och promptmall.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # justera på din egen data

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # skapa en gång, före den första appenden

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # din promptmall

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
Gränsen för likhet får du justera själv. Ett värde som passar en embedding-modell och en uppsättning fakta blir fel för en annan, så kontrollera återkallandet på frågor där du känner till svaren. Att släppa svaga träffar betyder mer än det verkar, eftersom ett dåligt faktum i prompten är värre än inget faktum.
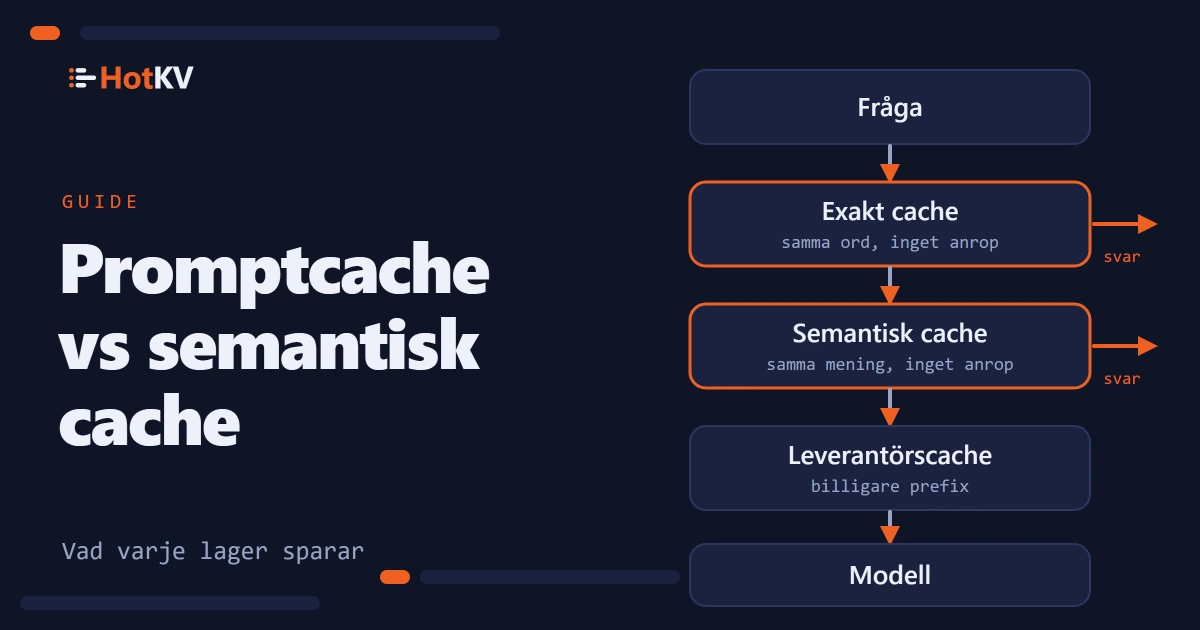
De stabila delarna av prompten, som systeminstruktionerna, är också den del som leverantörens promptcachning gör billigare. Lägg det minne du läser sist, efter den stabila texten, så att en ändring inte gör cachen ogiltig.
Sammanfattningar i stället för allt längre fönster
Ett fönster släpper gamla vändor helt. Det går bra för småprat och är dåligt för en lång uppgift, där vända 3 fortfarande kan spela roll vid vända 300. En rullande sammanfattning är det vanliga svaret. Efter varje stunds konversation skriver agenten, eller en billigare modell, ned vad som har lärts, och sammanfattningen ersätter de gamla vändorna i prompten.
HotKV behåller en sammanfattning per agent med AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND och AMEM.SUMMARY.GET. SET ersätter texten och APPEND lägger till en rad. Varje uppdatering höjer ett versionsnummer, så att en annan komponent billigt kan se att sammanfattningen har ändrats och när.
En sammanfattning är förlustbehäftad, och att sammanfatta en sammanfattning förlorar mer varje gång. Håll exakta värden som identifierare, belopp och datum utanför prosan och i arbetsminnet eller de semantiska fakta, där de överlever. Använd sammanfattningen för arbetets form, som preferenser, fattade beslut och vad som återstår.
Designregler och lagringstid
Minnet växer utan gräns om du inte stoppar det, så sätt gränserna före den första skrivningen.
Regler som håller minnet användbart
- Begränsa allt. Sätt ett
WINDOWpå konversationer och enTTLpå sessioner och arbetsvärden. För konversationer, arbetsvärden och fakta registrerar HotKV utgångstiden för append-only-filen och replikerna, så en post som har löpt ut kommer inte tillbaka när filen spelas upp efter en omstart. - Lagra fakta, inte avskrifter. Sammanfatta innan du skriver till semantiskt minne. Ett faktum är lättare att återkalla än en sida dialog.
- Håll agenter isär. Använd en separat identifierare eller namnrymd per agent och per tenant, så att en kunds minne aldrig återkallas åt en annan.
- Återkalla få, inte många. Ta de tre till fem bästa träffarna och släpp svaga efter likhetspoäng innan de hamnar i prompten.
- Håll hemligheter utanför. Minnet läses tillbaka in i prompter, så lagra aldrig lösenord, nycklar eller data du inte skulle visa modellen.
Hur länge varje typ ska sparas
De här livslängderna är våra förslag, inte standardvärden. Välj dina utifrån hur snabbt de underliggande fakta ändras och vad du får behålla.
| Minnestyp | Föreslagen livslängd | Kontroller i HotKV |
|---|---|---|
| Konversation | Sessionen, eller en fast period som ett dygn | WINDOW och TTL på AMEM.CONV.CREATE |
| Arbetsminne | Uppgiften, därefter rensat | TTL på AMEM.WORK.SET, och AMEM.WORK.CLEAR |
| Semantiskt | Tills faktumet slutar vara sant | TTL på AMEM.SEM.STORE, och AMEM.SEM.FORGET |
| Episodiskt | Så länge din granskning eller support kräver | AMEM.EPIS.QUERY efter tidsintervall, och AMEM.EPIS.CLEAR (händelser har ingen livstid) |
Lagringstid är också en integritetsfråga. Om minnet innehåller något om en person är den livslängd du väljer en del av det du lovar personen, så skriv ned den.
Hur agentminne går fel
De flesta minnesbuggar är långsamma. Agenten fungerar bra i en vecka och börjar sedan bli sämre. Det här är felen att designa mot.
Vanliga fel
- Inaktuella fakta. Ett faktum som stämde i mars återkallas i oktober. Ge fakta en livstid, eller lagra dem under en nyckel per entitet så att det nya värdet skriver över det gamla.
- Motsägelser. Två lagrade fakta säger emot varandra, och agenten väljer ett på måfå. Föredra ett faktum per nyckel framför att lägga nya anteckningar bredvid gamla.
- För mycket återkallat. För många träffar fyller prompten med löst relaterad text. Återkalla få och släpp svaga träffar.
- Läckor mellan användare. En kunds minne återkallas åt en annan. Använd separata identifierare eller namnrymder för varje tenant, kontrollerade i kod före varje läsning.
- Obegränsad tillväxt. Ingenting löper någonsin ut, så uppslagen blir långsammare och kostnaderna kryper uppåt. Varje typ behöver en livslängd. Där HotKV saknar livstid, som för den episodiska loggen, får du själv schemalägga en rensning eller en export.
- Drift i sammanfattningen. En sammanfattning av en sammanfattning slutar sakta att stämma med det som hände. Behåll händelseloggen som sanningskälla och generera om sammanfattningar från den.
Behandla lagrad text som opålitlig
Den sista punkten förtjänar mer uppmärksamhet. Allt en agent skriver till minnet kan senare läsas in i en prompt. Det gäller även text som kom från en webbsida, ett e-postmeddelande eller en användare. Det är den indirekta formen av promptinjektion som OWASP listar som LLM01. Spara källan med varje faktum. Lita mindre på minne som skrivits utifrån externt innehåll, och låt aldrig en återkallad anteckning åsidosätta din systemprompt.
Vad vi har och inte har mätt
HotKV:s publicerade benchmarks täcker kommandogenomströmning, vektorsökning och tokenbesparingarna med svarscache. Agentminne har ännu ingen egen benchmark. Vi gör inget påstående om dess latens eller om hur mycket det förbättrar agentens kvalitet. Det vi kan säga är arkitektoniskt. De fyra lagren körs i samma process som cachen och vektorindexet. Ett minnesuppslag är ett anrop till ett system du redan driftar.
Benchmarken för tokenbesparingar och jämförelsen av promptcachning och semantisk cache visar den uppmätta sidan. Användningsfallet för agentminne visar kommandona i ett fullständigt scenario.
Använda agentminne från Claude Code eller Cursor
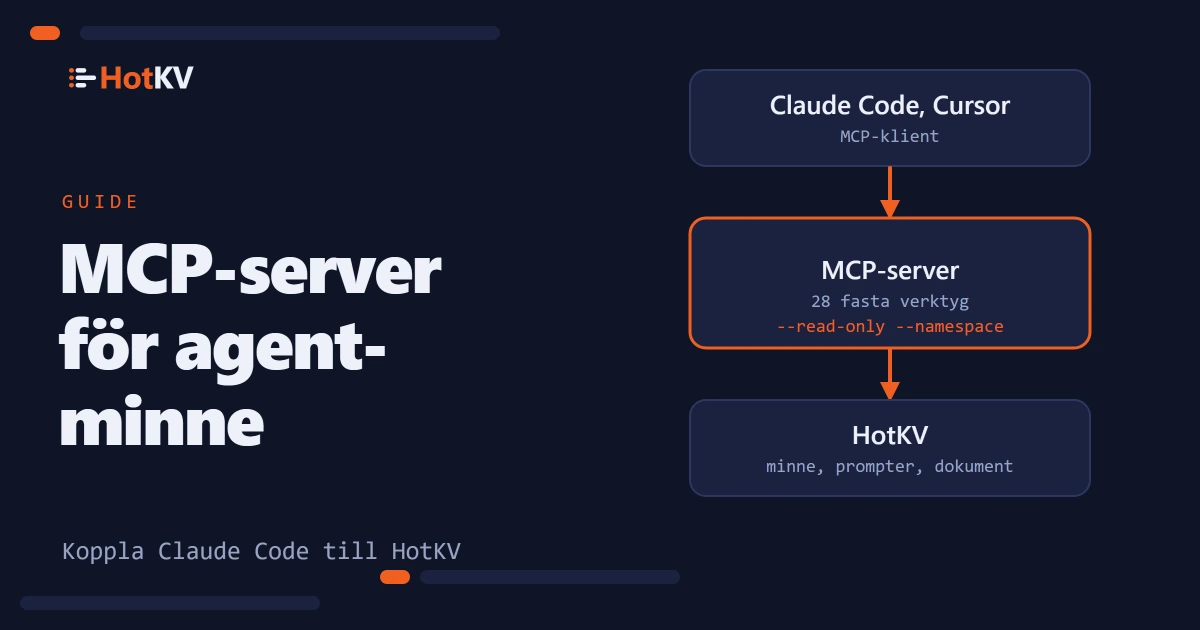
En assistent som stöder Model Context Protocol kan använda en del av det här minnet utan egen kod. MCP-servern hotkv-mcp med öppen källkod exponerar konversationsminne, arbetsanteckningar, en händelselogg och en rullande sammanfattning som verktyg. Den har ett skrivskyddat läge och en namnrymd som håller agenten inom ramarna. Den exponerar inte semantiskt minne, och dess verktyg kan inte ange ett fönster eller en livstid, så använd klientbiblioteket för det. Nästa artikel, en MCP-server för agentminne, visar hur du ansluter den och vad dess skyddsåtgärder täcker.
Vanliga frågor
Vad är minne för AI-agenter?
Minne för AI-agenter är lagrings- och hämtningslagret som låter en agent behålla information över steg och sessioner. Det kombinerar oftast ett fönster med den senaste konversationen, långsiktiga fakta som hittas efter betydelse, en kladdyta för den aktuella uppgiften och en händelselogg.
Vad är skillnaden mellan korttids- och långtidsminne hos en agent?
Korttidsminnet håller det som pågår nu, som de senaste vändorna och uppgiftens tillstånd, och är begränsat och tillfälligt. Långtidsminnet håller kunskap som ska överleva en session, som fakta, preferenser och tidigare händelser, och söks vid behov.
Vad är en rullande sammanfattning i agentminne?
En rullande sammanfattning är en kort löpande beskrivning av vad en agent har lärt sig eller beslutat hittills, som uppdateras medan arbetet fortsätter. Den ersätter gamla vändor i prompten så att prompten inte fortsätter att växa. HotKV lagrar en per agent och höjer ett versionsnummer vid varje uppdatering.
Behöver jag en vektordatabas för agentminne?
Bara för semantiskt minne, där fakta hittas efter betydelse. Konversationsfönster, arbetstillstånd och händelseloggar behöver inga vektorer. HotKV håller alla fyra i en motor, så vektorindexet och de andra lagren är inte separata system.
Hur länge ska agentminne sparas?
Det beror på typen. Arbetsminne bör löpa ut när uppgiften är klar, konversationer efter sessionen eller en fast period, och episodiska loggar så länge din granskning kräver. Fakta i semantiskt minne bör ses över och tas bort när de slutar vara sanna.
Kan agentminne angripas?
Ja. Text som skrivs till minnet läses senare in i prompter, så en förgiftad anteckning kan styra agenten. Registrera varifrån varje faktum kom, lita mindre på externt innehåll och låt återkallat minne stå lägre i auktoritet än din systemprompt.
Lagrar HotKV agentminne i RAM?
HotKV är en minnesmotor, så läsningar serveras från minnet. Skrivningar till de fyra lagren registreras för append-only-filen och för repliker, med utgångstider medföljande, enligt produktdokumentationen.
Fortsätt samtalet
Kommentarer
Frågor om metoden? Ett annat resultat på din hårdvara? Dela med dig av vad du hittade. Kommentarer granskas innan de visas.