
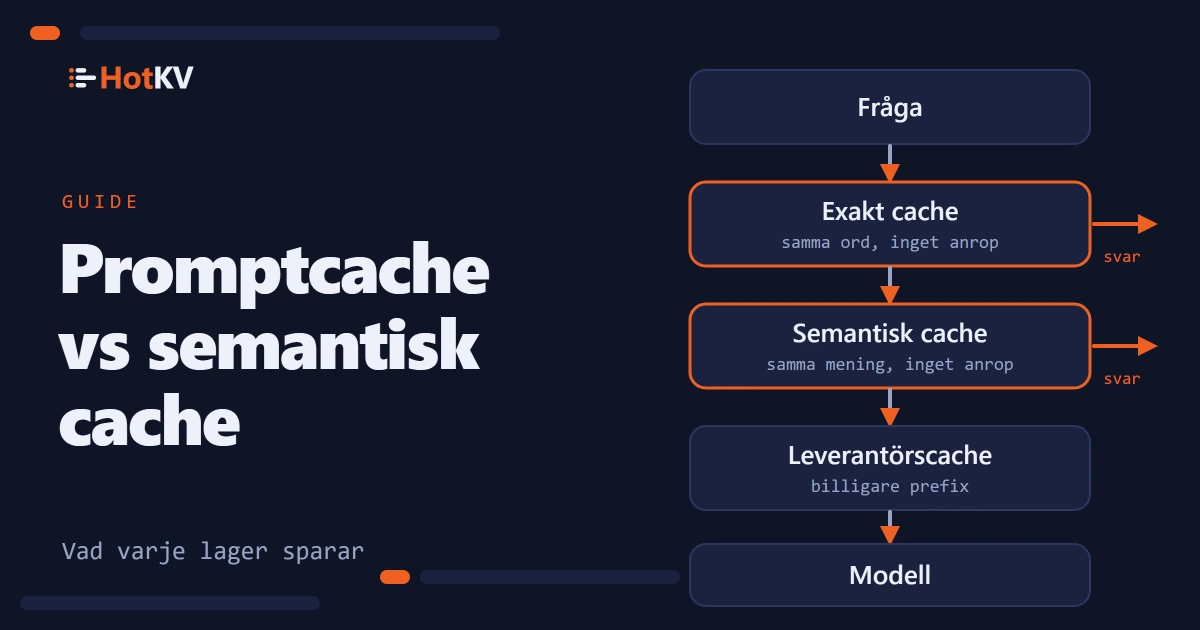
Två olika saker säljs som cache för språkmodeller, och team köper regelbundet den ena i tron att de får den andra. Promptcachning är en funktion hos leverantören som gör ett upprepat promptprefix billigare att läsa. Semantisk cache är ett lager du driver själv som besvarar en fråga ur minnet så att modellen aldrig anropas. De löser olika halvor av räkningen, och de fungerar bäst tillsammans.
Kort sagt. Promptcachning ger rabatt på den upprepade början av en prompt, till exempel en lång systemprompt, men modellen körs ändå och du betalar fortfarande för varje utdatatoken. Cache med exakt och semantisk matchning tar bort anropet helt när en fråga har besvarats förut. I vår benchmark med 3 000 förfrågningar, med leverantörens promptcachning redan påslagen, sänkte HotKV framför modellen antalet modellanrop, tokens och kostnad med cirka 70%, eftersom utdatatokens fortfarande stod för 73% till 92% av baslinjens kostnad.
Så fungerar promptcachning
Promptcachning sker hos modellleverantören. Du markerar den stabila början på en förfrågan, vanligen verktygen och systemprompten, och leverantören lagrar dess bearbetade form en kort stund. Nästa förfrågan som börjar med identisk text faktureras till reducerat pris för den delen. Vi beskriver Anthropics version här eftersom det är den vi mätte. Uppgifterna nedan kommer från dess dokumentation om promptcachning, kontrollerad den 18 oktober 2026.
Vad som cachas
En träff kräver exakt matchning. Varje block fram till och med det du markerade med cache_control måste vara identiskt, i ordningen verktyg, systemprompt och därefter meddelanden. Ändra ett enda tecken tidigt i prompten så blir allt efter det en miss. Själva frågan kommer sist, så den ingår aldrig i det cachade prefixet.
Prompter under en minimilängd cachas inte och inget fel returneras. För de aktuella Claude-modeller vi använde, Fable 5.1, Opus 5.5, Sonnet 5.5 och Haiku 5.5, är det dokumenterade minimivärdet 512 tokens. Cacheposter är isolerade per organisation, och per arbetsyta i Claude API.
Vad det kostar
Standardlivslängden är fem minuter, och varje användning av posten förnyar den utan extra avgift. En livslängd på en timme finns. Att skriva en post kostar 1,25 gånger grundpriset för indata i fem minuter och 2 gånger för en timme. Att läsa den kostar 0,1 gånger grundpriset för indata på de flesta modeller, 0,05 gånger på Opus 5.5 och Sonnet 5.5 och 0,025 gånger på Fable 5.1, enligt prissidan. Multiplikatorerna ändras, så läs den aktuella sidan innan du räknar.
Det promptcachning inte kan ta bort
Promptcachning ger rabatt på läsningen av prefixet. Den hoppar inte över modellen. Varje förfrågan ger fortfarande ett nytt svar, du väntar fortfarande på det och varje utdatatoken faktureras till fullt utdatapris.
Vår benchmark visar hur mycket det betyder. Vi skickade 3 000 kundsupportfrågor till var och en av fyra Claude-modeller med en policy på 2 200 tokens som systemprompt och leverantörens cachning påslagen. Mellan 90% och 93% av de räknade tokens var cacheläsningar av den policyn. Utdata var bara 6% till 9% av tokens, men 73% till 92% av baslinjens kostnad. Prefixet var redan billigt, så de återstående utgifterna låg i svaren.
Det är det gap som de andra lagren fyller. Hela metoden och resultaten finns i benchmarken för tokenbesparingar.
Cache för svar med exakt och semantisk matchning
Två lager besvarar en förfrågan ur minnet. De skiljer sig i hur de avgör att en ny förfrågan matchar en gammal.
Cache för exakta svar
En exakt cache lagrar det slutliga svaret under en nyckel som byggs av allt som formar det. Normalt är det modellen, promptversionen och den normaliserade frågan. När samma förfrågan kommer igen returneras det lagrade svaret och modellen anropas inte. Det finns ingen likhetspoäng och ingen risk att ett svar avsett för en annan fråga returneras.
I vår körning besvarade den exakta cachen cirka 39% av förfrågningarna. En upprepad fråga kom tillbaka på en median av cirka 0,05 ms. Det mättes med en Python-klient över loopback på samma maskin, så läs det som en lokal siffra och inte en nätverkssiffra. Benchmarken använde vanliga GET och SET för det här lagret. HotKV Enterprise har också en dedikerad promptcache med exakt matchning, PCACHE.*, med gränser per namnrymd och kostnadsspårning.
Exakt cache är blind för formulering. ”How do I reset my password?” och ”I forgot my password” är två olika nycklar.
Semantisk cache
En semantisk cache slår upp frågans betydelse. Den gör om frågan till en embedding, hittar den närmaste lagrade frågan och returnerar dess svar om cosinuslikheten passerar en tröskel. I HotKV är det SCACHE.*, byggt på samma vektorindex som vektorsökningen.
Cirka 31% av våra förfrågningar besvarades på det sättet. En omformulering tog en median på cirka 130 ms, nästan helt anropet till embedding-tjänsten, så en semantisk träff är mycket snabbare än ett modellanrop men inte omedelbar. Utan det semantiska lagret hade enbart en exakt cache behövt högst 1 264 modellanrop av 3 000, cirka 58% färre. Det semantiska lagret tog besparingen till cirka 70%.
Det är också där risken finns. En liknande fråga är inte alltid samma fråga. Vi lät en andra Claude-modell bedöma varje semantisk träff mot ett nytt svar. Vid vår standardtröskel på 0,81 passade cachade svar den exakta frågan 5,8 till 10,7 procentenheter mer sällan än nya. På Sonnet 5.5 visade trösklar på 0,88 och uppåt inget sådant underskott, med tunt underlag. Frågor som skrivits för att skilja sig åt i en avgörande detalj matchade ändå 62% av gångerna vid 0,81 och 10% vid 0,95.
Promptcachning mot semantisk cache sida vid sida
| Leverantörens promptcachning | Cache för exakta svar | Semantisk cache | |
|---|---|---|---|
| Vad den tar bort | En del av indatapriset | Hela modellanropet | Hela modellanropet |
| Matchningsregel | Identiskt prefix | Identisk förfrågan | Liknande betydelse över en tröskel |
| Utdatatokens faktureras | Ja, varje gång | Nej, vid en träff | Nej, vid en träff |
| Risk för fel svar | Ingen | Ingen för identiska förfrågningar | Verklig, styrs av tröskeln |
| Körs var | Hos leverantören | I din cache | I din cache, plus ett embedding-anrop |
| Andel av förfrågningarna i vår körning | Alltid på | Cirka 39% | Cirka 31% |
Leverantörens promptcachning och svarscache är inte alternativ till varandra. Det ena sänker priset på de anrop du fortfarande gör, och det andra minskar hur många anrop du gör.
Vad cache gör med latensen
Att hoppa över modellen ändrar hur snabbt svaren kommer, inte bara vad de kostar. I vår körning sjönk mediantiden till ett fullständigt svar från 2,7 sekunder till 127 ms på Fable 5.1, från 2,9 sekunder till 126 ms på Opus 5.5, från 1,8 sekunder till 128 ms på Sonnet 5.5 och från 1,4 sekunder till 125 ms på Haiku 5.5. Det är 11 till 23 gånger snabbare vid medianen.
Den långsamma änden rörde sig knappt. Cirka 30% av förfrågningarna nådde fortfarande modellen, och den 99:e percentilen på Fable 5.1 var cirka 6,4 sekunder med HotKV mot 6,6 sekunder utan. En cache tar bort väntan för de förfrågningar den besvarar och gör ingenting för dem den missar. Om ditt klagomål gäller ett långsamt värsta fall snarare än ett långsamt typiskt fall kommer enbart cache inte att lösa det.
Det här är tider till det fullständiga svaret, eftersom anropen inte strömmades. Ett strömmat svar visar sina första ord tidigare. Skillnaden i ett chattfönster är mindre än skillnaden i de här siffrorna.
Välja ett lager för din trafik
Rätt lager beror på hur dina förfrågningar upprepar sig, och det kan du mäta innan du bygger något.
Anpassa lagret efter trafiken
Anpassa lagret efter hur dina förfrågningar upprepar sig.
- En lång, stabil systemprompt eller verktygslista: använd leverantörens promptcachning. Den kostar lite att slå på och ändrar inga svar.
- Samma fråga med samma ord, som en knapp, en mall eller ett omförsök: använd en cache för exakta svar. Den är säker och snabb.
- Support-, sök- och FAQ-trafik där människor frågar samma sak med olika ord: lägg till en semantisk cache, sätt tröskeln högt och kontrollera svarskvaliteten på dina egna frågor innan du litar på den.
- Svar som beror på användaren, klockan eller live-data: cacha inga av dem, eller nyckla cachen på de fakta som ändrar svaret.
Besparingen följer upprepningen. När vi gjorde varje avsikt lika sannolik i stället för skev sjönk kostnaden 56% på de två modeller vi körde om, och med 3 000 helt olika frågor sjönk den 38%. En arbetslast utan upprepade eller liknande frågor sparar ingenting.
Mät din egen upprepning först
Innan du bygger något, ta reda på hur stor del av din trafik som upprepar sig. Siffran avgör om en exakt cache är värd att ha. Det tar tio minuter med de frågor du redan loggar. Normalisera varje fråga på det sätt din cachenyckel kommer att göra, räkna de distinkta och se hur stor del av trafiken som var en upprepning.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share är den andel av förfrågningarna som en exakt cache hade besvarat, när den väl sett varje fråga en första gång. Vår testmängd hade 1 264 distinkta frågor bland 3 000 förfrågningar, så siffran var cirka 58%. Om din hamnar nära 5% gör en exakt cache lite nytta, och bara ett semantiskt lager kan hjälpa.
Två varningar gäller. En cache börjar tom, så de första förfrågningarna når alltid modellen. I vår körning serverades cirka 52% av de första tusen förfrågningarna från cachen och cirka 81% av de sista tusen. Och en logg över förra månadens trafik berättar om förra månaden. Om du är på väg att lansera en funktion som ändrar vad människor frågar, se siffran som en grov vägledning.
Sätta ihop lagren
En förfrågan bör passera lagren från det billigaste och säkraste till det dyraste, och du bör kunna se vad vart och ett sparade.
Uppslagsordningen
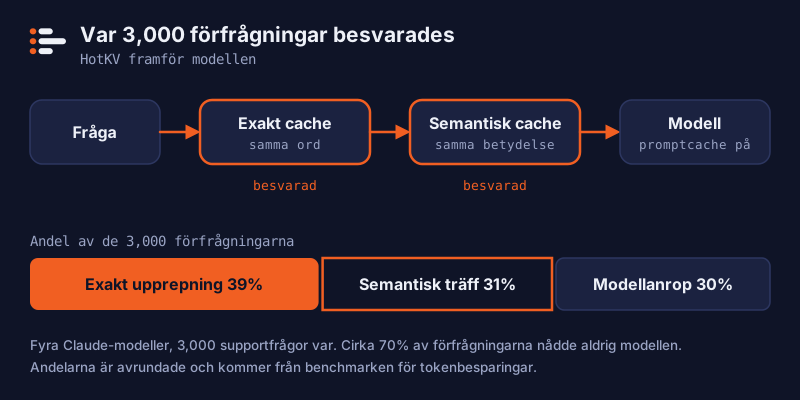
Ordningen spelar roll. Kontrollera det billigaste och säkraste lagret först och anropa modellen bara när allt missar. Det här utkastet förutsätter en klient i redis-py-stil med decode_responses=True, två namnrymder som skapats i förväg och dina egna funktioner embed och llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # samma ord

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # samma betydelse

    reply = llm.complete(question)                   # leverantörens promptcachning gäller här
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Skapa namnrymderna en gång med PCACHE.CREATE answers_exact och SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, med din embedding-modells dimension. AI-kommandona ingår i instanserna Performance och Scale på HotKV Cloud, och AI-sidan listar vad varje motor gör. Prissidan visar vilken plan som innehåller vad.
Hålla koll i produktion
En cache du inte kan se är en cache du inte kan lita på. HotKV räknar träffar och missar per namnrymd. Om du lagrar det ursprungliga anropets tokenanvändning med varje post kan det också redovisa de tokens och den kostnad som varje senare träff slapp. Svaren från PCACHE.STATS och SCACHE.STATS innehåller då fält som usage_saved_requests, usage_saved_input_tokens och usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Byt ut <model> mot din modells id. INPUT räknar de ocachade prompttokens och CACHEREAD de tokens som leverantören serverade från sin egen cache, så de två överlappar inte. Modellen måste finnas i HotKV:s prislista för att kostnadsfältet ska betyda något. LLMSTATS.PRICE LIST visar vilka modeller som är kända, och LLMSTATS.PRICE SET lägger till dina egna. En modell utan pris får sina tokens räknade, men dess kostnad registreras som noll och en separat räknare visar att förfrågningar förblev oprissatta.
Cache sänker utgifterna, och en budget sätter tak för det som återstår. LLMBUDGET.SET definierar en token- och dollargräns över ett tidsfönster. LLMBUDGET.CONSUME kontrolleras före modellanropet, så en skenande agent stoppas innan den spenderar pengarna, inte efteråt. LLMSTATS.RECORD håller totalsiffror per tenant som förstår leverantörens tokens för cacheläsning och cacheskrivning. Alla tre använder en och samma prislista när du anger modellnamnet, så en besparing, en budget och en siffra på instrumentpanelen kan inte säga emot varandra.
Misstag som får en cache att returnera fel svar
De flesta dåliga cacheträffar kommer av en nyckel där något saknas. Lägg modellen, promptversionen och varje verktygs- eller policyversion i den exakta nyckeln, så att en promptändring inte kan servera svar som skrivits för den gamla.
Ge poster en livslängd som motsvarar hur snabbt dina fakta ändras. Håll tenants isär med separata namnrymder så att en kunds svar aldrig erbjuds en annan. Cacha aldrig ett svar som innehåller personuppgifter om inte nyckeln inkluderar vems uppgifter det är.
Mät slutligen på din egen trafik. Våra siffror kommer från en offentlig datamängd med korta bankfrågor, en fiktiv policy och en körning per villkor, och de är inget löfte för din arbetslast.
Vanliga frågor
Vad är promptcachning?
Promptcachning är en funktion hos modellleverantören som lagrar den bearbetade början av en prompt en kort stund. En senare förfrågan som börjar med exakt samma text faktureras till lägre pris för den delen. Modellen körs ändå och ger ett nytt svar, så du betalar fortfarande för utdatatokens.
Är promptcachning samma sak som semantisk cache?
Nej. Promptcachning återanvänder ett upprepat promptprefix och anropar ändå modellen. Semantisk cache returnerar ett lagrat svar på en fråga med liknande betydelse och hoppar över modellanropet. De adresserar olika kostnader och kan användas tillsammans.
Minskar promptcachning kostnaden för utdatatokens?
Nej. Den sänker bara priset för att läsa det cachade prefixet. I vår benchmark var utdata 6% till 9% av tokens men 73% till 92% av baslinjens kostnad med promptcachning redan påslagen, och därför sparade cache av hela svar långt mer.
Hur länge varar Anthropics promptcache?
Standardvärdet är fem minuter, förnyat varje gång posten används. Ett alternativ på en timme finns till ett högre skrivpris. Kontrollera den aktuella dokumentationen, eftersom gränser och priser ändras.
Kan jag använda promptcachning och semantisk cache tillsammans?
Ja, och vår benchmark gjorde precis det. Leverantörens promptcachning var påslagen i båda körningarna, och det semantiska och det exakta lagret satt framför modellen. Cacheträffar hoppar över anropet, och missar drar fortfarande nytta av det rabatterade prefixet.
Vilken likhetströskel ska en semantisk cache använda?
Det finns inget universellt värde. Vi valde 0,81 på en separat träningsdel, och på Sonnet 5.5 visade cachade svar inget kvalitetsunderskott mot nya från 0,88 och uppåt, med tunt underlag. Börja högt, bedöm cachade svar mot nya på dina egna frågor och sänk tröskeln bara om kvaliteten håller.
Fortsätt samtalet
Kommentarer
Frågor om metoden? Ett annat resultat på din hårdvara? Dela med dig av vad du hittade. Kommentarer granskas innan de visas.