
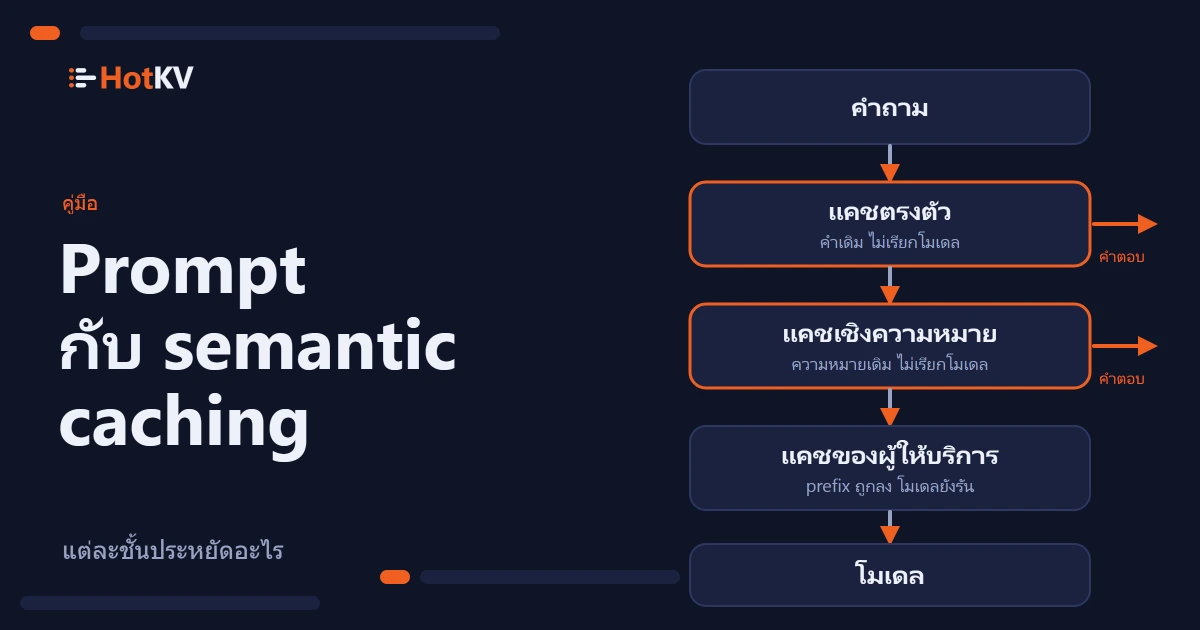
มีสองสิ่งที่ต่างกันถูกขายในชื่อการแคชสำหรับโมเดลภาษา และทีมต่างๆ ก็ซื้อสิ่งหนึ่งโดยคาดหวังอีกสิ่งหนึ่งอยู่บ่อยๆ Prompt caching เป็นฟีเจอร์ของผู้ให้บริการที่ทำให้การอ่านส่วนต้นของพรอมต์ที่ซ้ำถูกลง Semantic caching เป็นชั้นที่คุณรันเองซึ่งตอบคำถามจากหน่วยความจำ จึงไม่ต้องเรียกโมเดลเลย ทั้งสองแก้คนละครึ่งของบิล และทำงานได้ดีที่สุดเมื่อใช้ร่วมกัน
สรุปสั้นๆ Prompt caching ลดราคาส่วนต้นที่ซ้ำของพรอมต์ เช่น system prompt ที่ยาว แต่โมเดลยังทำงานและคุณยังจ่ายค่าทุกโทเค็นเอาต์พุต การแคชแบบตรงกันทุกตัวอักษรและแบบเชิงความหมายตัดการเรียกออกทั้งหมดเมื่อคำถามเคยถูกตอบแล้ว ในเบนช์มาร์ก 3,000 คำขอของเรา ที่เปิด prompt caching ของผู้ให้บริการไว้อยู่แล้ว การเพิ่ม HotKV ไว้ด้านหน้าลดการเรียกโมเดล โทเค็น และต้นทุนลงประมาณ 70% เพราะโทเค็นเอาต์พุตยังคิดเป็น 73% ถึง 92% ของต้นทุนฐาน
Prompt caching ทำงานอย่างไร
Prompt caching อยู่ที่ผู้ให้บริการโมเดล คุณทำเครื่องหมายส่วนต้นที่คงที่ของคำขอ ซึ่งมักเป็นเครื่องมือและ system prompt แล้วผู้ให้บริการเก็บรูปแบบที่ประมวลผลแล้วไว้ชั่วเวลาสั้นๆ คำขอถัดไปที่ขึ้นต้นด้วยข้อความเดียวกันเป๊ะจะถูกเรียกเก็บในอัตราที่ลดลงสำหรับส่วนนั้น เราอธิบายเวอร์ชันของ Anthropic ที่นี่ เพราะเป็นตัวที่เราวัด รายละเอียดด้านล่างมาจากเอกสาร prompt caching ของเขา ตรวจสอบเมื่อ 18 ตุลาคม 2026
อะไรถูกแคช
การเจอแคชต้องตรงกันทุกตัวอักษร ทุกบล็อกจนถึงและรวมบล็อกที่คุณทำเครื่องหมายด้วย cache_control ต้องเหมือนกัน ในลำดับเครื่องมือ system prompt แล้วจึงข้อความ เปลี่ยนหนึ่งตัวอักษรช่วงต้นของพรอมต์ ทุกอย่างหลังจากนั้นก็ไม่พบในแคช ตัวคำถามมาท้ายสุด จึงไม่เคยเป็นส่วนของส่วนต้นที่แคช
พรอมต์ที่สั้นกว่าความยาวขั้นต่ำจะไม่ถูกแคชและไม่คืนข้อผิดพลาด สำหรับโมเดล Claude ปัจจุบันที่เราใช้ คือ Fable 5.1, Opus 5.5, Sonnet 5.5 และ Haiku 5.5 ขั้นต่ำตามเอกสารคือ 512 โทเค็น รายการแคชแยกต่อองค์กร และต่อ workspace บน Claude API
ต้นทุนเท่าใด
อายุเริ่มต้นคือห้านาที และการใช้รายการแต่ละครั้งรีเฟรชอายุโดยไม่มีค่าใช้จ่ายเพิ่ม มีอายุหนึ่งชั่วโมงให้เลือกใช้ การเขียนรายการมีต้นทุน 1.25 เท่าของราคาอินพุตพื้นฐานสำหรับห้านาที และ 2 เท่าสำหรับหนึ่งชั่วโมง การอ่านมีต้นทุน 0.1 เท่าของราคาอินพุตพื้นฐานในโมเดลส่วนใหญ่ 0.05 เท่าบน Opus 5.5 และ Sonnet 5.5 และ 0.025 เท่าบน Fable 5.1 ตามหน้าราคา ตัวคูณเหล่านี้เปลี่ยนได้ จึงควรอ่านหน้าปัจจุบันก่อนคำนวณใดๆ
สิ่งที่ prompt caching ตัดออกไม่ได้
Prompt caching ลดราคาการอ่านส่วนต้น มันไม่ข้ามโมเดล ทุกคำขอยังสร้างคำตอบใหม่ คุณยังต้องรอ และทุกโทเค็นเอาต์พุตถูกเรียกเก็บเต็มราคาเอาต์พุต
เบนช์มาร์กของเราแสดงว่าเรื่องนี้สำคัญเพียงใด เราส่งคำถามซัพพอร์ตลูกค้า 3,000 ข้อไปยังโมเดล Claude แต่ละตัวจากสี่ตัว โดยมีนโยบายขนาด 2,200 โทเค็นเป็น system prompt และเปิด caching ของผู้ให้บริการ ระหว่าง 90% ถึง 93% ของโทเค็นที่นับเป็นการอ่านแคชของนโยบายนั้น เอาต์พุตเป็นเพียง 6% ถึง 9% ของโทเค็น แต่เป็น 73% ถึง 92% ของต้นทุนฐาน ส่วนต้นถูกอยู่แล้ว ค่าใช้จ่ายที่เหลือจึงอยู่ในคำตอบ
นั่นคือช่องว่างที่ชั้นอื่นเติมเต็ม วิธีการและผลทั้งหมดอยู่ในเบนช์มาร์กการประหยัดโทเค็น
การแคชคำตอบแบบตรงกันทุกตัวอักษรและแบบเชิงความหมาย
สองชั้นตอบคำขอจากหน่วยความจำ ต่างกันที่วิธีตัดสินว่าคำขอใหม่ตรงกับคำขอเก่า
การแคชคำตอบแบบตรงกันทุกตัวอักษร
แคชแบบตรงกันทุกตัวอักษรเก็บคำตอบสุดท้ายภายใต้คีย์ที่สร้างจากทุกสิ่งที่กำหนดรูปร่างของมัน โดยปกติคือโมเดล เวอร์ชันของพรอมต์ และคำถามที่ทำให้เป็นมาตรฐานแล้ว เมื่อคำขอเดิมเข้ามาอีก คำตอบที่เก็บไว้จะถูกส่งกลับและไม่มีการเรียกโมเดล ไม่มีคะแนนความคล้าย และไม่มีความเสี่ยงที่จะส่งคำตอบที่มีไว้สำหรับอีกคำถามหนึ่ง
ในการรันของเรา แคชแบบตรงกันทุกตัวอักษรตอบประมาณ 39% ของคำขอ คำถามที่ซ้ำกลับมาในเวลามัธยฐานประมาณ 0.05 ms วัดด้วยไคลเอนต์ Python ผ่าน loopback บนเครื่องเดียวกัน จึงควรอ่านเป็นตัวเลขในเครื่อง ไม่ใช่ตัวเลขเครือข่าย เบนช์มาร์กใช้ GET และ SET ธรรมดาสำหรับชั้นนี้ HotKV Enterprise ยังมี prompt cache แบบจับคู่ตรงกันทุกตัวอักษรโดยเฉพาะ คือ PCACHE.* พร้อมขีดจำกัดต่อ namespace และการติดตามต้นทุน
การแคชแบบตรงกันทุกตัวอักษรมองไม่เห็นถ้อยคำ "How do I reset my password?" กับ "I forgot my password" เป็นสองคีย์ที่ต่างกัน
การแคชเชิงความหมาย
Semantic cache ค้นหาความหมายของคำถาม มันแปลงคำถามเป็น embedding หาคำถามที่เก็บไว้ใกล้ที่สุด และส่งคำตอบของมันกลับถ้าความคล้ายแบบ cosine ผ่านเกณฑ์ ใน HotKV คือ SCACHE.* สร้างบนดัชนีเวกเตอร์เดียวกับ vector search
ประมาณ 31% ของคำขอของเราถูกตอบแบบนี้ คำถามที่เปลี่ยนคำพูดใช้เวลามัธยฐานประมาณ 130 ms เกือบทั้งหมดคือการเรียกบริการ embedding การเจอแบบเชิงความหมายจึงเร็วกว่าการเรียกโมเดลมาก แต่ไม่ใช่ทันที หากไม่มีชั้นเชิงความหมาย แคชแบบตรงกันทุกตัวอักษรอย่างเดียวจะต้องเรียกโมเดลมากที่สุด 1,264 ครั้งจาก 3,000 ครั้ง น้อยลงประมาณ 58% ชั้นเชิงความหมายพาการประหยัดไปถึงประมาณ 70%
มันก็เป็นที่ที่ความเสี่ยงอยู่ด้วย คำถามที่คล้ายกันไม่ได้เป็นคำถามเดียวกันเสมอไป เราให้โมเดล Claude อีกตัวหนึ่งตัดสินทุกการเจอเชิงความหมายเทียบกับคำตอบใหม่ ที่เกณฑ์เริ่มต้นของเรา 0.81 คำตอบจากแคชเหมาะกับคำถามนั้นเป๊ะๆ น้อยกว่าคำตอบใหม่ 5.8 ถึง 10.7 จุดเปอร์เซ็นต์ บน Sonnet 5.5 เกณฑ์ 0.88 ขึ้นไปไม่แสดงส่วนขาดเช่นนั้น แต่หลักฐานบาง คำถามที่เขียนให้ต่างกันด้วยรายละเอียดชี้ขาดเพียงข้อเดียวยังจับคู่ได้ 62% ของเวลาที่ 0.81 และ 10% ที่ 0.95
Prompt caching เทียบกับ semantic caching เคียงข้างกัน
| Prompt caching ของผู้ให้บริการ | แคชคำตอบแบบตรงกันทุกตัวอักษร | Semantic cache | |
|---|---|---|---|
| สิ่งที่ตัดออก | ส่วนหนึ่งของราคาอินพุต | การเรียกโมเดลทั้งหมด | การเรียกโมเดลทั้งหมด |
| กฎการจับคู่ | ส่วนต้นที่เหมือนกัน | คำขอที่เหมือนกัน | ความหมายคล้ายกันเกินเกณฑ์ |
| โทเค็นเอาต์พุตที่ถูกเรียกเก็บ | มี ทุกครั้ง | ไม่มี เมื่อเจอแคช | ไม่มี เมื่อเจอแคช |
| ความเสี่ยงของคำตอบผิด | ไม่มี | ไม่มีสำหรับคำขอที่เหมือนกัน | มีจริง ปรับด้วยเกณฑ์ |
| รันที่ไหน | ที่ผู้ให้บริการ | ในแคชของคุณ | ในแคชของคุณ บวกการเรียก embedding |
| สัดส่วนคำขอในการรันของเรา | เปิดอยู่เสมอ | ประมาณ 39% | ประมาณ 31% |
Prompt caching ของผู้ให้บริการและการแคชคำตอบไม่ได้เป็นทางเลือกแทนกัน อย่างหนึ่งลดราคาของการเรียกที่คุณยังทำ และอีกอย่างลดจำนวนการเรียกที่คุณทำ
การแคชกระทบเวลาแฝงอย่างไร
การข้ามโมเดลเปลี่ยนความเร็วที่คำตอบมาถึง ไม่ใช่แค่ต้นทุน ในการรันของเรา เวลามัธยฐานถึงคำตอบที่สมบูรณ์ลดจาก 2.7 วินาทีเหลือ 127 ms บน Fable 5.1 จาก 2.9 วินาทีเหลือ 126 ms บน Opus 5.5 จาก 1.8 วินาทีเหลือ 128 ms บน Sonnet 5.5 และจาก 1.4 วินาทีเหลือ 125 ms บน Haiku 5.5 นั่นเร็วขึ้น 11 ถึง 23 เท่าที่ค่ามัธยฐาน
ปลายด้านช้าแทบไม่ขยับ ประมาณ 30% ของคำขอยังไปถึงโมเดล และเปอร์เซ็นไทล์ที่ 99 บน Fable 5.1 อยู่ที่ประมาณ 6.4 วินาทีเมื่อมี HotKV เทียบกับ 6.6 วินาทีเมื่อไม่มี แคชขจัดการรอสำหรับคำขอที่มันตอบ และไม่ช่วยอะไรกับคำขอที่มันไม่พบ หากสิ่งที่คุณบ่นคือกรณีเลวร้ายที่สุดที่ช้า ไม่ใช่กรณีทั่วไปที่ช้า การแคชอย่างเดียวจะไม่แก้
ตัวเลขเหล่านี้คือเวลาถึงคำตอบที่สมบูรณ์ เพราะการเรียกไม่ได้สตรีม คำตอบแบบสตรีมแสดงคำแรกๆ ได้เร็วกว่า ช่องว่างในหน้าต่างแชตจึงเล็กกว่าช่องว่างในตัวเลขเหล่านี้
เลือกชั้นให้เหมาะกับทราฟฟิกของคุณ
ชั้นที่เหมาะสมขึ้นอยู่กับว่าคำขอของคุณซ้ำกันอย่างไร และคุณวัดสิ่งนั้นได้ก่อนสร้างอะไร
จับคู่ชั้นกับทราฟฟิก
จับคู่ชั้นกับวิธีที่คำขอของคุณซ้ำ
- system prompt หรือรายการเครื่องมือที่ยาวและคงที่: ใช้ prompt caching ของผู้ให้บริการ เปิดใช้แทบไม่มีต้นทุนและไม่เปลี่ยนคำตอบ
- คำถามเดียวกันด้วยถ้อยคำเดียวกัน เช่น ปุ่ม เทมเพลต หรือการลองใหม่: ใช้แคชคำตอบแบบตรงกันทุกตัวอักษร ปลอดภัยและเร็ว
- ทราฟฟิกซัพพอร์ต การค้นหา และ FAQ ที่ผู้คนถามเรื่องเดียวกันด้วยถ้อยคำต่างกัน: เพิ่ม semantic cache ตั้งเกณฑ์ให้สูง และตรวจคุณภาพคำตอบกับคำถามของคุณเองก่อนไว้ใจ
- คำตอบที่ขึ้นกับผู้ใช้ นาฬิกา หรือข้อมูลสด: อย่าแคชเลย หรือกำหนดคีย์ของแคชตามข้อเท็จจริงที่เปลี่ยนคำตอบ
การประหยัดเป็นไปตามการซ้ำ เมื่อเราทำให้ทุกเจตนามีโอกาสเท่ากันแทนที่จะเอียง ต้นทุนลดลง 56% บนสองโมเดลที่เรารันซ้ำ และเมื่อใช้คำถามที่ต่างกันหมด 3,000 ข้อ ลดลง 38% เวิร์กโหลดที่ไม่มีคำถามซ้ำหรือคล้ายกันจะไม่ประหยัดอะไรเลย
วัดการซ้ำของคุณเองก่อน
ก่อนสร้างอะไร ให้หาว่าทราฟฟิกของคุณซ้ำมากแค่ไหน ตัวเลขนั้นตัดสินว่าแคชแบบตรงกันทุกตัวอักษรคุ้มที่จะมีหรือไม่ ใช้เวลาสิบนาทีกับคำถามที่คุณบันทึกอยู่แล้ว ทำให้แต่ละคำถามเป็นมาตรฐานเหมือนที่คีย์แคชของคุณจะทำ นับคำถามที่ไม่ซ้ำ และดูว่าทราฟฟิกส่วนใดเป็นการซ้ำ
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share คือสัดส่วนของคำขอที่แคชแบบตรงกันทุกตัวอักษรจะตอบได้ เมื่อมันเห็นแต่ละคำถามเป็นครั้งแรกแล้ว ชุดทดสอบของเรามีคำถามที่ไม่ซ้ำ 1,264 ข้อในคำขอ 3,000 รายการ ตัวเลขจึงอยู่ที่ประมาณ 58% หากของคุณออกมาใกล้ 5% แคชแบบตรงกันทุกตัวอักษรจะช่วยได้น้อย และมีเพียงชั้นเชิงความหมายเท่านั้นที่ช่วยได้
มีข้อควรระวังสองข้อ แคชเริ่มต้นว่างเปล่า คำขอช่วงแรกจึงไปถึงโมเดลเสมอ ในการรันของเรา ประมาณ 52% ของคำขอพันรายการแรกถูกเสิร์ฟจากแคช และประมาณ 81% ของพันรายการสุดท้าย และบันทึกทราฟฟิกของเดือนที่แล้วบอกเรื่องเดือนที่แล้วเท่านั้น หากคุณกำลังจะเปิดตัวฟีเจอร์ที่เปลี่ยนสิ่งที่ผู้คนถาม ให้ถือตัวเลขนั้นเป็นแนวทางคร่าวๆ
นำชั้นต่างๆ มารวมกัน
คำขอควรผ่านชั้นต่างๆ จากที่ถูกและปลอดภัยที่สุดไปยังที่แพงที่สุด และคุณควรเห็นได้ว่าแต่ละชั้นประหยัดอะไร
ลำดับการค้นหา
ลำดับสำคัญ ตรวจชั้นที่ถูกและปลอดภัยที่สุดก่อน และเรียกโมเดลเมื่อทุกชั้นไม่พบเท่านั้น ตัวอย่างนี้สมมติไคลเอนต์สไตล์ redis-py ที่ตั้ง decode_responses=True สอง namespace ที่สร้างไว้ก่อน และฟังก์ชัน embed กับ llm ของคุณเอง
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # same words

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # same meaning

    reply = llm.complete(question)                   # provider prompt caching applies here
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
สร้าง namespace ครั้งเดียวด้วย PCACHE.CREATE answers_exact และ SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90 โดยใช้มิติของโมเดล embedding ของคุณ ชุดคำสั่ง AI มาพร้อมอินสแตนซ์ HotKV Cloud แผน Performance และ Scale และหน้า AIแสดงว่าแต่ละเอนจินทำอะไร หน้าราคาแสดงว่าแผนไหนรวมอะไร
ติดตามผลในโปรดักชัน
แคชที่คุณมองไม่เห็นคือแคชที่คุณไว้ใจไม่ได้ HotKV เก็บจำนวนที่เจอและที่ไม่พบต่อ namespace หากคุณเก็บการใช้โทเค็นของการเรียกเดิมไว้กับแต่ละรายการ มันยังระบุได้ว่าโทเค็นและต้นทุนเท่าใดที่ทุกการเจอแคชหลังจากนั้นหลีกเลี่ยงได้ คำตอบของ PCACHE.STATS และ SCACHE.STATS จึงมีฟิลด์ เช่น usage_saved_requests, usage_saved_input_tokens และ usage_saved_cost_usd
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
แทนที่ <model> ด้วย id ของโมเดลของคุณ INPUT นับโทเค็นพรอมต์ที่ไม่ได้มาจากแคช และ CACHEREAD นับโทเค็นที่ผู้ให้บริการเสิร์ฟจากแคชของตัวเอง สองตัวนี้จึงไม่ซ้อนทับกัน โมเดลต้องอยู่ในตารางราคาของ HotKV ฟิลด์ต้นทุนจึงมีความหมาย LLMSTATS.PRICE LIST แสดงว่ารู้จักโมเดลใดบ้าง และ LLMSTATS.PRICE SET เพิ่มของคุณเอง โมเดลที่ไม่มีราคายังนับโทเค็นของมัน แต่ต้นทุนถูกบันทึกเป็นศูนย์ และตัวนับแยกต่างหากแสดงว่ามีคำขอที่ไม่มีราคา
แคชลดการใช้จ่าย และงบประมาณจำกัดสิ่งที่เหลือ LLMBUDGET.SET กำหนดขีดจำกัดโทเค็นและดอลลาร์ตลอดช่วงเวลา LLMBUDGET.CONSUME ถูกตรวจก่อนการเรียกโมเดล เอเจนต์ที่ทำงานเกินการควบคุมจึงถูกหยุดก่อนที่มันจะใช้เงิน ไม่ใช่หลังจากนั้น LLMSTATS.RECORD เก็บยอดรวมต่อผู้เช่าที่เข้าใจโทเค็น cache-read และ cache-write ของผู้ให้บริการ ทั้งสามใช้ตารางราคาเดียวเมื่อคุณส่งชื่อโมเดล ตัวเลขที่ประหยัดได้ งบประมาณ และตัวเลขบนแดชบอร์ดจึงขัดแย้งกันไม่ได้
ความผิดพลาดที่ทำให้แคชคืนคำตอบผิด
การเจอแคชที่ไม่ดีส่วนใหญ่มาจากคีย์ที่ขาดอะไรบางอย่าง ใส่โมเดล เวอร์ชันของพรอมต์ และเวอร์ชันของเครื่องมือหรือนโยบายใดๆ ไว้ในคีย์แบบตรงกันทุกตัวอักษร การเปลี่ยนพรอมต์จะได้ไม่เสิร์ฟคำตอบที่เขียนไว้สำหรับพรอมต์เก่า
ให้รายการมีอายุที่ตรงกับความเร็วที่ข้อเท็จจริงของคุณเปลี่ยน แยกผู้เช่าออกจากกันด้วย namespace แยก เพื่อให้คำตอบของลูกค้ารายหนึ่งไม่ถูกเสนอให้อีกราย อย่าแคชคำตอบที่มีข้อมูลส่วนบุคคล เว้นแต่คีย์จะรวมว่าเป็นข้อมูลของใคร
สุดท้าย วัดบนทราฟฟิกของคุณเอง ตัวเลขของเรามาจากชุดข้อมูลสาธารณะหนึ่งชุดของคำถามธนาคารสั้นๆ นโยบายสมมติหนึ่งฉบับ และหนึ่งรอบต่อเงื่อนไข และไม่ใช่คำมั่นสัญญาสำหรับเวิร์กโหลดของคุณ
คำถามที่พบบ่อย
Prompt caching คืออะไร
Prompt caching เป็นฟีเจอร์ของผู้ให้บริการโมเดลที่เก็บส่วนต้นของพรอมต์ที่ประมวลผลแล้วไว้ชั่วเวลาสั้นๆ คำขอถัดไปที่ขึ้นต้นด้วยข้อความเดียวกันเป๊ะถูกเรียกเก็บในอัตราที่ต่ำลงสำหรับส่วนนั้น โมเดลยังทำงานและสร้างคำตอบใหม่ คุณจึงยังจ่ายค่าโทเค็นเอาต์พุต
Prompt caching เหมือนกับ semantic caching ไหม
ไม่ Prompt caching นำส่วนต้นของพรอมต์ที่ซ้ำมาใช้ใหม่และยังเรียกโมเดล ส่วน semantic caching ส่งคำตอบที่เก็บไว้กลับให้คำถามที่มีความหมายคล้ายกันและข้ามการเรียกโมเดล ทั้งสองจัดการต้นทุนคนละอย่างและใช้ร่วมกันได้
Prompt caching ลดต้นทุนโทเค็นเอาต์พุตไหม
ไม่ มันลดเพียงราคาของการอ่านส่วนต้นที่แคชไว้ ในเบนช์มาร์กของเรา เอาต์พุตเป็น 6% ถึง 9% ของโทเค็นแต่เป็น 73% ถึง 92% ของต้นทุนฐาน เมื่อเปิด prompt caching อยู่แล้ว นี่คือเหตุผลที่การแคชทั้งคำตอบประหยัดได้มากกว่ามาก
Prompt cache ของ Anthropic อยู่ได้นานเท่าใด
ค่าเริ่มต้นคือห้านาที รีเฟรชทุกครั้งที่ใช้รายการ มีตัวเลือกหนึ่งชั่วโมงในราคาเขียนที่สูงกว่า ตรวจเอกสารปัจจุบัน เพราะขีดจำกัดและราคาเปลี่ยนได้
ใช้ prompt caching กับ semantic caching ร่วมกันได้ไหม
ได้ และเบนช์มาร์กของเราทำเช่นนั้น Prompt caching ของผู้ให้บริการเปิดอยู่ทั้งสองการรัน และชั้นเชิงความหมายกับชั้นตรงกันทุกตัวอักษรอยู่หน้าโมเดล การเจอแคชข้ามการเรียก และการไม่พบยังได้ประโยชน์จากส่วนต้นที่ลดราคา
Semantic cache ควรใช้เกณฑ์ความคล้ายเท่าใด
ไม่มีค่าสากล เราเลือก 0.81 บนชุดฝึกที่แยกต่างหาก และบน Sonnet 5.5 คำตอบจากแคชไม่แสดงส่วนขาดด้านคุณภาพเทียบกับคำตอบใหม่ตั้งแต่ 0.88 ขึ้นไป แต่หลักฐานบาง เริ่มจากค่าสูง ตัดสินคำตอบจากแคชเทียบกับคำตอบใหม่บนคำถามของคุณเอง และลดเกณฑ์เมื่อคุณภาพยังคงอยู่เท่านั้น
ร่วมสนทนาต่อ
ความคิดเห็น
มีคำถามเกี่ยวกับวิธีการ หรือได้ผลต่างออกไปบนฮาร์ดแวร์ของคุณหรือไม่ เล่าให้เราฟังว่าคุณพบอะไร ความคิดเห็นจะได้รับการตรวจสอบก่อนแสดงผล