แท็ก

LLM

วิศวกรรม
วัดผลและอธิบายให้เข้าใจ

การใช้ HotKV ในแอปพลิเคชันโมเดลภาษา ทั้งการเรียกโมเดล การนับโทเค็น การนำคำตอบกลับมาใช้ซ้ำ และข้อแลกเปลี่ยนด้านคุณภาพของ semantic caching

4 บทความ ใน LLM

บทความ

ไอเดีย การทดลอง และความเคลื่อนไหว
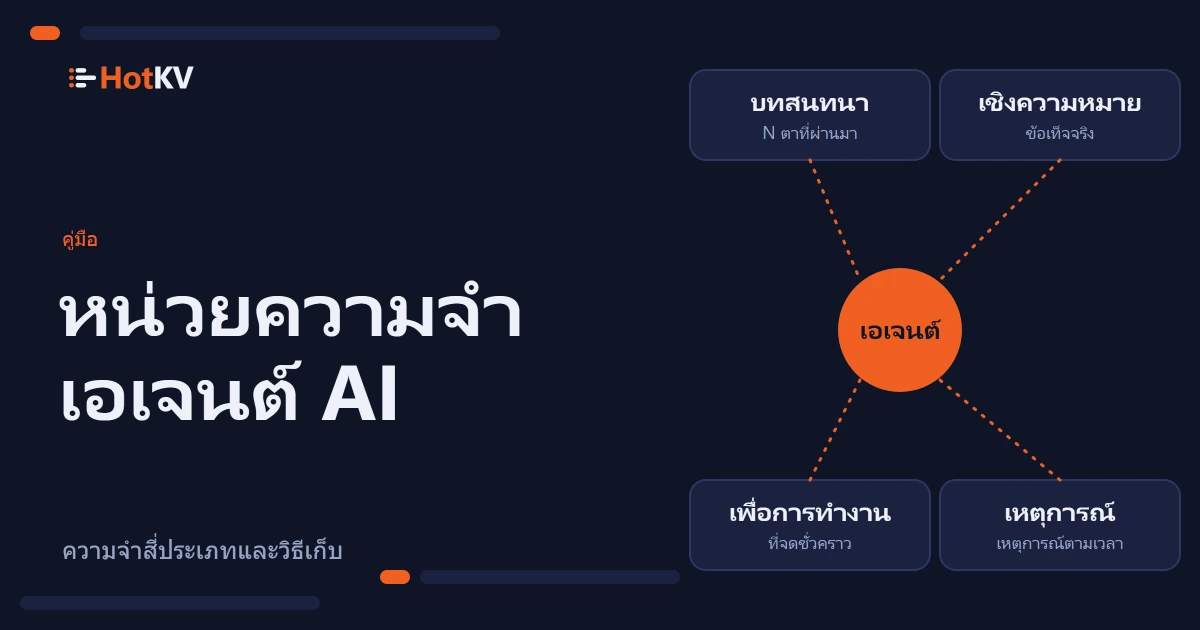
หน่วยความจำของเอเจนต์ AI ในภาพเอเจนต์ที่มีที่เก็บหน่วยความจำสี่แห่งล้อมรอบ ได้แก่ บทสนทนา เชิงความหมาย เพื่อการทำงาน และเหตุการณ์
คู่มืออ่าน 3 นาที

หน่วยความจำของเอเจนต์ AI: สี่ประเภทและวิธีเก็บ
หน่วยความจำของเอเจนต์ AI ไม่ใช่แค่หน้าต่างบริบทที่ยาว เอเจนต์ต้องการหน่วยความจำสี่แบบ เก็บแต่ละแบบอย่างไร และอะไรไม่ควรเก็บ พร้อมคำสั่ง HotKV

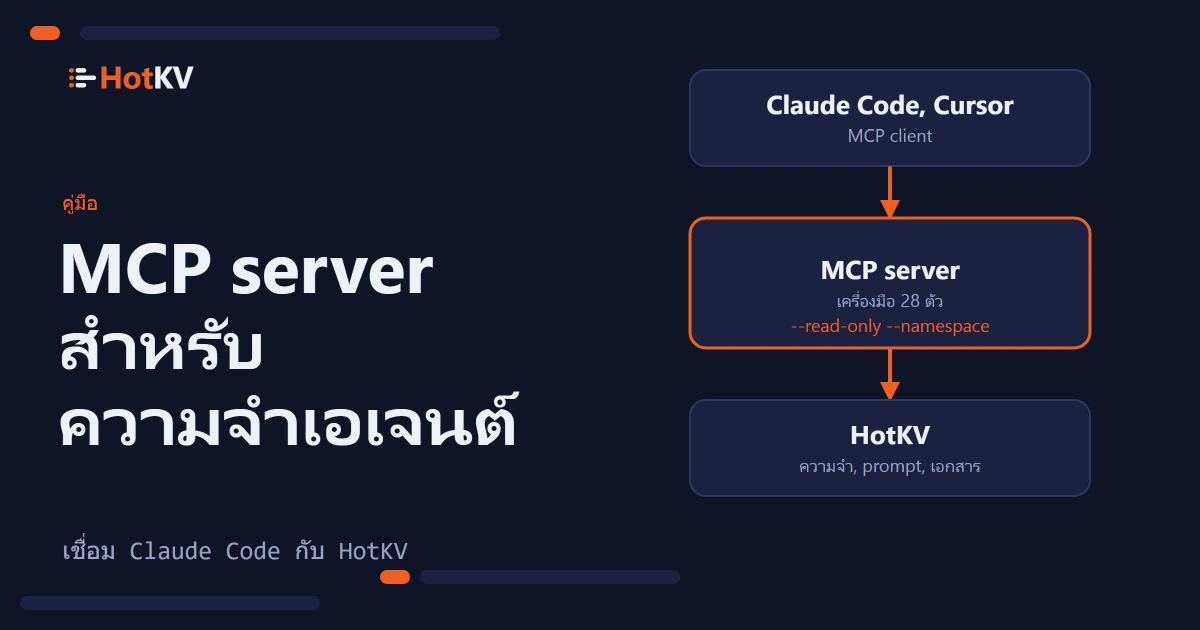
MCP server ที่อยู่ระหว่างผู้ช่วยอย่าง Claude Code กับ HotKV พร้อมเครื่องมือตายตัว 28 ตัว
คู่มืออ่าน 3 นาที

MCP server สำหรับหน่วยความจำของเอเจนต์: เชื่อมต่อ Claude Code กับ HotKV

MCP server ให้ Claude Code หรือ Cursor มีหน่วยความจำใน HotKV ผ่านเครื่องมือตายตัว 28 ตัว ติดตั้ง เชื่อมต่อ และจำกัดสิทธิ์ด้วยโหมดอ่านอย่างเดียวและ namespace

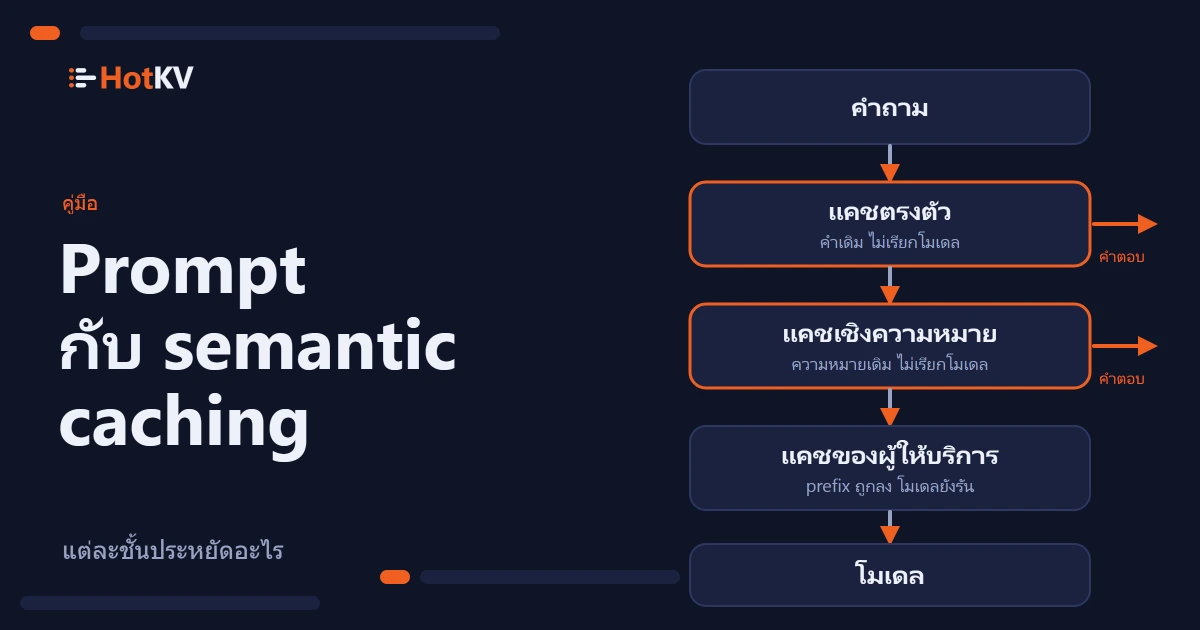
Prompt caching และ semantic caching ในภาพชั้นต่างๆ ที่คั่นระหว่างคำถามกับโมเดล
คู่มืออ่าน 4 นาที

Prompt caching กับ semantic caching: แต่ละแบบประหยัดอะไร

Prompt caching ทำให้ส่วนต้นของพรอมต์ที่ซ้ำถูกลง ส่วน semantic caching ตัดการเรียกโมเดลออกไป ทำงานอย่างไร เราวัดอะไรได้ และควรใช้แบบไหนเมื่อไร

ตามความอยากรู้ของคุณไป

สำรวจตามแท็ก

จดหมายข่าว

รับบทความใหม่ของ HotKV ทางอีเมลทุกครั้งที่เราเผยแพร่ ยืนยันเพียงครั้งเดียว ยกเลิกได้ในคลิกเดียว ชอบใช้ฟีดมากกว่าใช่ไหม ใช้ RSS