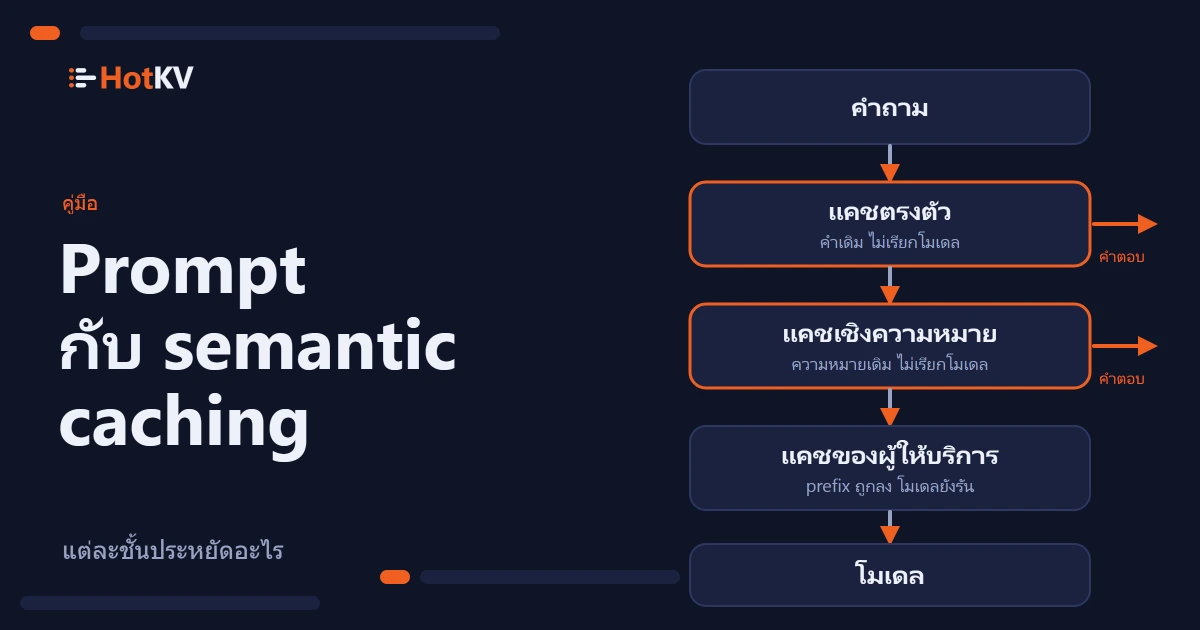
Prompt caching กับ semantic caching: แต่ละแบบประหยัดอะไร
Prompt caching ทำให้ส่วนต้นของพรอมต์ที่ซ้ำถูกลง ส่วน semantic caching ตัดการเรียกโมเดลออกไป ทำงานอย่างไร เราวัดอะไรได้ และควรใช้แบบไหนเมื่อไร
แท็ก
Prompt caching ของผู้ให้บริการและการแคชคำตอบสำหรับแอป LLM ว่าแต่ละแบบประหยัดโทเค็นและต้นทุนได้เท่าใด และจุดที่แต่ละแบบเลิกช่วยได้
2 บทความ ใน Prompt caching
Prompt caching ทำให้ส่วนต้นของพรอมต์ที่ซ้ำถูกลง ส่วน semantic caching ตัดการเรียกโมเดลออกไป ทำงานอย่างไร เราวัดอะไรได้ และควรใช้แบบไหนเมื่อไร
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
ตามความอยากรู้ของคุณไป