

Für Sprachmodelle werden zwei verschiedene Dinge als Caching verkauft, und Teams kaufen regelmäßig das eine und erwarten das andere. Prompt-Caching ist eine Funktion des Anbieters, die das Lesen eines wiederholten Prompt-Präfixes billiger macht. Semantisches Caching ist eine Schicht, die Sie selbst betreiben und die eine Frage aus dem Speicher beantwortet, sodass das Modell gar nicht aufgerufen wird. Sie lösen unterschiedliche Hälften der Rechnung, und am besten arbeiten sie zusammen.
Kurz gesagt. Prompt-Caching gewährt einen Rabatt auf den wiederholten Anfang eines Prompts, etwa einen langen Systemprompt. Das Modell läuft aber weiterhin, und Sie zahlen weiterhin für jedes Ausgabe-Token. Exaktes und semantisches Caching entfernen den Aufruf ganz, wenn eine Frage schon einmal beantwortet wurde. In unserem Benchmark mit 3.000 Anfragen, bei dem das Prompt-Caching des Anbieters bereits eingeschaltet war, senkte HotKV davor die Modellaufrufe, die Token und die Kosten um etwa 70 %, weil die Ausgabe-Token weiterhin 73 % bis 92 % der Baseline-Kosten ausmachten.
So funktioniert Prompt-Caching
Prompt-Caching sitzt beim Modellanbieter. Sie markieren den stabilen Anfang einer Anfrage, meist die Werkzeuge und den Systemprompt, und der Anbieter speichert dessen verarbeitete Form für kurze Zeit. Die nächste Anfrage, die mit identischem Text beginnt, wird für diesen Teil zu einem ermäßigten Satz abgerechnet. Wir beschreiben hier die Variante von Anthropic, weil wir sie gemessen haben. Die Angaben unten stammen aus der Dokumentation zum Prompt-Caching und wurden am 18. Oktober 2026 geprüft.
Was gecacht wird
Ein Treffer erfordert eine exakte Übereinstimmung. Jeder Block bis einschließlich des Blocks, den Sie mit cache_control markiert haben, muss identisch sein, in der Reihenfolge Werkzeuge, Systemprompt, dann Nachrichten. Ändern Sie ein einziges Zeichen früh im Prompt, ist alles danach ein Miss. Die Frage selbst steht zuletzt und gehört deshalb nie zum gecachten Präfix.
Prompts unterhalb einer Mindestlänge werden nicht gecacht, und es wird kein Fehler zurückgegeben. Für die aktuellen Claude-Modelle, die wir verwendet haben, Fable 5.1, Opus 5.5, Sonnet 5.5 und Haiku 5.5, beträgt das dokumentierte Minimum 512 Token. Cache-Einträge sind pro Organisation isoliert und in der Claude API pro Workspace.
Was es kostet
Die Standard-Lebensdauer beträgt fünf Minuten, und jede Nutzung des Eintrags verlängert sie ohne Aufpreis. Eine Lebensdauer von einer Stunde ist verfügbar. Das Schreiben eines Eintrags kostet für fünf Minuten das 1,25-Fache des Basispreises für Eingabe und für eine Stunde das 2-Fache. Das Lesen kostet laut Preisseite bei den meisten Modellen das 0,1-Fache des Basispreises für Eingabe, bei Opus 5.5 und Sonnet 5.5 das 0,05-Fache und bei Fable 5.1 das 0,025-Fache. Diese Faktoren ändern sich, lesen Sie daher die aktuelle Seite, bevor Sie rechnen.
Was Prompt-Caching nicht beseitigen kann
Prompt-Caching verbilligt das Lesen des Präfixes. Das Modell überspringt es nicht. Jede Anfrage erzeugt weiterhin eine frische Antwort, Sie warten weiterhin darauf, und jedes Ausgabe-Token wird zum vollen Ausgabepreis berechnet.
Unser Benchmark zeigt, wie viel das ausmacht. Wir haben 3.000 Kundensupport-Fragen an jedes von vier Claude-Modellen gesendet, mit einer Richtlinie von 2.200 Token als Systemprompt und eingeschaltetem Caching des Anbieters. Zwischen 90 % und 93 % der gezählten Token waren Cache-Lesezugriffe auf diese Richtlinie. Die Ausgabe machte nur 6 % bis 9 % der Token aus, aber 73 % bis 92 % der Baseline-Kosten. Das Präfix war schon günstig, die verbleibenden Ausgaben steckten also in den Antworten.
Diese Lücke füllen die anderen Schichten. Die vollständige Methode und die Ergebnisse stehen im Benchmark zur Token-Einsparung.
Exaktes und semantisches Antwort-Caching
Zwei Schichten beantworten eine Anfrage aus dem Speicher. Sie unterscheiden sich darin, wie sie entscheiden, dass eine neue Anfrage zu einer alten passt.
Exaktes Antwort-Caching
Ein exakter Cache speichert die endgültige Antwort unter einem Schlüssel, der aus allem gebildet wird, was sie bestimmt. Normalerweise sind das das Modell, die Version des Prompts und die normalisierte Frage. Trifft dieselbe Anfrage erneut ein, wird die gespeicherte Antwort zurückgegeben und das Modell nicht aufgerufen. Es gibt keinen Ähnlichkeitswert und kein Risiko, eine Antwort auszuliefern, die für eine andere Frage gedacht war.
In unserem Lauf beantwortete der exakte Cache etwa 39 % der Anfragen. Eine wiederholte Frage kam im Median nach etwa 0,05 ms zurück. Gemessen wurde das mit einem Python-Client über Loopback auf derselben Maschine, es ist also ein lokaler Wert und kein Netzwerkwert. Der Benchmark nutzte für diese Schicht einfaches GET und SET. HotKV Enterprise bietet außerdem einen eigenen Prompt-Cache mit exakter Übereinstimmung, PCACHE.*, mit Limits pro Namensraum und Kostenverfolgung.
Exaktes Caching ist blind für Formulierungen. „How do I reset my password?“ und „I forgot my password“ sind zwei verschiedene Schlüssel.
Semantisches Caching
Ein semantischer Cache schlägt die Bedeutung der Frage nach. Er wandelt die Frage in ein Embedding um, findet die nächste gespeicherte Frage und gibt deren Antwort zurück, wenn die Kosinus-Ähnlichkeit einen Schwellenwert erreicht. In HotKV ist das SCACHE.*, aufgebaut auf demselben Vektorindex wie die Vektorsuche.
Etwa 31 % unserer Anfragen wurden auf diese Weise beantwortet. Eine Umformulierung dauerte im Median etwa 130 ms, fast alles davon der Aufruf des Embedding-Dienstes. Ein semantischer Treffer ist also deutlich schneller als ein Modellaufruf, aber nicht sofort da. Ohne die semantische Schicht hätte ein exakter Cache allein höchstens 1.264 Modellaufrufe von 3.000 benötigt, etwa 58 % weniger. Die semantische Schicht hat die Einsparung auf etwa 70 % gesteigert.
Hier liegt auch das Risiko. Eine ähnliche Frage ist nicht immer dieselbe Frage. Wir haben ein zweites Claude-Modell jeden semantischen Treffer gegen eine frische Antwort beurteilen lassen. Bei unserem Standard-Schwellenwert von 0,81 passten zwischengespeicherte Antworten um 5,8 bis 10,7 Prozentpunkte seltener zur exakten Frage als frische. Bei Sonnet 5.5 zeigten Schwellenwerte ab 0,88 keine solche Lücke, bei dünner Beleglage. Fragen, die absichtlich in einem entscheidenden Detail abwichen, stimmten bei 0,81 immer noch zu 62 % überein und bei 0,95 zu 10 %.
Prompt-Caching und semantisches Caching im direkten Vergleich
| Prompt-Caching des Anbieters | Exakter Antwort-Cache | Semantischer Cache | |
|---|---|---|---|
| Was es entfernt | Einen Teil des Eingabepreises | Den ganzen Modellaufruf | Den ganzen Modellaufruf |
| Regel für die Übereinstimmung | Identisches Präfix | Identische Anfrage | Ähnliche Bedeutung oberhalb eines Schwellenwerts |
| Berechnete Ausgabe-Token | Ja, jedes Mal | Nein, bei einem Treffer | Nein, bei einem Treffer |
| Risiko falscher Antworten | Keines | Keines bei identischen Anfragen | Real, über den Schwellenwert einstellbar |
| Läuft wo | Beim Anbieter | In Ihrem Cache | In Ihrem Cache, plus ein Embedding-Aufruf |
| Anteil der Anfragen in unserem Lauf | Immer an | Etwa 39 % | Etwa 31 % |
Prompt-Caching des Anbieters und Antwort-Caching sind keine Alternativen. Das eine senkt den Preis der Aufrufe, die Sie weiterhin machen, das andere senkt, wie viele Aufrufe Sie machen.
Was Caching für die Latenz bedeutet
Das Modell zu überspringen verändert nicht nur, was Antworten kosten, sondern auch, wie schnell sie eintreffen. In unserem Lauf sank die mediane Zeit bis zur vollständigen Antwort bei Fable 5.1 von 2,7 Sekunden auf 127 ms, bei Opus 5.5 von 2,9 Sekunden auf 126 ms, bei Sonnet 5.5 von 1,8 Sekunden auf 128 ms und bei Haiku 5.5 von 1,4 Sekunden auf 125 ms. Das ist im Median 11- bis 23-mal schneller.
Das langsame Ende hat sich kaum bewegt. Etwa 30 % der Anfragen erreichten weiterhin das Modell, und das 99. Perzentil lag bei Fable 5.1 mit HotKV bei etwa 6,4 Sekunden gegenüber 6,6 Sekunden ohne. Ein Cache beseitigt das Warten bei den Anfragen, die er beantwortet, und hilft bei denen nicht, die er verfehlt. Wenn Ihr Problem ein langsamer schlimmster Fall ist und nicht ein langsamer typischer Fall, behebt Caching allein es nicht.
Das sind Zeiten bis zur vollständigen Antwort, weil die Aufrufe nicht gestreamt wurden. Eine gestreamte Antwort zeigt ihre ersten Worte früher. In einem Chatfenster ist der Abstand kleiner als in diesen Zahlen.
Die passende Schicht für Ihren Traffic wählen
Die richtige Schicht hängt davon ab, wie sich Ihre Anfragen wiederholen, und das können Sie messen, bevor Sie etwas bauen.
Die Schicht auf den Traffic abstimmen
Stimmen Sie die Schicht darauf ab, wie sich Ihre Anfragen wiederholen.
- Ein langer, stabiler Systemprompt oder eine lange Werkzeugliste: Nutzen Sie das Prompt-Caching des Anbieters. Es ist mit wenig Aufwand eingeschaltet und verändert keine Antworten.
- Dieselbe Frage mit denselben Worten, etwa bei einem Button, einer Vorlage oder einem Retry: Nutzen Sie einen exakten Antwort-Cache. Er ist sicher und schnell.
- Support-, Such- und FAQ-Traffic, bei dem Menschen dasselbe mit anderen Worten fragen: Fügen Sie einen semantischen Cache hinzu, setzen Sie den Schwellenwert hoch, und prüfen Sie die Antwortqualität an Ihren eigenen Fragen, bevor Sie ihm vertrauen.
- Antworten, die vom Nutzer, von der Uhrzeit oder von Live-Daten abhängen: Cachen Sie keine davon, oder bilden Sie den Cache-Schlüssel aus den Fakten, die die Antwort ändern.
Die Einsparung folgt der Wiederholung. Als wir jeden Intent gleich wahrscheinlich machten statt verzerrt, sanken die Kosten bei den beiden erneut ausgeführten Modellen um 56 %, und bei 3.000 lauter verschiedenen Fragen sanken sie um 38 %. Ein Workload ohne wiederholte oder ähnliche Fragen spart nichts.
Zuerst die eigene Wiederholungsrate messen
Bevor Sie etwas bauen, finden Sie heraus, wie viel Ihres Traffics sich wiederholt. Die Zahl entscheidet, ob sich ein exakter Cache lohnt. Mit den Fragen, die Sie ohnehin protokollieren, dauert das zehn Minuten. Normalisieren Sie jede Frage so, wie es Ihr Cache-Schlüssel tun wird, zählen Sie die verschiedenen und sehen Sie nach, welcher Anteil des Traffics eine Wiederholung war.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share ist der Anteil der Anfragen, die ein exakter Cache beantwortet hätte, nachdem er jede Frage einmal gesehen hat. Unser Testsatz hatte 1.264 verschiedene Fragen bei 3.000 Anfragen, der Wert lag also bei etwa 58 %. Liegt Ihrer nahe bei 5 %, bringt ein exakter Cache wenig, und nur eine semantische Schicht kann helfen.
Zwei Vorbehalte gelten. Ein Cache startet leer, daher erreichen die frühen Anfragen immer das Modell. In unserem Lauf wurden etwa 52 % der ersten tausend Anfragen aus dem Cache bedient und etwa 81 % der letzten tausend. Und ein Log des Traffics vom letzten Monat sagt etwas über den letzten Monat. Wenn Sie ein Feature starten, das verändert, was Menschen fragen, betrachten Sie die Zahl nur als grobe Orientierung.
Die Schichten zusammensetzen
Eine Anfrage sollte die Schichten von der günstigsten und sichersten bis zur teuersten durchlaufen, und Sie sollten sehen können, was jede gespart hat.
Die Reihenfolge der Lookups
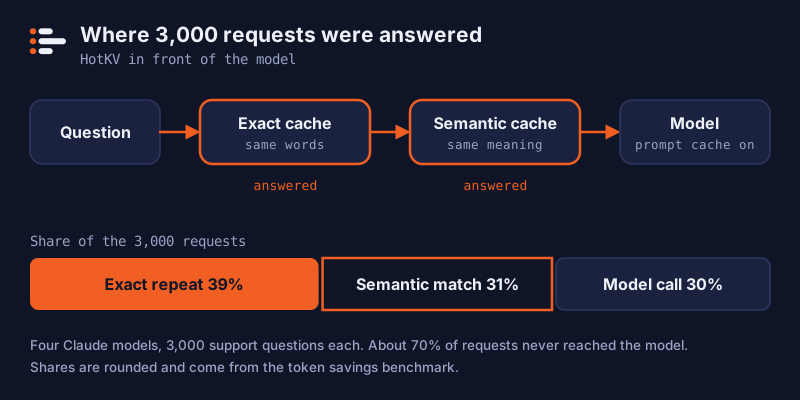
Die Reihenfolge ist wichtig. Prüfen Sie zuerst die günstigste und sicherste Schicht, und rufen Sie das Modell nur auf, wenn alles verfehlt. Diese Skizze setzt einen Client im Stil von redis-py mit decode_responses=True voraus, zwei vorab angelegte Namensräume und Ihre eigenen Funktionen embed und llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # gleiche Worte

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # gleiche Bedeutung

    reply = llm.complete(question)                   # hier greift das Prompt-Caching des Anbieters
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Legen Sie die Namensräume einmalig mit PCACHE.CREATE answers_exact und SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90 an, mit der Dimension Ihres Embedding-Modells. Der KI-Befehlssatz gehört zu den HotKV-Cloud-Instanzen der Tarife Performance und Scale, und die KI-Seite listet auf, was jede Engine leistet. Die Preisseite zeigt, welcher Tarif was enthält.
Die Bilanz im Produktivbetrieb im Blick behalten
Einen Cache, den Sie nicht sehen, können Sie nicht vertrauen. HotKV führt Zähler für Treffer und Misses pro Namensraum. Wenn Sie mit jedem Eintrag den Token-Verbrauch des ursprünglichen Aufrufs speichern, kann HotKV außerdem die Token und Kosten zuordnen, die jeder spätere Treffer vermieden hat. Die Antworten von PCACHE.STATS und SCACHE.STATS enthalten dann Felder wie usage_saved_requests, usage_saved_input_tokens und usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Ersetzen Sie <model> durch die ID Ihres Modells. INPUT zählt die nicht gecachten Prompt-Token und CACHEREAD die Token, die der Anbieter aus seinem eigenen Cache geliefert hat, die beiden überschneiden sich also nicht. Das Modell muss in der Preistabelle von HotKV stehen, damit das Kostenfeld etwas aussagt. LLMSTATS.PRICE LIST zeigt, welche Modelle bekannt sind, und LLMSTATS.PRICE SET fügt Ihre eigenen hinzu. Bei einem Modell ohne Preis werden die Token trotzdem gezählt, die Kosten aber als null erfasst, und ein eigener Zähler zeigt, dass Anfragen ohne Preis blieben.
Caches senken die Ausgaben, und ein Budget begrenzt, was übrig bleibt. LLMBUDGET.SET legt ein Limit für Token und Dollar über ein Zeitfenster fest. LLMBUDGET.CONSUME wird vor dem Modellaufruf geprüft, sodass ein außer Kontrolle geratener Agent gestoppt wird, bevor er das Geld ausgibt, und nicht danach. LLMSTATS.RECORD führt Summen pro Mandant, die die Cache-Lese- und Cache-Schreib-Token des Anbieters berücksichtigen. Alle drei nutzen eine einzige Preistabelle, wenn Sie den Modellnamen übergeben, sodass eine Einsparung, ein Budget und eine Dashboard-Zahl nicht voneinander abweichen können.
Fehler, durch die ein Cache falsche Antworten liefert
Die meisten schlechten Cache-Treffer entstehen durch einen Schlüssel, dem etwas fehlt. Nehmen Sie das Modell, die Version des Prompts und jede Werkzeug- oder Richtlinienversion in den exakten Schlüssel auf, damit eine Änderung am Prompt keine Antworten ausliefert, die für den alten geschrieben wurden.
Geben Sie Einträgen eine Lebensdauer, die dazu passt, wie schnell sich Ihre Fakten ändern. Trennen Sie Mandanten durch eigene Namensräume, damit die Antwort eines Kunden nie einem anderen angeboten wird. Cachen Sie niemals eine Antwort mit personenbezogenen Daten, es sei denn, der Schlüssel enthält, wessen Daten es sind.
Messen Sie schließlich an Ihrem eigenen Traffic. Unsere Zahlen stammen aus einem öffentlichen Datensatz kurzer Banking-Fragen, einer fiktiven Richtlinie und einem Lauf pro Bedingung, und sie sind kein Versprechen für Ihren Workload.
Häufig gestellte Fragen
Was ist Prompt-Caching?
Prompt-Caching ist eine Funktion von Modellanbietern, die den verarbeiteten Anfang eines Prompts für kurze Zeit speichert. Eine spätere Anfrage, die mit genau demselben Text beginnt, wird für diesen Teil zu einem niedrigeren Satz abgerechnet. Das Modell läuft weiterhin und erzeugt eine neue Antwort, Sie zahlen also weiterhin für Ausgabe-Token.
Ist Prompt-Caching dasselbe wie semantisches Caching?
Nein. Prompt-Caching verwendet ein wiederholtes Prompt-Präfix wieder und ruft das Modell weiterhin auf. Semantisches Caching gibt eine gespeicherte Antwort auf eine Frage mit ähnlicher Bedeutung zurück und überspringt den Modellaufruf. Sie betreffen unterschiedliche Kosten und lassen sich zusammen einsetzen.
Senkt Prompt-Caching die Kosten für Ausgabe-Token?
Nein. Es senkt nur den Preis für das Lesen des gecachten Präfixes. In unserem Benchmark machte die Ausgabe 6 % bis 9 % der Token aus, aber 73 % bis 92 % der Baseline-Kosten bei bereits eingeschaltetem Prompt-Caching. Deshalb hat das Caching ganzer Antworten weit mehr gespart.
Wie lange hält der Prompt-Cache von Anthropic?
Standard sind fünf Minuten, bei jeder Nutzung des Eintrags verlängert. Eine Option mit einer Stunde ist zu einem höheren Schreibpreis verfügbar. Prüfen Sie die aktuelle Dokumentation, denn Limits und Preise ändern sich.
Kann ich Prompt-Caching und semantisches Caching zusammen verwenden?
Ja, und genau das hat unser Benchmark getan. Das Prompt-Caching des Anbieters blieb in beiden Läufen eingeschaltet, und die semantische und die exakte Schicht standen vor dem Modell. Cache-Treffer überspringen den Aufruf, und Misses profitieren weiterhin vom ermäßigten Präfix.
Welchen Ähnlichkeits-Schwellenwert sollte ein semantischer Cache verwenden?
Einen universellen Wert gibt es nicht. Wir haben 0,81 auf einem separaten Trainings-Split gewählt, und bei Sonnet 5.5 zeigten zwischengespeicherte Antworten ab 0,88 kein Qualitätsdefizit gegenüber frischen, bei dünner Beleglage. Beginnen Sie hoch, beurteilen Sie zwischengespeicherte gegen frische Antworten an Ihren eigenen Fragen, und senken Sie den Schwellenwert nur, wenn die Qualität hält.

Diskutieren Sie mit
Kommentare
Fragen zur Methode? Ein anderes Ergebnis auf Ihrer Hardware? Teilen Sie mit, was Sie herausgefunden haben. Kommentare werden vor der Veröffentlichung geprüft.