

KI-Agentengedächtnis ist das, was einen Agenten etwas von einem Schritt oder einer Sitzung in die nächste mitnehmen lässt. Ein Sprachmodell allein erinnert sich zwischen zwei Aufrufen an nichts. Woran es sich zu erinnern scheint, hat Ihr Code zuvor in den Prompt zurückgeschrieben. Wie Sie dieses Material speichern und abrufen, bestimmt, woran sich der Agent erinnern kann, wie schnell und zu welchen Kosten pro Runde.
Kurz gesagt. Agenten brauchen vier Arten von Gedächtnis: ein kurzes Gesprächsfenster, Langzeitfakten, die über ihre Bedeutung gefunden werden, einen Notizblock für die laufende Aufgabe und ein Protokoll dessen, was geschehen ist. Jede hat eine andere Form, Lebensdauer und Abfrage, weshalb eine einzige Gedächtnistabelle keiner von ihnen gerecht wird. HotKV speichert alle vier in einer In-Memory-Engine mit den
AMEM.*-Befehlen. Wir haben das Caching und die Vektorsuche von HotKV gemessen, nicht das Agentengedächtnis, daher erklärt dieser Artikel das Design und behauptet keine Beschleunigung.
Warum ein Kontextfenster kein Gedächtnis ist
Ein Kontextfenster ist der Text, den Sie mit jeder Anfrage senden. Es hat eine Größenbegrenzung, Sie zahlen in jeder Runde Eingabe-Token für alles darin, und es verschwindet, wenn die Sitzung endet. Außerdem lässt es sich nicht durchsuchen. Braucht ein Agent einen einzelnen Fakt von vor drei Wochen, ist es keine Antwort, den ganzen Verlauf einzufügen.
Gedächtnis ist die Schicht, die entscheidet, was als Nächstes ins Fenster kommt. Sie behält die letzten Runden und findet die wenigen älteren Fakten, die zählen. Sie hält den Zustand der aktuellen Aufgabe fest und protokolliert, was der Agent getan hat. Auch die Forschung beschreibt Agenten in ähnlichen Begriffen. Das CoALA-Framework von Sumers, Yao, Narasimhan und Griffiths trennt das Arbeitsgedächtnis vom episodischen, semantischen und prozeduralen Langzeitgedächtnis.
Die vier Arten von KI-Agentengedächtnis
Die vier Speicher von HotKV decken weitgehend dasselbe Feld ab, angepasst an das, was eine Anwendung bauen muss. Prozedurales Gedächtnis, das Know-how im Code und in den Prompts des Agenten, liegt normalerweise in Ihrem Repository oder einer Prompt-Registry und ist kein eigener Speicher.
Konversationsgedächtnis
Das ist das kurzfristige Transkript einer Sitzung. Nachrichten tragen eine Rolle (System, Nutzer, Assistent oder Werkzeug). Sie liegen in einem begrenzten gleitenden Fenster, sodass die ältesten Runden herausfallen, sobald das Limit erreicht ist. Es beantwortet eine einzige Frage. Was wurde zuletzt gesagt? In HotKV sind das AMEM.CONV.CREATE, AMEM.CONV.APPEND und AMEM.CONV.WINDOW.
Semantisches Gedächtnis
Semantisches Gedächtnis ist Langzeitwissen, gespeichert als Fakten mit einem Embedding-Vektor. Der Agent ruft sie über ihre Bedeutung ab, nicht über einen Schlüssel. Dahinter steht ein HNSW-Vektorindex, derselbe Typ, der die Vektorsuche antreibt. AMEM.SEM.STORE speichert einen Fakt, und AMEM.SEM.RECALL liefert die besten Treffer mit einem Ähnlichkeitswert. Hierhin gehören Dokumente, Nutzerpräferenzen und gelernte Korrekturen.
Arbeitsgedächtnis
Das Arbeitsgedächtnis ist der Notizblock für eine laufende Aufgabe, eine flache Menge von Schlüsseln und Werten im Rahmen einer Sitzung. Es hält den aktuellen Schritt, das bearbeitete Ticket oder ein Teilergebnis. Es sollte verschwinden, wenn die Aufgabe endet. AMEM.WORK.SET akzeptiert aus genau diesem Grund eine Time-to-live.
Episodisches Gedächtnis
Episodisches Gedächtnis ist ein reines Anhänge-Protokoll von Ereignissen mit Zeitstempel, etwa einer ausgeführten Aktion, einer gemachten Beobachtung oder einer getroffenen Entscheidung. Es lässt einen Agenten, oder einen Menschen, der ihn überprüft, fragen, was wann geschehen ist. AMEM.EPIS.LOG schreibt ein Ereignis, und AMEM.EPIS.QUERY liest sie nach Typ und Zeitraum wieder aus.
KI-Agentengedächtnis in der Praxis
In der Praxis kommt es auf zwei Dinge an. Wie Sie ins Gedächtnis schreiben, und was Sie in jeder Runde zurücklesen.
Gedächtnis mit Befehlen speichern
Hier ist ein Support-Agent, der ein Gespräch bearbeitet. Der fiktive Richtlinientext und die Vektoren mit drei Zahlen dienen nur der Veranschaulichung. Ein echtes Embedding-Modell erzeugt Vektoren mit 768 oder 1.536 Zahlen, und Sie legen den Namensraum mit dieser Dimension an.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
In jeder Runde liest der Agent das aktuelle Fenster und ruft die wenigen Fakten ab, die zur Frage passen. Er prüft seine Arbeitsnotiz und baut den Prompt aus diesen Teilen. Nachdem er gehandelt hat, protokolliert er das Ereignis. Nichts in dieser Schleife braucht den ganzen Verlauf.
Das Gedächtnis in jeder Runde lesen
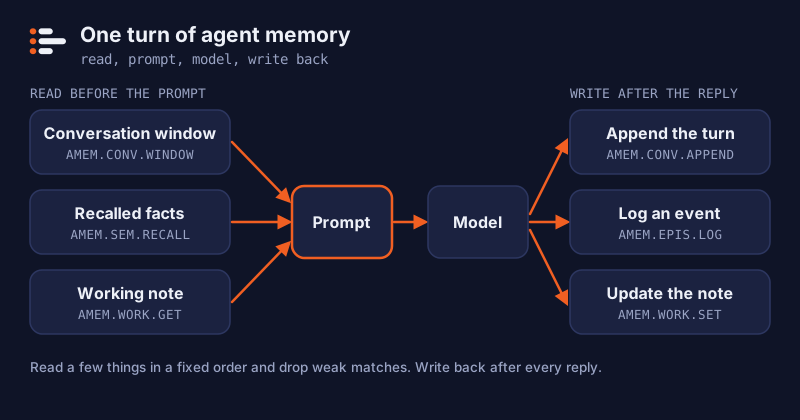
Das Speichern ist die leichte Hälfte. Die Kunst liegt darin zu entscheiden, was zurückgelesen wird, denn alles, was Sie lesen, landet im Prompt und kostet Eingabe-Token. Eine vernünftige Schleife liest eine Handvoll Dinge in fester Reihenfolge. Zuerst kommen die letzten Runden, dann die wenigen Fakten, die zur Frage passen, dann der Zustand der Aufgabe. Hier ist sie mit dem offiziellen Python-Client, mit Ihrer eigenen Embedding-Funktion und Ihrer eigenen Prompt-Vorlage.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # an Ihren eigenen Daten abstimmen

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # einmal anlegen, vor dem ersten Append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # Ihre Prompt-Vorlage

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
Die Ähnlichkeitsgrenze stellen Sie selbst ein. Ein Wert, der zu einem Embedding-Modell und einem Satz von Fakten passt, ist für einen anderen falsch. Prüfen Sie den Recall daher an Fragen, deren Antworten Sie kennen. Schwache Treffer auszusortieren ist wichtiger, als es scheint, denn ein schlechter Fakt im Prompt ist schlimmer als gar keiner.
Die stabilen Teile dieses Prompts, etwa die Systemanweisungen, sind auch der Teil, den das Prompt-Caching des Anbieters verbilligt. Setzen Sie das gelesene Gedächtnis ans Ende, hinter den stabilen Text, damit seine Änderung diesen Cache nicht ungültig macht.
Zusammenfassungen statt immer längerer Fenster
Ein Fenster verwirft alte Runden vollständig. Das ist für Smalltalk in Ordnung und für eine lange Aufgabe schlecht, bei der Runde 3 in Runde 300 noch wichtig sein kann. Die übliche Antwort ist eine fortlaufende Zusammenfassung. Nach jedem Abschnitt des Gesprächs schreibt der Agent, oder ein günstigeres Modell, auf, was gelernt wurde, und die Zusammenfassung ersetzt im Prompt die alten Runden.
HotKV führt eine Zusammenfassung pro Agent mit AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND und AMEM.SUMMARY.GET. SET ersetzt den Text, und APPEND fügt eine Zeile hinzu. Jede Aktualisierung erhöht eine Versionsnummer, sodass eine andere Komponente günstig erkennen kann, dass sich die Zusammenfassung geändert hat und wann.
Eine Zusammenfassung ist verlustbehaftet, und das Zusammenfassen einer Zusammenfassung verliert jedes Mal mehr. Halten Sie exakte Werte wie Kennungen, Beträge und Daten aus dem Fließtext heraus und im Arbeitsgedächtnis oder in semantischen Fakten, wo sie erhalten bleiben. Nutzen Sie die Zusammenfassung für die Gestalt der Arbeit, etwa Präferenzen, getroffene Entscheidungen und das, was noch aussteht.
Designregeln und Aufbewahrung
Gedächtnis wächst unbegrenzt, wenn Sie es nicht stoppen. Legen Sie die Grenzen daher vor dem ersten Schreibvorgang fest.
Regeln, die das Gedächtnis nützlich halten
- Alles begrenzen. Setzen Sie ein
WINDOWbei Konversationen und eineTTLbei Sitzungen und Arbeitswerten. Bei Konversationen, Arbeitswerten und Fakten hält HotKV den Ablaufzeitpunkt für die Append-only-Datei und die Replikate fest, sodass ein abgelaufener Eintrag nicht zurückkehrt, wenn die Datei nach einem Neustart abgespielt wird. - Fakten speichern, keine Transkripte. Fassen Sie zusammen, bevor Sie ins semantische Gedächtnis schreiben. Ein Fakt lässt sich leichter abrufen als eine Seite Dialog.
- Agenten voneinander trennen. Verwenden Sie pro Agent und pro Mandant eine eigene Kennung oder einen eigenen Namensraum, damit das Gedächtnis eines Kunden nie für einen anderen abgerufen wird.
- Wenige abrufen, nicht viele. Nehmen Sie die besten drei bis fünf Treffer, und sortieren Sie schwache nach Ähnlichkeitswert aus, bevor sie in den Prompt gelangen.
- Geheimnisse draußen lassen. Das Gedächtnis wird in Prompts zurückgelesen, speichern Sie also nie Passwörter, Schlüssel oder Daten, die Sie dem Modell nicht zeigen würden.
Wie lange jede Art aufbewahrt wird
Diese Lebensdauern sind unsere Vorschläge, keine Standardwerte. Wählen Sie Ihre danach aus, wie schnell sich die zugrunde liegenden Fakten ändern und was Sie aufbewahren dürfen.
| Gedächtnisart | Vorgeschlagene Lebensdauer | Steuerung in HotKV |
|---|---|---|
| Konversation | Die Sitzung oder ein fester Zeitraum wie ein Tag | WINDOW und TTL bei AMEM.CONV.CREATE |
| Arbeit | Die Aufgabe, danach gelöscht | TTL bei AMEM.WORK.SET und AMEM.WORK.CLEAR |
| Semantisch | Bis der Fakt nicht mehr stimmt | TTL bei AMEM.SEM.STORE und AMEM.SEM.FORGET |
| Episodisch | So lange, wie Ihre Audit- oder Support-Anforderungen es verlangen | AMEM.EPIS.QUERY nach Zeitraum und AMEM.EPIS.CLEAR (Ereignisse haben keine Time-to-live) |
Aufbewahrung ist auch eine Frage des Datenschutzes. Enthält das Gedächtnis irgendetwas über eine Person, ist die gewählte Lebensdauer Teil dessen, was Sie ihr versprechen. Schreiben Sie sie daher auf.
Wie Agentengedächtnis scheitert
Die meisten Gedächtnisfehler sind schleichend. Der Agent arbeitet eine Woche lang gut und wird dann schlechter. Gegen diese Fehlerbilder sollten Sie planen.
Häufige Fehlerbilder
- Veraltete Fakten. Ein Fakt, der im März stimmte, wird im Oktober abgerufen. Geben Sie Fakten eine Time-to-live, oder speichern Sie sie unter einem Schlüssel pro Entität, damit der neue Wert den alten überschreibt.
- Widersprüche. Zwei gespeicherte Fakten widersprechen sich, und der Agent wählt zufällig einen. Bevorzugen Sie einen Fakt pro Schlüssel, statt neue Notizen neben alte anzuhängen.
- Zu viel Recall. Zu viele Treffer füllen den Prompt mit nur lose verwandtem Text. Rufen Sie wenige ab, und sortieren Sie schwache Treffer aus.
- Lecks zwischen Nutzern. Das Gedächtnis eines Kunden wird für einen anderen abgerufen. Verwenden Sie für jeden Mandanten getrennte Kennungen oder Namensräume, im Code vor jedem Lesen geprüft.
- Unbegrenztes Wachstum. Nichts läuft je ab, daher werden Abfragen langsamer und die Kosten schleichen nach oben. Jede Art braucht eine Lebensdauer. Wo HotKV keine Time-to-live hat, wie beim episodischen Protokoll, planen Sie selbst ein Löschen oder einen Export ein.
- Zusammenfassungsdrift. Die Zusammenfassung einer Zusammenfassung passt allmählich nicht mehr zu dem, was geschehen ist. Behalten Sie das Ereignisprotokoll als Quelle der Wahrheit, und erzeugen Sie Zusammenfassungen daraus neu.
Gespeicherten Text als nicht vertrauenswürdig behandeln
Der letzte Punkt verdient mehr Aufmerksamkeit. Alles, was ein Agent ins Gedächtnis schreibt, kann später in einen Prompt gelesen werden. Das schließt Text ein, der von einer Webseite, einer E-Mail oder einem Nutzer stammt. Das ist die indirekte Form der Prompt-Injection, die OWASP als LLM01 führt. Speichern Sie die Quelle mit jedem Fakt. Vertrauen Sie Gedächtnis, das aus externen Inhalten geschrieben wurde, weniger, und lassen Sie eine abgerufene Notiz nie Ihren Systemprompt überstimmen.
Was wir gemessen haben und was nicht
Die veröffentlichten Benchmarks von HotKV decken den Befehlsdurchsatz, die Vektorsuche und die Token-Einsparung durch Antwort-Caching ab. Für das Agentengedächtnis gibt es noch keinen eigenen Benchmark. Wir machen keine Aussage zu seiner Latenz oder dazu, wie stark es die Qualität eines Agenten verbessert. Was wir sagen können, ist architektonisch. Die vier Speicher laufen im selben Prozess wie der Cache und der Vektorindex. Eine Gedächtnisabfrage ist ein Aufruf an ein System, das Sie ohnehin betreiben.
Der Benchmark zur Token-Einsparung und der Vergleich von Prompt-Caching und semantischem Caching zeigen die gemessene Seite. Der Anwendungsfall Agentengedächtnis zeigt die Befehle in einem vollständigen Szenario.
Agentengedächtnis aus Claude Code oder Cursor nutzen
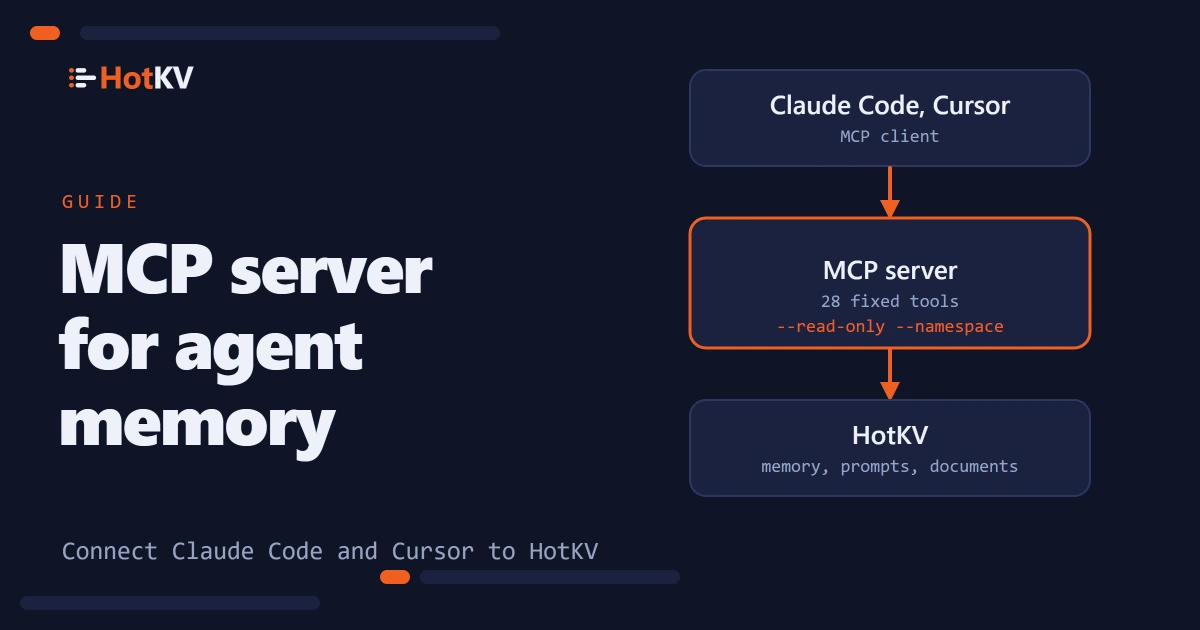
Ein Assistent, der das Model Context Protocol unterstützt, kann einen Teil dieses Gedächtnisses ohne eigenen Code nutzen. Der quelloffene Server hotkv-mcp stellt Konversationsgedächtnis, Arbeitsnotizen, ein Ereignisprotokoll und eine fortlaufende Zusammenfassung als Werkzeuge bereit. Er hat einen Nur-Lese-Modus und einen Namensraum, der den Agenten eingrenzt. Das semantische Gedächtnis stellt er nicht bereit, und mit seinen Werkzeugen lassen sich weder ein Fenster noch eine Time-to-live setzen. Nutzen Sie dafür die Client-Bibliothek. Der nächste Artikel, ein MCP-Server für Agentengedächtnis, zeigt, wie Sie ihn verbinden und was seine Schutzmaßnahmen abdecken.
Häufig gestellte Fragen
Was ist KI-Agentengedächtnis?
KI-Agentengedächtnis ist die Speicher- und Abrufschicht, mit der ein Agent Informationen über Schritte und Sitzungen hinweg behält. Meist kombiniert sie ein aktuelles Gesprächsfenster, Langzeitfakten, die über ihre Bedeutung gefunden werden, einen Notizblock für die aktuelle Aufgabe und ein Ereignisprotokoll.
Was ist der Unterschied zwischen Kurzzeit- und Langzeitgedächtnis bei Agenten?
Das Kurzzeitgedächtnis hält, was gerade geschieht, etwa die letzten Runden und den Aufgabenzustand, und ist begrenzt und vorübergehend. Das Langzeitgedächtnis hält Wissen, das eine Sitzung überdauern soll, etwa Fakten, Präferenzen und vergangene Ereignisse, und wird bei Bedarf durchsucht.
Was ist eine fortlaufende Zusammenfassung im Agentengedächtnis?
Eine fortlaufende Zusammenfassung ist eine kurze laufende Beschreibung dessen, was ein Agent bisher gelernt oder entschieden hat, die mit der Arbeit aktualisiert wird. Sie ersetzt alte Runden im Prompt, damit dieser nicht immer weiter wächst. HotKV speichert eine pro Agent und erhöht bei jeder Aktualisierung eine Versionsnummer.
Brauche ich für Agentengedächtnis eine Vektordatenbank?
Nur für das semantische Gedächtnis, in dem Fakten über ihre Bedeutung gefunden werden. Gesprächsfenster, Arbeitszustand und Ereignisprotokolle brauchen keine Vektoren. HotKV hält alle vier in einer Engine, der Vektorindex und die anderen Speicher sind also keine getrennten Systeme.
Wie lange sollte Agentengedächtnis aufbewahrt werden?
Das hängt von der Art ab. Das Arbeitsgedächtnis sollte ablaufen, wenn die Aufgabe endet, Konversationen nach der Sitzung oder einem festgelegten Zeitraum und episodische Protokolle so lange, wie Ihre Audit-Anforderungen es verlangen. Fakten im semantischen Gedächtnis sollten überprüft und entfernt werden, wenn sie nicht mehr stimmen.
Kann Agentengedächtnis angegriffen werden?
Ja. Text, der ins Gedächtnis geschrieben wird, wird später in Prompts gelesen, sodass eine vergiftete Notiz den Agenten lenken kann. Halten Sie fest, woher jeder Fakt stammt, vertrauen Sie externen Inhalten weniger, und stellen Sie abgerufenes Gedächtnis in der Autorität unter Ihren Systemprompt.
Speichert HotKV Agentengedächtnis im RAM?
HotKV ist eine In-Memory-Engine, Lesezugriffe werden also aus dem Arbeitsspeicher bedient. Schreibvorgänge in die vier Speicher werden laut Produktdokumentation für die Append-only-Datei und für Replikate festgehalten, wobei die Ablaufzeiten mitgeführt werden.

Diskutieren Sie mit
Kommentare
Fragen zur Methode? Ein anderes Ergebnis auf Ihrer Hardware? Teilen Sie mit, was Sie herausgefunden haben. Kommentare werden vor der Veröffentlichung geprüft.