
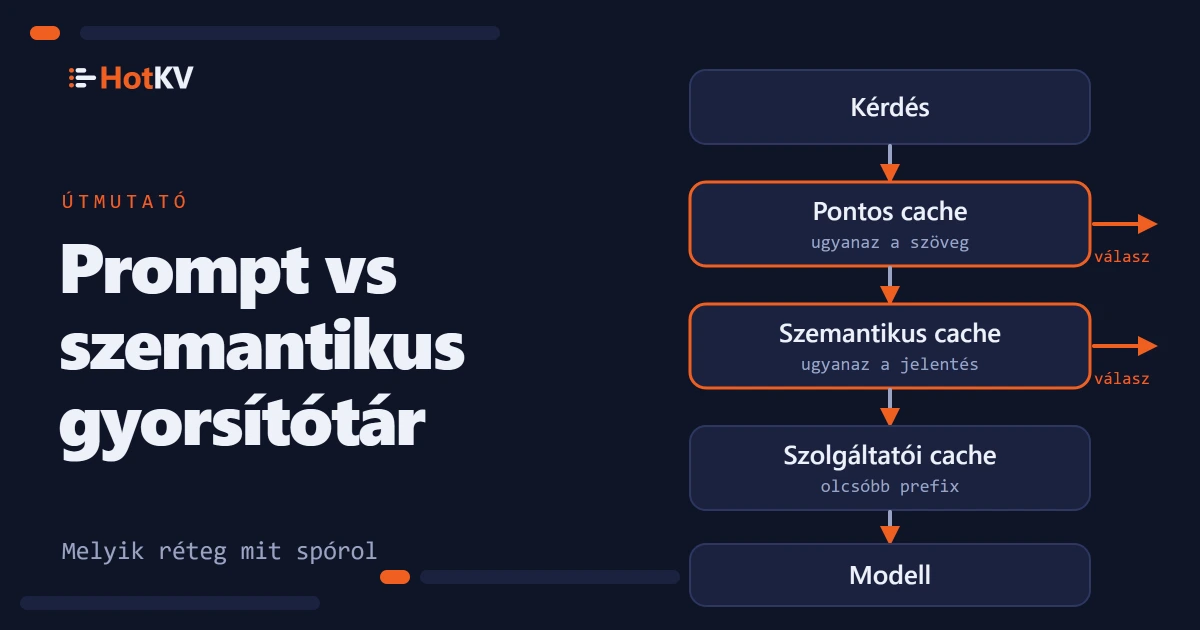
Két különböző dolgot árulnak nyelvi modellek gyorsítótárazásaként, és a csapatok rendszeresen az egyiket veszik meg, a másikat várva. A prompt-gyorsítótárazás szolgáltatói funkció, amely olcsóbbá teszi az ismétlődő promptelőtag olvasását. A szemantikus gyorsítótárazás egy Ön által futtatott réteg, amely a memóriából válaszol egy kérdésre, így a modellt egyáltalán nem hívják. A számla két különböző felét oldják meg, és együtt működnek a legjobban.
Röviden. A prompt-gyorsítótárazás kedvezményt ad a prompt ismétlődő elejére, például egy hosszú rendszerpromptra, de a modell ettől még lefut, és minden kimeneti tokenért továbbra is fizet. A pontos és a szemantikus gyorsítótárazás teljesen kiváltja a hívást, ha egy kérdésre már válaszoltak. A 3000 kérésből álló benchmarkunkban, a szolgáltató prompt-gyorsítótárazásával már bekapcsolva, a HotKV elé kapcsolása nagyjából 70%-kal csökkentette a modellhívásokat, a tokeneket és a költséget, mert a kimeneti tokenek még így is az alapköltség 73-92%-át tették ki.
Hogyan működik a prompt-gyorsítótárazás
A prompt-gyorsítótárazás a modellszolgáltatónál él. Megjelöli a kérés stabil elejét, általában az eszközöket és a rendszerpromptot, a szolgáltató pedig rövid ideig tárolja a feldolgozott formáját. A következő kérés, amely azonos szöveggel kezdődik, erre a részre csökkentett áron számlázódik. Az Anthropic változatát ismertetjük, mert azt mértük. Az alábbi részletek a prompt-gyorsítótárazási dokumentációjából származnak, 2026. október 18-án ellenőrizve.
Mi kerül a gyorsítótárba
A találathoz pontos egyezés kell. Minden blokknak a cache_control jelzővel megjelölt blokkig, azt is beleértve, azonosnak kell lennie, az eszközök, a rendszerprompt, majd az üzenetek sorrendjében. Ha a prompt elején egyetlen karaktert megváltoztat, minden utána jövő tévesztés. Maga a kérdés van a végén, így sosem része a gyorsítótárazott előtagnak.
A minimális hossz alatti promptokat nem gyorsítótárazzák, és hibát sem adnak vissza. Az általunk használt jelenlegi Claude modelleknél, a Fable 5.1, az Opus 5.5, a Sonnet 5.5 és a Haiku 5.5 esetén a dokumentált minimum 512 token. A gyorsítótár-bejegyzések szervezetenként, a Claude API-n pedig munkaterületenként el vannak különítve.
Mibe kerül
Az alapértelmezett élettartam öt perc, és a bejegyzés minden használata extra díj nélkül frissíti. Egy órás élettartam is elérhető. Egy bejegyzés írása öt percre az alap bemeneti ár 1,25-szeresébe, egy órára 2-szeresébe kerül. Olvasása a legtöbb modellen az alap bemeneti ár 0,1-szeresébe, az Opus 5.5-ön és a Sonnet 5.5-ön 0,05-szeresébe, a Fable 5.1-en pedig 0,025-szeresébe kerül, az árazási oldal szerint. Ezek a szorzók változnak, ezért számolás előtt olvassa el az aktuális oldalt.
Amit a prompt-gyorsítótárazás nem tud kiváltani
A prompt-gyorsítótárazás az előtag olvasására ad kedvezményt. A modellt nem hagyja ki. Minden kérés továbbra is új választ állít elő, még mindig várnia kell rá, és minden kimeneti token a teljes kimeneti áron számlázódik.
A benchmarkunk megmutatja, mennyire számít ez. 3000 ügyfélszolgálati kérdést küldtünk négy Claude modell mindegyikének, egy 2200 tokenes szabályzattal rendszerpromptként és bekapcsolt szolgáltatói gyorsítótárazással. A számolt tokenek 90-93%-a e szabályzat gyorsítótár-olvasása volt. A kimenet a tokeneknek csak 6-9%-át tette ki, mégis az alapköltség 73-92%-a volt. Az előtag már olcsó volt, így a megmaradt költés a válaszokban ült.
Ez az a rés, amelyet a többi réteg tölt ki. A teljes módszer és az eredmények a tokenmegtakarítási benchmarkban találhatók.
Pontos és szemantikus válasz-gyorsítótárazás
Két réteg válaszol egy kérésre a memóriából. Abban különböznek, hogyan döntik el, hogy egy új kérés egyezik egy régivel.
Pontos válasz-gyorsítótárazás
A pontos gyorsítótár a végső választ egy olyan kulcs alatt tárolja, amelyet mindenből képeznek, ami alakítja. Normál esetben ez a modell, a prompt verziója és a normalizált kérdés. Amikor ugyanaz a kérés újra megérkezik, a tárolt válasz jön vissza, és a modellt nem hívják. Nincs hasonlósági pontszám, és nincs kockázata, hogy egy másik kérdésnek szánt választ adjon vissza.
A futtatásunkban a pontos gyorsítótár a kérések nagyjából 39%-ára válaszolt. Egy ismételt kérdés körülbelül 0,05 ms mediánnal jött vissza. Ezt Python-klienssel, loopbacken, ugyanazon a gépen mértük, így helyi, nem hálózati értékként olvassa. A benchmark ehhez a réteghez sima GET és SET parancsot használt. A HotKV Enterprise dedikált, pontos egyezésű prompt-gyorsítótárat is tartalmaz, PCACHE.*, névterenkénti korlátokkal és költségkövetéssel.
A pontos gyorsítótár vak a megfogalmazásra. A „How do I reset my password?” és az „I forgot my password” két különböző kulcs.
Szemantikus gyorsítótárazás
A szemantikus gyorsítótár a kérdés jelentésére keres. A kérdésből embeddinget készít, megkeresi a legközelebbi tárolt kérdést, és visszaadja a válaszát, ha a koszinusz-hasonlóság átlép egy küszöböt. A HotKV-ban ez a SCACHE.*, ugyanarra a vektorindexre építve, mint a vektorkeresés.
A kéréseink nagyjából 31%-ára így válaszoltak. Egy átfogalmazás körülbelül 130 ms mediánt vett igénybe, ennek szinte egésze az embedding szolgáltatás hívása, így egy szemantikus találat sokkal gyorsabb egy modellhívásnál, de nem azonnali. Szemantikus réteg nélkül a pontos gyorsítótár egyedül legfeljebb 1264 modellhívást igényelt volna 3000-ből, nagyjából 58%-kal kevesebbet. A szemantikus réteg a megtakarítást nagyjából 70%-ra vitte.
Itt él a kockázat is. Egy hasonló kérdés nem mindig ugyanaz a kérdés. Egy második Claude modellel értékeltettük minden szemantikus találatot egy új válasszal szemben. Az alapértelmezett 0,81-es küszöbünknél a gyorsítótárazott válaszok 5,8-10,7 százalékponttal ritkábban feleltek meg a pontos kérdésnek, mint az újak. A Sonnet 5.5-ön a 0,88-as és magasabb küszöbök nem mutattak ilyen hiányt, vékony bizonyítékkal. Azok a kérdések, amelyeket egyetlen döntő részletben eltérőre írtak, 0,81-nél még az esetek 62%-ában, 0,95-nél 10%-ában egyeztek.
Prompt-gyorsítótárazás és szemantikus gyorsítótárazás egymás mellett
| Szolgáltatói prompt-gyorsítótárazás | Pontos válasz-gyorsítótár | Szemantikus gyorsítótár | |
|---|---|---|---|
| Mit vált ki | A bemeneti ár egy részét | A teljes modellhívást | A teljes modellhívást |
| Egyezési szabály | Azonos előtag | Azonos kérés | Hasonló jelentés egy küszöb felett |
| Számlázott kimeneti tokenek | Igen, minden alkalommal | Nem, találatnál | Nem, találatnál |
| Hibás válasz kockázata | Nincs | Nincs azonos kéréseknél | Valós, a küszöbbel hangolható |
| Hol fut | A szolgáltatónál | Az Ön gyorsítótárában | Az Ön gyorsítótárában, plusz egy embedding-hívás |
| A kérések aránya a futtatásunkban | Mindig bekapcsolva | Nagyjából 39% | Nagyjából 31% |
A szolgáltatói prompt-gyorsítótárazás és a válasz-gyorsítótárazás nem alternatívák. Az egyik a még intézett hívások árát csökkenti, a másik azt, hogy hány hívást intéz.
Mit tesz a gyorsítótárazás a késleltetéssel
A modell kihagyása a válaszok érkezésének sebességét is megváltoztatja, nem csak a költséget. A futtatásunkban a teljes válaszig tartó medián idő a Fable 5.1-en 2,7 másodpercről 127 ms-ra, az Opus 5.5-ön 2,9 másodpercről 126 ms-ra, a Sonnet 5.5-ön 1,8 másodpercről 128 ms-ra, a Haiku 5.5-ön pedig 1,4 másodpercről 125 ms-ra csökkent. Ez mediánban 11-23-szor gyorsabb.
A lassú vég alig mozdult. A kérések nagyjából 30%-a még elérte a modellt, és a 99. percentilis a Fable 5.1-en HotKV-val körülbelül 6,4 másodperc volt, nélküle 6,6 másodperc. A gyorsítótár megszünteti a várakozást azoknál a kéréseknél, amelyekre válaszol, és semmit nem tesz azoknál, amelyeket elvét. Ha a panasza a lassú legrosszabb eset, nem a lassú tipikus eset, a gyorsítótárazás önmagában nem fogja megoldani.
Ezek a teljes válaszig tartó idők, mert a hívások nem voltak streamelve. Egy streamelt válasz hamarabb mutatja az első szavait. A különbség egy csevegőablakban kisebb, mint ezekben a számokban.
Réteg választása a forgalmához
A megfelelő réteg attól függ, hogyan ismétlődnek a kérései, és ezt még azelőtt megmérheti, hogy bármit építene.
Illessze a réteget a forgalomhoz
Illessze a réteget ahhoz, hogyan ismétlődnek a kérései.
- Hosszú, stabil rendszerprompt vagy eszközlista: használjon szolgáltatói prompt-gyorsítótárazást. Keveset kerül bekapcsolni, és egyetlen választ sem változtat meg.
- Ugyanaz a kérdés ugyanazokkal a szavakkal, például egy gomb, egy sablon vagy egy újrapróbálkozás: használjon pontos válasz-gyorsítótárat. Biztonságos és gyors.
- Támogatási, keresési és GYIK-forgalom, ahol az emberek ugyanazt kérdezik más szavakkal: adjon hozzá szemantikus gyorsítótárat, állítsa magasra a küszöböt, és a megbízás előtt ellenőrizze a válaszminőséget a saját kérdésein.
- Olyan válaszok, amelyek a felhasználótól, az időtől vagy élő adatoktól függnek: egyiket se gyorsítótárazza, vagy a gyorsítótárat azokra a tényekre kulcsolja, amelyek megváltoztatják a választ.
A megtakarítás az ismétlődést követi. Amikor minden szándékot egyformán valószínűvé tettünk ferde eloszlás helyett, a költség 56%-kal csökkent az újrafuttatott két modellen, és 3000 mind különböző kérdéssel 38%-kal. Az olyan munkaterhelés, amelyben nincsenek ismétlődő vagy hasonló kérdések, semmit nem takarít meg.
Előbb mérje meg a saját ismétlődését
Mielőtt bármit építene, derítse ki, a forgalma mekkora része ismétlődik. A szám dönti el, hogy megéri-e pontos gyorsítótárat tartani. Tíz percet vesz igénybe a már naplózott kérdésekkel. Normalizálja minden kérdést úgy, ahogyan a gyorsítótár kulcsa fogja, számolja meg a különbözőket, és nézze meg, a forgalom mekkora része volt ismétlés.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
A repeat_share azon kérések hányada, amelyekre egy pontos gyorsítótár válaszolt volna, miután minden kérdést először látott. A teszthalmazunkban 3000 kérés között 1264 különböző kérdés volt, így az érték nagyjából 58% volt. Ha az Öné 5% körül jön ki, egy pontos gyorsítótár keveset fog tenni, és csak egy szemantikus réteg segíthet.
Két óvatosság érvényes. A gyorsítótár üresen indul, így a korai kérések mindig elérik a modellt. A futtatásunkban az első ezer kérés nagyjából 52%-át, az utolsó ezer nagyjából 81%-át a gyorsítótárból szolgálták ki. És a múlt havi forgalom naplója a múlt hónapról mond el valamit. Ha olyan funkciót indít, amely megváltoztatja, mit kérdeznek az emberek, kezelje az értéket durva útmutatóként.
A rétegek összeillesztése
Egy kérésnek a legolcsóbb és legbiztonságosabb rétegtől a legdrágábbig kell áthaladnia a rétegeken, és látnia kell, mit takarított meg az egyes.
A keresési sorrend
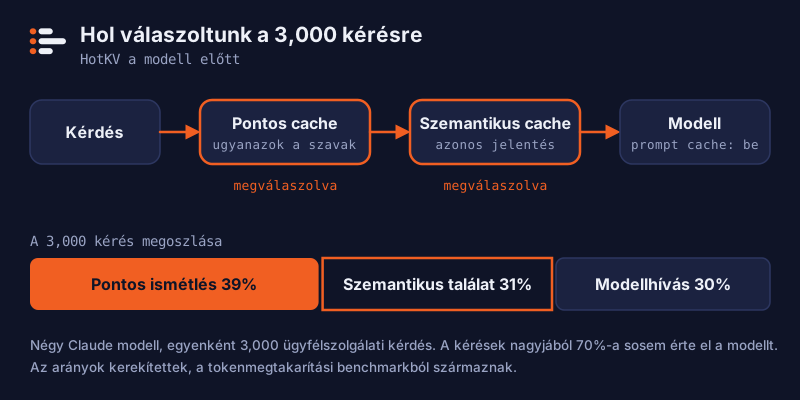
A sorrend számít. Előbb a legolcsóbb és legbiztonságosabb réteget ellenőrizze, és a modellt csak akkor hívja, ha minden téved. Ez a vázlat egy redis-py stílusú klienst feltételez decode_responses=True beállítással, előre létrehozott két névteret, valamint a saját embed és llm függvényeit.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # ugyanazok a szavak

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # ugyanaz a jelentés

    reply = llm.complete(question)                   # itt érvényesül a szolgáltatói prompt-gyorsítótárazás
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Hozza létre a névtereket egyszer a PCACHE.CREATE answers_exact és a SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90 paranccsal, az embedding modellje dimenziójával. Az AI-parancskészlet a HotKV Cloud Performance és Scale példányaihoz jár, az AI oldal pedig felsorolja, mit csinál az egyes motor. Az Árak oldal megmutatja, melyik csomag mit tartalmaz.
Pontszámítás élesben
Az a gyorsítótár, amelyet nem lát, olyan gyorsítótár, amelyben nem bízhat. A HotKV névterenként vezeti a találatok és tévesztések számát. Ha az eredeti hívás tokenhasználatát minden bejegyzéssel tárolja, hozzá tudja rendelni azokat a tokeneket és költséget is, amelyeket minden későbbi találat elkerült. A PCACHE.STATS és SCACHE.STATS válaszai ekkor olyan mezőket tartalmaznak, mint a usage_saved_requests, a usage_saved_input_tokens és a usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Cserélje a <model> részt a modellje azonosítójára. Az INPUT a nem gyorsítótárazott prompttokeneket, a CACHEREAD pedig azokat a tokeneket számolja, amelyeket a szolgáltató a saját gyorsítótárából szolgált ki, így a kettő nem fedi egymást. A modellnek szerepelnie kell a HotKV árlistájában, hogy a költségmező jelentsen valamit. Az LLMSTATS.PRICE LIST megmutatja, mely modellek ismertek, az LLMSTATS.PRICE SET pedig hozzáadja a sajátját. Az ár nélküli modell tokenjei továbbra is számolva vannak, de a költségét nullaként rögzíti, egy külön számláló pedig megmutatja, hogy a kérések árazatlanok maradtak.
A gyorsítótárak csökkentik a költést, a keret pedig korlátozza, ami megmarad. Az LLMBUDGET.SET token- és dollárkorlátot definiál egy időablakra. Az LLMBUDGET.CONSUME a modellhívás előtt kerül ellenőrzésre, így egy elszabadult ügynököt még azelőtt megállítanak, hogy elköltené a pénzt, nem utána. Az LLMSTATS.RECORD bérlőnkénti összesítéseket vezet, amelyek értik a szolgáltató gyorsítótár-olvasási és -írási tokenjeit. Mind a három ugyanazt az árlistát használja, ha megadja a modell nevét, így egy megtakarítás, egy keret és egy irányítópult-érték nem mondhat ellent egymásnak.
Hibák, amelyek miatt a gyorsítótár rossz válaszokat ad
A legtöbb rossz gyorsítótár-találat egy olyan kulcsból ered, amelyből valami hiányzik. Tegye a modellt, a prompt verzióját és bármely eszköz- vagy szabályzatverziót a pontos kulcsba, hogy egy promptváltozás ne szolgáljon ki a régihez írt válaszokat.
Adjon a bejegyzéseknek olyan élettartamot, amely illeszkedik ahhoz, milyen gyorsan változnak a tényei. Tartsa külön a bérlőket külön névterekkel, hogy az egyik ügyfél válaszát soha ne kínálják fel egy másiknak. Soha ne gyorsítótárazzon olyan választ, amely személyes adatot tartalmaz, hacsak a kulcs nem tartalmazza, kinek az adata.
Végül a saját forgalmán mérjen. A mi számaink egy nyilvános, rövid banki kérdésekből álló adathalmazból, egy kitalált szabályzatból és feltételenként egy futtatásból származnak, és nem ígéretek az Ön munkaterhelésére.
Gyakran ismételt kérdések
Mi az a prompt-gyorsítótárazás?
A prompt-gyorsítótárazás modellszolgáltatói funkció, amely rövid ideig tárolja a prompt feldolgozott elejét. Egy későbbi kérés, amely pontosan ugyanazzal a szöveggel kezdődik, erre a részre alacsonyabb áron számlázódik. A modell ettől még lefut, és új választ állít elő, így a kimeneti tokenekért továbbra is fizet.
Ugyanaz a prompt-gyorsítótárazás, mint a szemantikus gyorsítótárazás?
Nem. A prompt-gyorsítótárazás egy ismétlődő promptelőtagot használ újra, és a modellt még hívja. A szemantikus gyorsítótárazás egy hasonló jelentésű kérdésre adott tárolt választ ad vissza, és kihagyja a modellhívást. Különböző költségeket céloznak, és használhatók együtt.
Csökkenti a prompt-gyorsítótárazás a kimeneti tokenek költségét?
Nem. Csak a gyorsítótárazott előtag olvasásának árát csökkenti. A benchmarkunkban a kimenet a tokenek 6-9%-át, de az alapköltség 73-92%-át tette ki, a prompt-gyorsítótárazással már bekapcsolva, ezért a teljes válaszok gyorsítótárazása sokkal többet spórolt.
Meddig tart az Anthropic prompt-gyorsítótára?
Az alapértelmezett öt perc, a bejegyzés minden használatakor frissítve. Egy egyórás lehetőség is elérhető, magasabb írási áron. Nézze meg az aktuális dokumentációt, mert a korlátok és az árak változnak.
Használhatom együtt a prompt-gyorsítótárazást és a szemantikus gyorsítótárazást?
Igen, és a benchmarkunk pontosan ezt tette. A szolgáltatói prompt-gyorsítótárazás mindkét futtatásban bekapcsolva maradt, a szemantikus és a pontos réteg pedig a modell előtt ült. A gyorsítótár-találatok kihagyják a hívást, a tévesztések pedig még profitálnak a kedvezményes előtagból.
Milyen hasonlósági küszöböt használjon egy szemantikus gyorsítótár?
Nincs általános érték. Mi a 0,81-et választottuk egy külön tanítóhalmazon, a Sonnet 5.5-ön pedig a gyorsítótárazott válaszok 0,88-tól felfelé nem mutattak minőségi hiányt az újakhoz képest, vékony bizonyítékkal. Kezdjen magasról, értékelje a gyorsítótárazott válaszokat az újakhoz képest a saját kérdésein, és csak akkor csökkentse a küszöböt, ha a minőség megmarad.
Folytassa a beszélgetést
Hozzászólások
Kérdése van a módszerről? Más eredményt kapott a saját hardverén? Ossza meg, mit talált. A hozzászólások megjelenés előtt ellenőrzésen esnek át.