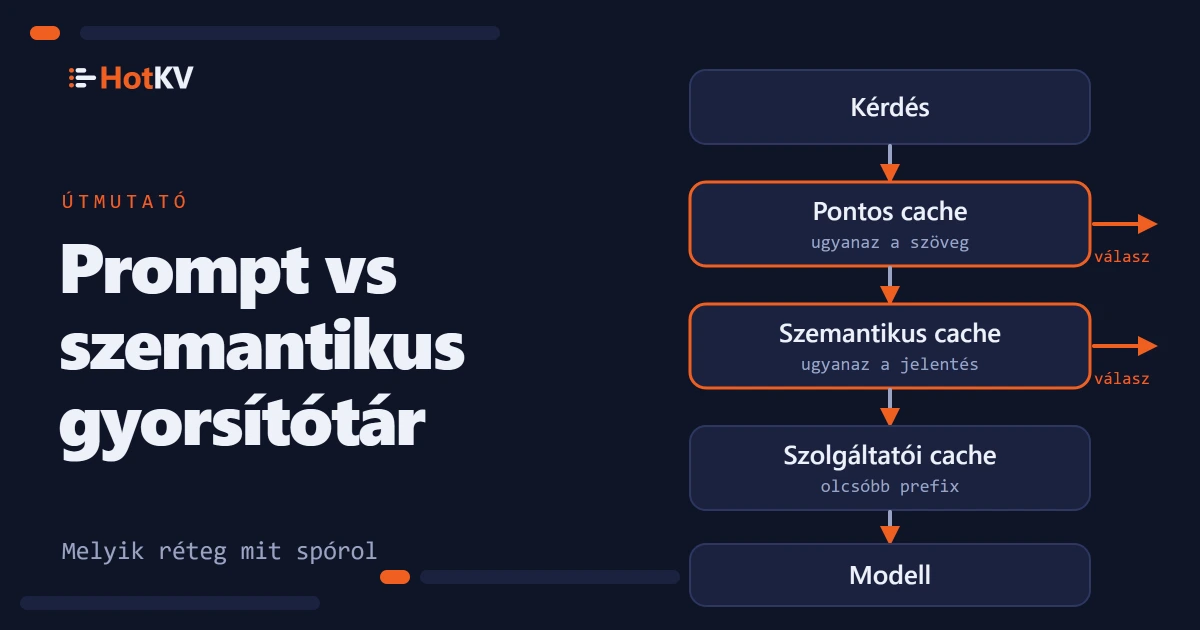
Prompt-gyorsítótárazás vs. szemantikus gyorsítótárazás: mit spórol az egyes
A prompt-gyorsítótárazás olcsóbbá teszi az ismétlődő előtagot, a szemantikus megspórolja a modellhívást. Hogyan működnek, mit mértünk, és mikor melyiket használja.
Címke
Mért API-költségek és tokenmegtakarítások a HotKV-val: árazási feltevések, a munkaterheléstől való függés és az extrapoláció korlátai.
2 cikk itt: Költségoptimalizálás
A prompt-gyorsítótárazás olcsóbbá teszi az ismétlődő előtagot, a szemantikus megspórolja a modellhívást. Hogyan működnek, mit mértünk, és mikor melyiket használja.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Kövesse a kíváncsiságát