
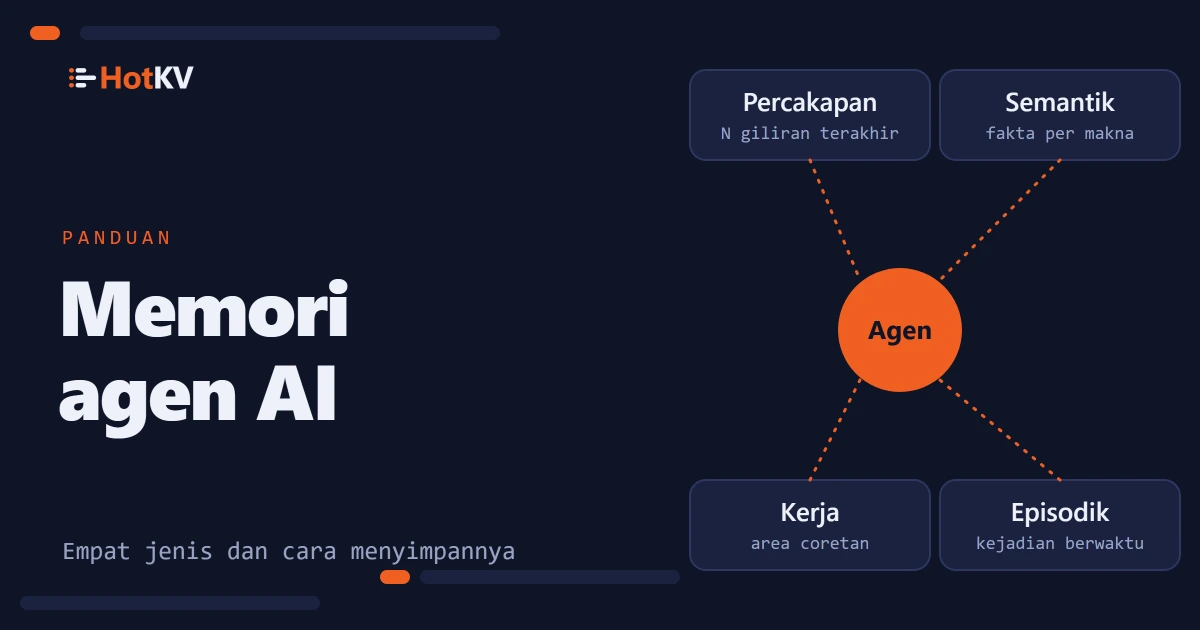
Memori agen AI adalah yang memungkinkan agen membawa sesuatu dari satu langkah, atau satu sesi, ke langkah berikutnya. Model bahasa dengan sendirinya tidak mengingat apa pun di antara panggilan. Apa pun yang tampak diingatnya dimasukkan kembali ke prompt oleh kode Anda. Cara Anda menyimpan dan mengambil bahan itu menentukan apa yang dapat diingat agen, seberapa cepat, dan dengan biaya berapa per giliran.
Singkatnya. Agen membutuhkan empat jenis memori: jendela percakapan yang pendek, fakta jangka panjang yang ditemukan berdasarkan makna, scratchpad untuk tugas yang sedang berjalan, dan log tentang apa yang terjadi. Masing-masing memiliki bentuk, masa hidup, dan cara pencarian yang berbeda, jadi satu tabel memori tidak cocok untuk satu pun dari mereka. HotKV menyimpan keempatnya dalam satu mesin in-memory dengan perintah
AMEM.*. Kami telah mem-benchmark caching dan vector search HotKV, bukan memori agen, jadi artikel ini menjelaskan desainnya dan tidak mengklaim percepatan apa pun.
Mengapa jendela konteks bukan memori
Jendela konteks adalah teks yang Anda kirim bersama setiap permintaan. Ukurannya terbatas, Anda membayar token masukan untuk semua isinya di setiap giliran, dan ia hilang ketika sesi berakhir. Ia juga tidak dapat dicari. Jika agen membutuhkan satu fakta dari tiga minggu lalu, menempelkan seluruh riwayat bukanlah jawaban.
Memori adalah lapisan yang memutuskan apa yang masuk ke jendela berikutnya. Ia menyimpan giliran terbaru dan menemukan beberapa fakta lama yang penting. Ia menyimpan status tugas saat ini dan mencatat apa yang telah dilakukan agen. Para peneliti menggambarkan agen dengan istilah serupa. Kerangka CoALA oleh Sumers, Yao, Narasimhan, dan Griffiths memisahkan memori kerja dari memori episodik, semantik, dan prosedural jangka panjang.
Empat jenis memori agen AI
Empat penyimpanan HotKV mencakup sebagian besar bidang yang sama, disesuaikan dengan apa yang harus dibangun sebuah aplikasi. Memori prosedural, yaitu pengetahuan praktis yang dipegang dalam kode dan prompt agen, biasanya berada di repositori Anda atau registri prompt dan bukan penyimpanan tersendiri.
Memori percakapan
Ini adalah transkrip jangka pendek dari satu sesi. Pesan membawa sebuah peran (system, user, assistant, atau tool). Pesan berada dalam sliding window yang terbatas, sehingga giliran tertua gugur setelah batas tercapai. Ia menjawab satu pertanyaan. Apa yang dikatakan baru-baru ini? Di HotKV itu adalah AMEM.CONV.CREATE, AMEM.CONV.APPEND, dan AMEM.CONV.WINDOW.
Memori semantik
Memori semantik adalah pengetahuan jangka panjang yang disimpan sebagai fakta dengan vektor embedding. Agen mengingatnya berdasarkan makna, bukan berdasarkan kunci. Ia didukung oleh indeks vektor HNSW, jenis yang sama yang menggerakkan vector search. AMEM.SEM.STORE menyimpan sebuah fakta dan AMEM.SEM.RECALL mengembalikan kecocokan teratas dengan skor kemiripan. Di sinilah dokumen, preferensi pengguna, dan koreksi yang dipelajari berada.
Memori kerja
Memori kerja adalah scratchpad untuk tugas yang sedang berjalan, kumpulan datar kunci dan nilai yang dibatasi pada satu sesi. Ia menyimpan langkah saat ini, tiket yang sedang ditangani, atau hasil parsial. Ia seharusnya hilang ketika tugas berakhir. AMEM.WORK.SET menerima time to live justru karena alasan itu.
Memori episodik
Memori episodik adalah log append-only dari peristiwa bercap waktu, seperti tindakan yang diambil, pengamatan yang dibuat, atau keputusan yang dicapai. Ia memungkinkan agen, atau orang yang meninjaunya, bertanya apa yang terjadi dan kapan. AMEM.EPIS.LOG menulis sebuah peristiwa dan AMEM.EPIS.QUERY membacanya kembali menurut jenis dan rentang waktu.
Memori agen AI dalam praktik
Dua hal yang penting dalam praktik. Cara Anda menulis ke memori, dan apa yang Anda baca kembali pada setiap giliran.
Menyimpan memori dengan perintah
Berikut agen dukungan yang menangani satu percakapan. Teks kebijakan fiktif dan vektor tiga angka hanya untuk ilustrasi. Model embedding sungguhan menghasilkan vektor berisi 768 atau 1.536 angka, dan Anda membuat namespace dengan dimensi itu.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400

AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."

AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600

AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"


AMEM.SEM.CREATE support-kb 3

AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3

AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3

AMEM.CONV.WINDOW session-42 10
Pada setiap giliran agen membaca jendela terbaru dan mengingat beberapa fakta yang cocok dengan pertanyaan. Ia memeriksa catatan kerjanya dan menyusun prompt dari potongan-potongan itu. Setelah bertindak, ia mencatat peristiwanya. Tidak ada dalam loop itu yang membutuhkan seluruh riwayat.
Membaca memori pada setiap giliran
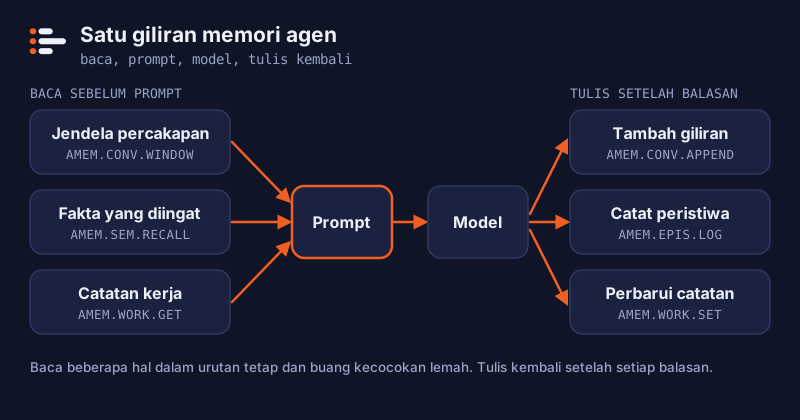
Menyimpan memori adalah separuh yang mudah. Keterampilannya terletak pada memutuskan apa yang dibaca kembali, karena semua yang Anda baca masuk ke prompt dan memakan token masukan. Loop yang masuk akal membaca beberapa hal dalam urutan tetap. Giliran terbaru lebih dulu, lalu beberapa fakta yang cocok dengan pertanyaan, lalu status tugas. Berikut dengan klien Python resmi, dengan fungsi embedding dan template prompt Anda sendiri.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # setel pada data Anda sendiri

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # buat sekali, sebelum append pertama

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # template prompt Anda

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
Batas kemiripan itu Anda yang menyetelnya. Nilai yang cocok untuk satu model embedding dan satu kumpulan fakta akan salah untuk yang lain, jadi periksa recall pada pertanyaan yang jawabannya Anda ketahui. Membuang kecocokan yang lemah lebih penting daripada kelihatannya, karena fakta yang buruk di prompt lebih buruk daripada tanpa fakta.
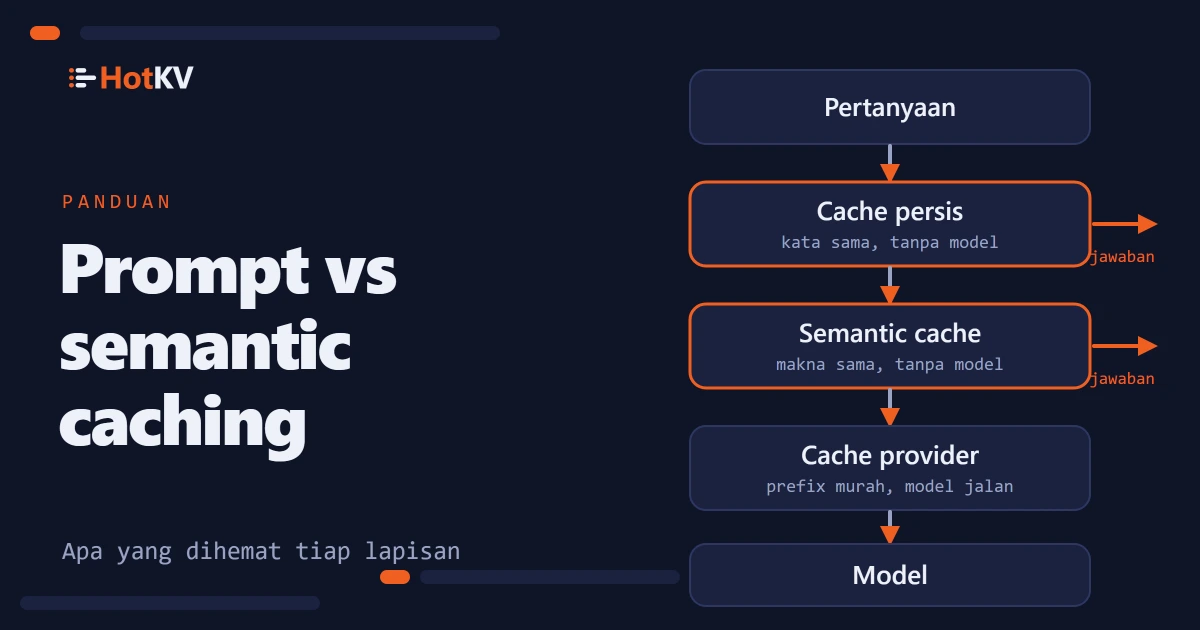
Bagian prompt yang stabil, seperti instruksi sistem, juga merupakan bagian yang dibuat lebih murah oleh prompt caching di sisi penyedia. Taruh memori yang Anda baca di akhir, setelah teks yang stabil, agar perubahannya tidak membatalkan cache itu.
Ringkasan sebagai ganti jendela yang makin panjang
Jendela membuang giliran lama sepenuhnya. Itu tidak masalah untuk obrolan ringan dan buruk untuk tugas panjang, di mana giliran ke-3 mungkin masih penting pada giliran ke-300. Ringkasan bergulir adalah jawaban yang lazim. Setelah setiap rentang percakapan, agen, atau model yang lebih murah, menuliskan apa yang telah dipelajari, dan ringkasan itu menggantikan giliran lama di prompt.
HotKV menyimpan satu ringkasan per agen dengan AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND, dan AMEM.SUMMARY.GET. SET mengganti teksnya dan APPEND menambahkan satu baris. Setiap pembaruan menaikkan nomor versi, sehingga komponen lain dapat mengetahui dengan murah bahwa ringkasan berubah dan kapan.
Ringkasan itu lossy, dan meringkas sebuah ringkasan kehilangan lebih banyak setiap kalinya. Jauhkan nilai persis seperti pengenal, jumlah, dan tanggal dari prosa dan simpan di memori kerja atau fakta semantik, tempat nilai itu bertahan. Gunakan ringkasan untuk bentuk pekerjaan, seperti preferensi, keputusan yang dibuat, dan apa yang tersisa.
Aturan desain dan retensi
Memori tumbuh tanpa batas kecuali Anda menghentikannya, jadi tetapkan batasnya sebelum penulisan pertama.
Aturan yang menjaga memori tetap berguna
- Batasi semuanya. Atur
WINDOWpada percakapan danTTLpada sesi dan nilai kerja. Untuk percakapan, nilai kerja, dan fakta, HotKV mencatat waktu kedaluwarsa untuk append-only file dan replika, sehingga entri yang sudah kedaluwarsa tidak kembali ketika file diputar ulang setelah restart. - Simpan fakta, bukan transkrip. Ringkas sebelum menulis ke memori semantik. Fakta lebih mudah diingat daripada sehalaman dialog.
- Pisahkan agen. Gunakan pengenal atau namespace terpisah per agen dan per tenant, agar memori satu pelanggan tidak pernah diingat untuk pelanggan lain.
- Ingat sedikit, bukan banyak. Ambil tiga hingga lima kecocokan teratas dan buang yang lemah menurut skor kemiripan sebelum masuk ke prompt.
- Jauhkan rahasia. Memori dibaca kembali ke prompt, jadi jangan pernah menyimpan kata sandi, kunci, atau data yang tidak akan Anda tunjukkan kepada model.
Berapa lama menyimpan setiap jenis
Masa hidup ini adalah saran kami, bukan default. Pilih milik Anda dari seberapa cepat fakta yang mendasarinya berubah dan apa yang boleh Anda simpan.
| Jenis memori | Masa hidup yang disarankan | Kontrol di HotKV |
|---|---|---|
| Percakapan | Sesi, atau periode tetap seperti sehari | WINDOW dan TTL pada AMEM.CONV.CREATE |
| Kerja | Tugas, lalu dibersihkan | TTL pada AMEM.WORK.SET, dan AMEM.WORK.CLEAR |
| Semantik | Sampai fakta itu tidak lagi benar | TTL pada AMEM.SEM.STORE, dan AMEM.SEM.FORGET |
| Episodik | Selama kebutuhan audit atau dukungan Anda menghendaki | AMEM.EPIS.QUERY menurut rentang waktu, dan AMEM.EPIS.CLEAR (peristiwa tidak memiliki time to live) |
Retensi juga merupakan persoalan privasi. Jika memori menyimpan apa pun tentang seseorang, masa hidup yang Anda pilih adalah bagian dari apa yang Anda janjikan kepada mereka, jadi tuliskan.
Bagaimana memori agen bisa salah
Kebanyakan bug memori bersifat lambat. Agen bekerja dengan baik selama seminggu lalu mulai memburuk. Inilah kegagalan yang harus dirancang untuk dihindari.
Kegagalan umum
- Fakta basi. Fakta yang benar pada bulan Maret diingat pada bulan Oktober. Beri fakta time to live, atau simpan di bawah satu kunci per entitas agar nilai baru menimpa yang lama.
- Kontradiksi. Dua fakta tersimpan saling bertentangan, dan agen memilih salah satunya secara acak. Pilih satu fakta per kunci daripada menambahkan catatan baru di samping yang lama.
- Recall berlebihan. Terlalu banyak kecocokan memenuhi prompt dengan teks yang hanya berkaitan longgar. Ingat sedikit, dan buang kecocokan yang lemah.
- Kebocoran antarpengguna. Memori satu pelanggan diingat untuk pelanggan lain. Pisahkan pengenal atau namespace untuk setiap tenant, diperiksa di kode sebelum setiap pembacaan.
- Pertumbuhan tak terbatas. Tidak ada yang pernah kedaluwarsa, sehingga pencarian melambat dan biaya merayap naik. Setiap jenis memerlukan masa hidup. Di mana HotKV tidak memiliki time to live, seperti pada log episodik, jadwalkan pembersihan atau ekspor sendiri.
- Penyimpangan ringkasan. Ringkasan dari sebuah ringkasan perlahan berhenti sesuai dengan apa yang terjadi. Jadikan log peristiwa sebagai sumber kebenaran dan buat ulang ringkasan darinya.
Perlakukan teks tersimpan sebagai tidak tepercaya
Poin terakhir layak mendapat perhatian lebih. Apa pun yang ditulis agen ke memori dapat dibaca ke prompt kemudian. Itu mencakup teks yang berasal dari halaman web, email, atau pengguna. Itulah bentuk tidak langsung dari prompt injection yang didaftarkan OWASP sebagai LLM01. Simpan sumber bersama setiap fakta. Percayai memori yang ditulis dari konten luar lebih sedikit, dan jangan pernah biarkan catatan yang diingat mengalahkan system prompt Anda.
Apa yang telah dan belum kami ukur
Benchmark HotKV yang dipublikasikan mencakup throughput perintah, vector search, dan penghematan token dari response caching. Memori agen belum memiliki benchmark sendiri. Kami tidak membuat klaim tentang latensinya atau seberapa besar ia meningkatkan kualitas agen. Yang dapat kami katakan bersifat arsitektural. Keempat penyimpanan berjalan dalam proses yang sama dengan cache dan indeks vektor. Pencarian memori adalah satu panggilan ke sistem yang sudah Anda operasikan.
Benchmark penghematan token dan perbandingan prompt caching dan semantic caching menunjukkan sisi yang terukur. Kasus penggunaan memori agen menunjukkan perintahnya dalam skenario lengkap.
Memakai memori agen dari Claude Code atau Cursor
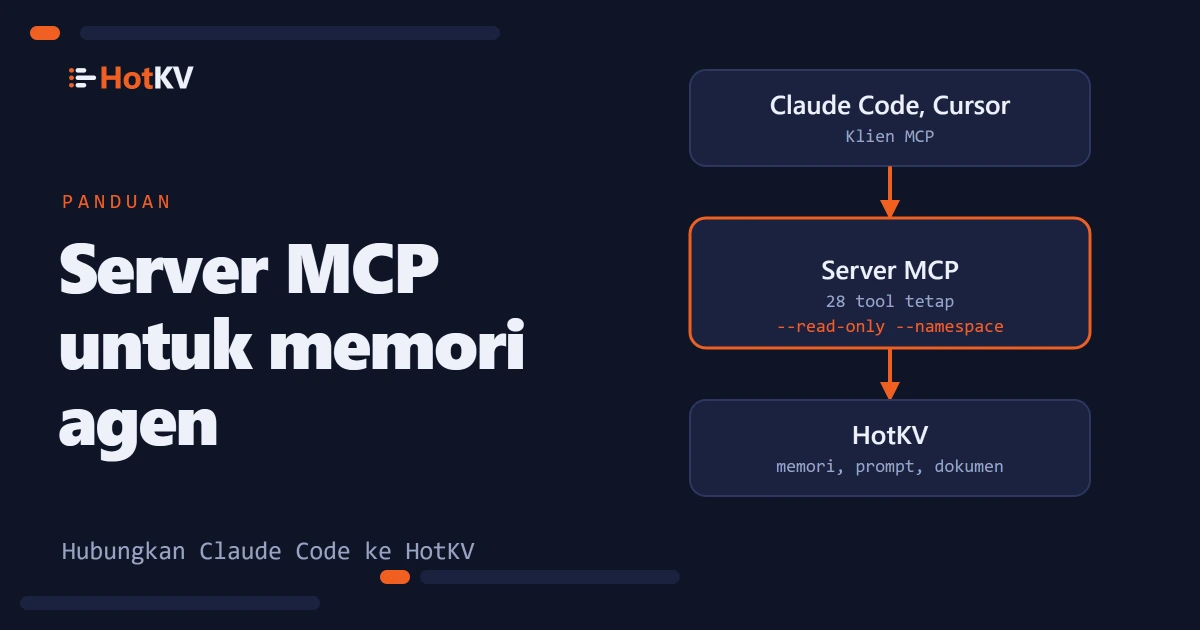
Asisten yang mendukung Model Context Protocol dapat memakai sebagian memori ini tanpa kode khusus. Server open source hotkv-mcp mengekspos memori percakapan, catatan kerja, log peristiwa, dan ringkasan bergulir sebagai tool. Ia memiliki mode baca-saja dan namespace yang membatasi agen. Ia tidak mengekspos memori semantik, dan tool-nya tidak dapat mengatur window atau time to live, jadi gunakan pustaka klien untuk itu. Artikel berikutnya, server MCP untuk memori agen, menunjukkan cara menghubungkannya dan apa yang dicakup pengamannya.
Pertanyaan yang sering diajukan
Apa itu memori agen AI?
Memori agen AI adalah lapisan penyimpanan dan pengambilan yang memungkinkan agen menyimpan informasi di berbagai langkah dan sesi. Biasanya ia menggabungkan jendela percakapan terbaru, fakta jangka panjang yang ditemukan berdasarkan makna, scratchpad untuk tugas saat ini, dan log peristiwa.
Apa perbedaan antara memori agen jangka pendek dan jangka panjang?
Memori jangka pendek menyimpan apa yang sedang terjadi sekarang, seperti giliran terbaru dan status tugas, dan bersifat terbatas serta sementara. Memori jangka panjang menyimpan pengetahuan yang harus melampaui sesi, seperti fakta, preferensi, dan peristiwa masa lalu, dan dicari saat dibutuhkan.
Apa itu ringkasan bergulir dalam memori agen?
Ringkasan bergulir adalah deskripsi singkat yang berjalan tentang apa yang telah dipelajari atau diputuskan agen sejauh ini, diperbarui seiring pekerjaan berlanjut. Ia menggantikan giliran lama di prompt agar prompt tidak terus membesar. HotKV menyimpan satu per agen dan menaikkan nomor versi pada setiap pembaruan.
Apakah saya memerlukan vector database untuk memori agen?
Hanya untuk memori semantik, di mana fakta ditemukan berdasarkan makna. Jendela percakapan, status kerja, dan log peristiwa tidak memerlukan vektor. HotKV menyimpan keempatnya dalam satu mesin, jadi indeks vektor dan penyimpanan lain bukan sistem yang terpisah.
Berapa lama memori agen harus disimpan?
Tergantung jenisnya. Memori kerja harus kedaluwarsa ketika tugas berakhir, percakapan setelah sesi atau periode tertentu, dan log episodik selama kebutuhan audit Anda menghendaki. Fakta di memori semantik harus ditinjau dan dihapus ketika tidak lagi benar.
Bisakah memori agen diserang?
Ya. Teks yang ditulis ke memori kemudian dibaca ke prompt, sehingga catatan yang diracuni dapat mengarahkan agen. Catat dari mana setiap fakta berasal, percayai konten luar lebih sedikit, dan jaga agar memori yang diingat berada di bawah system prompt Anda dalam hal otoritas.
Apakah HotKV menyimpan memori agen di RAM?
HotKV adalah mesin in-memory, jadi pembacaan dilayani dari memori. Penulisan ke keempat penyimpanan dicatat untuk append-only file dan untuk replika, dengan waktu kedaluwarsa dibawa serta, menurut dokumentasi produk.
Lanjutkan percakapan
Komentar
Ada pertanyaan tentang metodenya? Hasil yang berbeda di perangkat keras Anda? Bagikan temuan Anda. Komentar ditinjau sebelum ditampilkan.