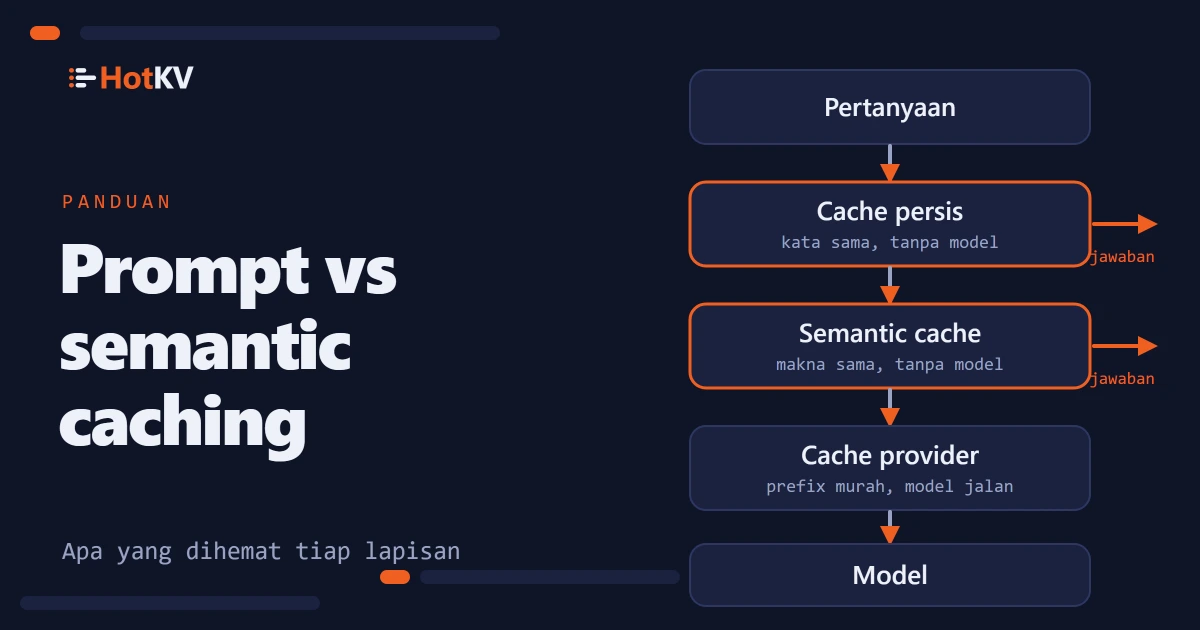
Prompt caching vs semantic caching: apa yang dihemat masing-masing
Prompt caching membuat prefiks yang berulang lebih murah, semantic caching menghilangkan panggilan model. Cara kerjanya, apa yang kami ukur, dan kapan memakai yang mana.
Tag
Biaya API terukur dan penghematan token dengan HotKV, termasuk asumsi harga, sensitivitas terhadap beban kerja, dan batas ekstrapolasi.
2 artikel di Optimasi biaya
Prompt caching membuat prefiks yang berulang lebih murah, semantic caching menghilangkan panggilan model. Cara kerjanya, apa yang kami ukur, dan kapan memakai yang mana.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Ikuti rasa ingin tahu Anda