
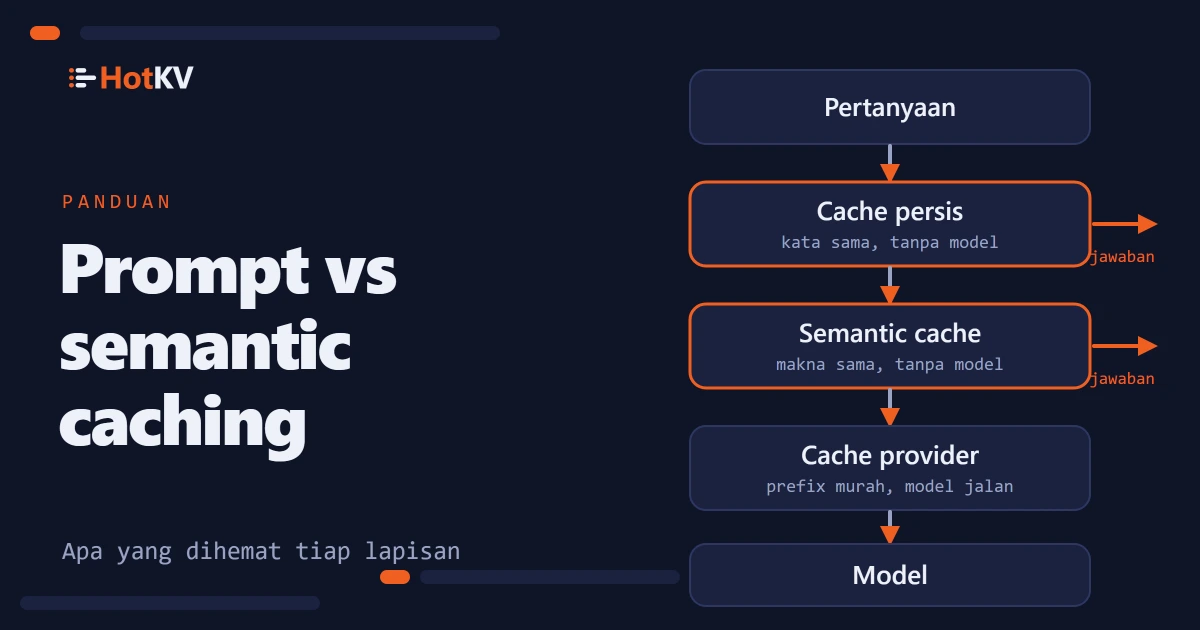
Dua hal yang berbeda dijual sebagai caching untuk model bahasa, dan tim sering membeli yang satu sambil mengharapkan yang lain. Prompt caching adalah fitur penyedia yang membuat prefiks prompt yang berulang lebih murah dibaca. Semantic caching adalah lapisan yang Anda jalankan sendiri yang menjawab pertanyaan dari memori sehingga model tidak pernah dipanggil. Keduanya menyelesaikan separuh tagihan yang berbeda, dan keduanya bekerja paling baik bersama.
Singkatnya. Prompt caching memberi diskon pada awal prompt yang berulang, seperti system prompt yang panjang, tetapi model tetap berjalan dan Anda tetap membayar setiap token keluaran. Caching persis dan semantik menghilangkan panggilan sepenuhnya ketika pertanyaan sudah pernah dijawab. Dalam benchmark 3.000 permintaan kami dengan prompt caching penyedia sudah aktif, menambahkan HotKV di depan memangkas panggilan model, token, dan biaya sekitar 70%, karena token keluaran masih 73% hingga 92% dari biaya baseline.
Cara kerja prompt caching
Prompt caching berada di penyedia model. Anda menandai awal permintaan yang stabil, biasanya tool dan system prompt, dan penyedia menyimpan bentuk yang sudah diprosesnya untuk waktu singkat. Permintaan berikutnya yang dimulai dengan teks identik ditagih dengan tarif yang lebih rendah untuk bagian itu. Kami menjelaskan versi Anthropic di sini karena itulah yang kami ukur. Rincian di bawah berasal dari dokumentasi prompt caching-nya, diperiksa pada 18 Oktober 2026.
Apa yang di-cache
Sebuah hit memerlukan kecocokan persis. Setiap blok hingga dan termasuk yang Anda tandai dengan cache_control harus identik, dalam urutan tool, system prompt, lalu pesan. Ubah satu karakter di awal prompt dan semua yang sesudahnya adalah miss. Pertanyaannya sendiri datang terakhir, jadi tidak pernah menjadi bagian dari prefiks yang di-cache.
Prompt di bawah panjang minimum tidak di-cache dan tidak ada error yang dikembalikan. Untuk model Claude terkini yang kami pakai, Fable 5.1, Opus 5.5, Sonnet 5.5, dan Haiku 5.5, minimum yang terdokumentasi adalah 512 token. Entri cache diisolasi per organisasi, dan per workspace pada Claude API.
Berapa biayanya
Masa hidup default adalah lima menit, dan setiap pemakaian entri menyegarkannya tanpa biaya tambahan. Masa hidup satu jam tersedia. Menulis entri berharga 1,25 kali harga masukan dasar untuk lima menit dan 2 kali untuk satu jam. Membacanya berharga 0,1 kali harga masukan dasar pada sebagian besar model, 0,05 kali pada Opus 5.5 dan Sonnet 5.5, dan 0,025 kali pada Fable 5.1, menurut halaman harga. Pengali itu berubah, jadi baca halaman terbaru sebelum Anda menghitung apa pun.
Apa yang tidak dapat dihilangkan prompt caching
Prompt caching memberi diskon pada pembacaan prefiks. Ia tidak melewati model. Setiap permintaan tetap menghasilkan jawaban baru, Anda tetap menunggunya, dan setiap token keluaran ditagih dengan harga keluaran penuh.
Benchmark kami menunjukkan seberapa penting itu. Kami mengirim 3.000 pertanyaan dukungan pelanggan ke masing-masing dari empat model Claude dengan kebijakan 2.200 token sebagai system prompt dan caching penyedia aktif. Antara 90% dan 93% token yang dihitung adalah pembacaan cache dari kebijakan itu. Keluaran hanya 6% hingga 9% dari token, namun merupakan 73% hingga 92% dari biaya baseline. Prefiksnya sudah murah, jadi sisa pengeluaran ada di jawaban.
Itulah celah yang diisi lapisan lain. Metode lengkap dan hasilnya ada di benchmark penghematan token.
Response caching persis dan semantik
Dua lapisan menjawab permintaan dari memori. Keduanya berbeda dalam cara memutuskan bahwa permintaan baru cocok dengan yang lama.
Response caching persis
Cache persis menyimpan jawaban akhir di bawah kunci yang dibangun dari semua yang membentuknya. Biasanya itu adalah model, versi prompt, dan pertanyaan yang dinormalisasi. Ketika permintaan yang sama tiba lagi, jawaban tersimpan dikembalikan dan model tidak dipanggil. Tidak ada skor kemiripan dan tidak ada risiko mengembalikan jawaban yang dimaksudkan untuk pertanyaan lain.
Dalam eksekusi kami, cache persis menjawab sekitar 39% permintaan. Pertanyaan yang berulang kembali dalam median sekitar 0,05 ms. Itu diukur dengan klien Python melalui loopback pada mesin yang sama, jadi bacalah sebagai angka lokal, bukan angka jaringan. Benchmark memakai GET dan SET biasa untuk lapisan ini. HotKV Enterprise juga memiliki prompt cache pencocokan persis khusus, PCACHE.*, dengan batas per namespace dan pelacakan biaya.
Caching persis buta terhadap susunan kata. "How do I reset my password?" dan "I forgot my password" adalah dua kunci yang berbeda.
Semantic caching
Semantic cache mencari makna dari pertanyaan. Ia mengubah pertanyaan menjadi embedding, menemukan pertanyaan tersimpan terdekat, dan mengembalikan jawabannya jika cosine similarity melampaui ambang batas. Di HotKV itu adalah SCACHE.*, dibangun di atas indeks vektor yang sama dengan vector search.
Sekitar 31% permintaan kami dijawab dengan cara ini. Sebuah parafrase memakan median sekitar 130 ms, hampir seluruhnya adalah panggilan ke layanan embedding, jadi semantic hit jauh lebih cepat daripada panggilan model tetapi tidak instan. Tanpa lapisan semantik, cache persis saja akan memerlukan paling banyak 1.264 panggilan model dari 3.000, sekitar 58% lebih sedikit. Lapisan semantik membawa penghematan menjadi sekitar 70%.
Di sinilah juga letak risikonya. Pertanyaan yang mirip tidak selalu pertanyaan yang sama. Kami meminta model Claude kedua menilai setiap semantic hit terhadap jawaban baru. Pada ambang batas default kami 0,81, jawaban di cache sesuai dengan pertanyaan persis 5,8 hingga 10,7 poin persentase lebih jarang daripada jawaban baru. Pada Sonnet 5.5, ambang batas 0,88 ke atas tidak menunjukkan defisit seperti itu, dengan bukti yang tipis. Pertanyaan yang ditulis berbeda hanya pada satu detail penentu tetap cocok 62% dari waktu pada 0,81 dan 10% pada 0,95.
Prompt caching vs semantic caching berdampingan
| Prompt caching penyedia | Cache respons persis | Semantic cache | |
|---|---|---|---|
| Yang dihilangkan | Sebagian harga masukan | Seluruh panggilan model | Seluruh panggilan model |
| Aturan pencocokan | Prefiks identik | Permintaan identik | Makna serupa di atas ambang batas |
| Token keluaran ditagih | Ya, setiap kali | Tidak, saat hit | Tidak, saat hit |
| Risiko jawaban salah | Tidak ada | Tidak ada untuk permintaan identik | Nyata, disetel oleh ambang batas |
| Berjalan di mana | Di penyedia | Di cache Anda | Di cache Anda, plus satu panggilan embedding |
| Porsi permintaan dalam eksekusi kami | Selalu aktif | Sekitar 39% | Sekitar 31% |
Prompt caching penyedia dan response caching bukan alternatif. Yang satu menurunkan harga panggilan yang masih Anda lakukan, dan yang lain mengurangi jumlah panggilan yang Anda lakukan.
Apa yang dilakukan caching terhadap latensi
Melewati model mengubah seberapa cepat jawaban tiba selain berapa biayanya. Dalam eksekusi kami, median waktu hingga jawaban lengkap turun dari 2,7 detik menjadi 127 ms pada Fable 5.1, dari 2,9 detik menjadi 126 ms pada Opus 5.5, dari 1,8 detik menjadi 128 ms pada Sonnet 5.5, dan dari 1,4 detik menjadi 125 ms pada Haiku 5.5. Itu 11 hingga 23 kali lebih cepat pada median.
Ujung yang lambat nyaris tidak bergerak. Sekitar 30% permintaan masih mencapai model, dan persentil ke-99 pada Fable 5.1 sekitar 6,4 detik dengan HotKV dibandingkan 6,6 detik tanpanya. Cache menghilangkan penantian untuk permintaan yang dijawabnya dan tidak berbuat apa-apa untuk yang terlewat. Jika keluhan Anda adalah kasus terburuk yang lambat, bukan kasus tipikal yang lambat, caching saja tidak akan memperbaikinya.
Ini adalah waktu hingga jawaban lengkap, karena panggilan tidak di-stream. Jawaban yang di-stream menampilkan kata pertamanya lebih cepat. Selisih di jendela chat lebih kecil daripada selisih pada angka-angka ini.
Memilih lapisan untuk trafik Anda
Lapisan yang tepat bergantung pada bagaimana permintaan Anda berulang, dan Anda dapat mengukurnya sebelum membangun apa pun.
Cocokkan lapisan dengan trafik
Cocokkan lapisan dengan cara permintaan Anda berulang.
- System prompt atau daftar tool yang panjang dan stabil: gunakan prompt caching penyedia. Biayanya kecil untuk diaktifkan dan tidak mengubah jawaban apa pun.
- Pertanyaan yang sama dengan kata yang sama, seperti tombol, template, atau percobaan ulang: gunakan cache respons persis. Aman dan cepat.
- Trafik dukungan, pencarian, dan FAQ di mana orang menanyakan hal yang sama dengan kata berbeda: tambahkan semantic cache, atur ambang batas tinggi, dan periksa kualitas jawaban pada pertanyaan Anda sendiri sebelum mempercayainya.
- Jawaban yang bergantung pada pengguna, jam, atau data langsung: jangan cache sama sekali, atau gunakan kunci cache berdasarkan fakta yang mengubah jawaban.
Penghematan mengikuti pengulangan. Ketika kami membuat setiap intent sama kemungkinannya alih-alih condong, biaya turun 56% pada dua model yang kami jalankan ulang, dan dengan 3.000 pertanyaan yang semuanya berbeda biaya turun 38%. Beban kerja tanpa pertanyaan yang berulang atau mirip tidak menghemat apa pun.
Ukur pengulangan Anda sendiri lebih dulu
Sebelum membangun apa pun, cari tahu berapa banyak trafik Anda yang berulang. Angka itu menentukan apakah cache persis layak dimiliki. Butuh sepuluh menit dengan pertanyaan yang sudah Anda log. Normalisasikan setiap pertanyaan seperti kunci cache Anda nanti, hitung yang berbeda, dan lihat berapa banyak trafik yang merupakan pengulangan.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share adalah pecahan permintaan yang akan dijawab cache persis, setelah ia melihat setiap pertanyaan untuk pertama kalinya. Kumpulan uji kami memiliki 1.264 pertanyaan berbeda di antara 3.000 permintaan, jadi angkanya sekitar 58%. Jika milik Anda mendekati 5%, cache persis tidak akan banyak membantu, dan hanya lapisan semantik yang dapat menolong.
Dua peringatan berlaku. Cache mulai kosong, jadi permintaan awal selalu mencapai model. Dalam eksekusi kami sekitar 52% dari seribu permintaan pertama dilayani dari cache dan sekitar 81% dari seribu terakhir. Dan log trafik bulan lalu hanya memberi tahu Anda tentang bulan lalu. Jika Anda akan meluncurkan fitur yang mengubah apa yang ditanyakan orang, perlakukan angka itu sebagai panduan kasar.
Menggabungkan lapisan-lapisan
Sebuah permintaan sebaiknya melewati lapisan dari yang paling murah dan paling aman ke yang paling mahal, dan Anda harus bisa melihat apa yang dihemat masing-masing.
Urutan pencarian
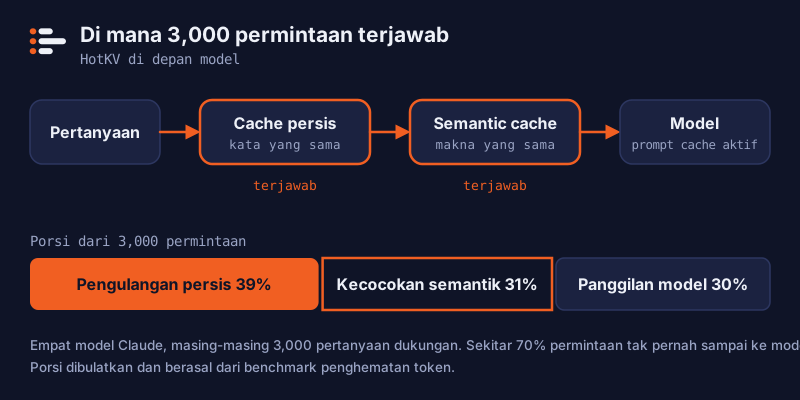
Urutan itu penting. Periksa lapisan yang paling murah dan paling aman lebih dulu dan panggil model hanya ketika semuanya miss. Sketsa ini mengasumsikan klien bergaya redis-py dengan decode_responses=True, dua namespace yang dibuat sebelumnya, dan fungsi embed dan llm milik Anda sendiri.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # kata-kata yang sama

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # makna yang sama

    reply = llm.complete(question)                   # prompt caching penyedia berlaku di sini
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Buat namespace sekali dengan PCACHE.CREATE answers_exact dan SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, memakai dimensi model embedding Anda. Kumpulan perintah AI disertakan pada instance HotKV Cloud Performance dan Scale, dan halaman AI mendaftar apa yang dilakukan setiap mesin. Halaman harga menunjukkan paket mana yang menyertakan apa.
Memantau skor di produksi
Cache yang tidak bisa Anda lihat adalah cache yang tidak bisa Anda percaya. HotKV menyimpan jumlah hit dan miss per namespace. Jika Anda menyimpan penggunaan token dari panggilan aslinya bersama setiap entri, ia juga dapat mengatribusikan token dan biaya yang dihindari setiap hit berikutnya. Balasan PCACHE.STATS dan SCACHE.STATS kemudian membawa bidang seperti usage_saved_requests, usage_saved_input_tokens, dan usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Ganti <model> dengan id model Anda. INPUT menghitung token prompt yang tidak di-cache dan CACHEREAD token yang dilayani penyedia dari cache-nya sendiri, jadi keduanya tidak tumpang tindih. Model harus ada di tabel harga HotKV agar bidang biaya bermakna. LLMSTATS.PRICE LIST menunjukkan model mana yang dikenal, dan LLMSTATS.PRICE SET menambahkan milik Anda. Model tanpa harga tetap dihitung tokennya, tetapi biayanya dicatat sebagai nol dan penghitung terpisah menunjukkan bahwa permintaan tidak berharga.
Cache mengurangi pengeluaran, dan anggaran membatasi sisanya. LLMBUDGET.SET mendefinisikan batas token dan dolar selama jendela waktu. LLMBUDGET.CONSUME diperiksa sebelum panggilan model, jadi agen yang lepas kendali dihentikan sebelum menghabiskan uang, bukan sesudahnya. LLMSTATS.RECORD menyimpan total per tenant yang memahami token cache-read dan cache-write penyedia. Ketiganya memakai satu tabel harga ketika Anda memberikan nama model, sehingga penghematan, anggaran, dan angka dasbor tidak bisa saling bertentangan.
Kesalahan yang membuat cache mengembalikan jawaban yang salah
Kebanyakan cache hit yang buruk berasal dari kunci yang kekurangan sesuatu. Masukkan model, versi prompt, dan versi tool atau kebijakan apa pun ke dalam kunci persis, agar perubahan prompt tidak menyajikan jawaban yang ditulis untuk yang lama.
Beri entri masa hidup yang sesuai dengan seberapa cepat fakta Anda berubah. Pisahkan tenant dengan namespace terpisah agar jawaban satu pelanggan tidak pernah ditawarkan kepada pelanggan lain. Jangan pernah meng-cache jawaban yang berisi data pribadi kecuali kuncinya menyertakan milik siapa data itu.
Terakhir, ukur pada trafik Anda sendiri. Angka kami berasal dari satu dataset publik berisi pertanyaan perbankan singkat, kebijakan fiktif, dan satu kali jalan per kondisi, dan bukan janji untuk beban kerja Anda.
Pertanyaan yang sering diajukan
Apa itu prompt caching?
Prompt caching adalah fitur penyedia model yang menyimpan awal prompt yang sudah diproses untuk waktu singkat. Permintaan berikutnya yang dimulai dengan teks yang persis sama ditagih dengan tarif lebih rendah untuk bagian itu. Model tetap berjalan dan menghasilkan jawaban baru, jadi Anda tetap membayar token keluaran.
Apakah prompt caching sama dengan semantic caching?
Tidak. Prompt caching memakai ulang prefiks prompt yang berulang dan tetap memanggil model. Semantic caching mengembalikan jawaban tersimpan untuk pertanyaan dengan makna serupa dan melewati panggilan model. Keduanya menangani biaya yang berbeda dan dapat dipakai bersama.
Apakah prompt caching mengurangi biaya token keluaran?
Tidak. Ia hanya menurunkan harga membaca prefiks yang di-cache. Dalam benchmark kami, keluaran adalah 6% hingga 9% dari token tetapi 73% hingga 92% dari biaya baseline dengan prompt caching sudah aktif, itulah sebabnya meng-cache seluruh jawaban menghemat jauh lebih banyak.
Berapa lama prompt cache Anthropic bertahan?
Defaultnya lima menit, disegarkan setiap kali entri dipakai. Opsi satu jam tersedia dengan harga tulis yang lebih tinggi. Periksa dokumentasi terbaru, karena batas dan harga berubah.
Bisakah saya memakai prompt caching dan semantic caching bersama?
Ya, dan benchmark kami melakukan persis itu. Prompt caching penyedia tetap aktif di kedua eksekusi, dan lapisan semantik serta persis berada di depan model. Cache hit melewati panggilan, dan miss tetap mendapat manfaat dari prefiks yang didiskon.
Ambang batas kemiripan berapa yang sebaiknya dipakai semantic cache?
Tidak ada nilai universal. Kami memilih 0,81 pada split pelatihan terpisah, dan pada Sonnet 5.5 jawaban di cache tidak menunjukkan defisit kualitas dibandingkan jawaban baru dari 0,88 ke atas, dengan bukti yang tipis. Mulai dari tinggi, nilai jawaban di cache terhadap jawaban baru pada pertanyaan Anda sendiri, dan turunkan ambang batas hanya jika kualitas bertahan.
Lanjutkan percakapan
Komentar
Ada pertanyaan tentang metodenya? Hasil yang berbeda di perangkat keras Anda? Bagikan temuan Anda. Komentar ditinjau sebelum ditampilkan.