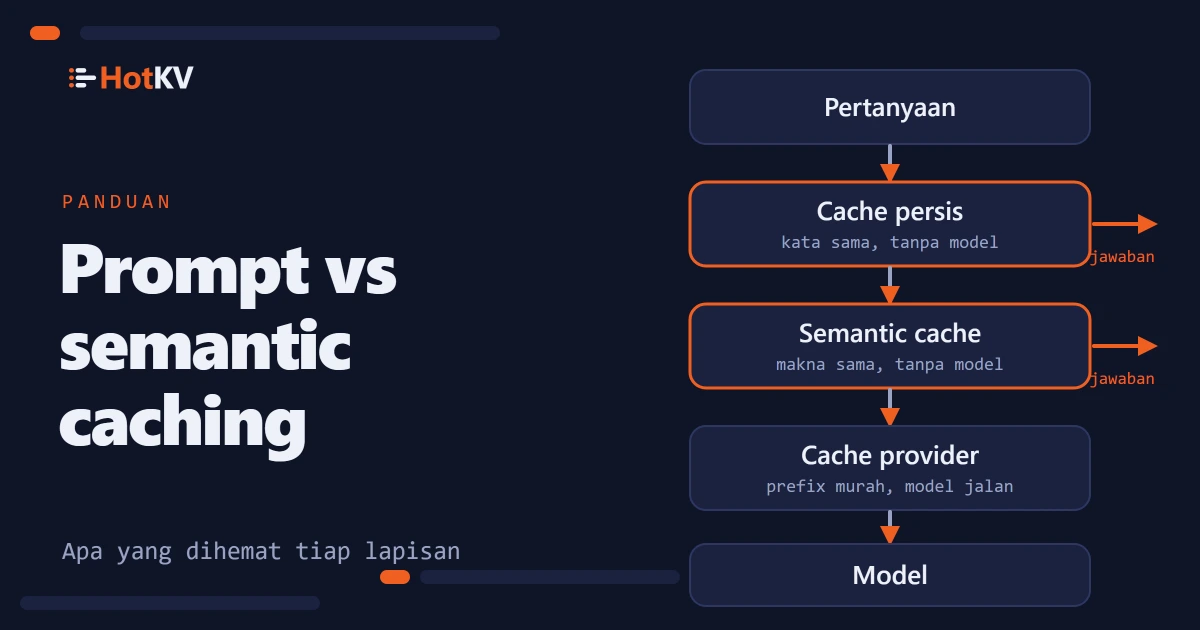
Prompt caching vs semantic caching: apa yang dihemat masing-masing
Prompt caching membuat prefiks yang berulang lebih murah, semantic caching menghilangkan panggilan model. Cara kerjanya, apa yang kami ukur, dan kapan memakai yang mana.
Tag
Prompt caching dari penyedia dan response caching untuk aplikasi LLM, apa yang dihemat masing-masing pada token dan biaya, dan di mana masing-masing berhenti membantu.
2 artikel di Prompt caching
Prompt caching membuat prefiks yang berulang lebih murah, semantic caching menghilangkan panggilan model. Cara kerjanya, apa yang kami ukur, dan kapan memakai yang mana.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Ikuti rasa ingin tahu Anda