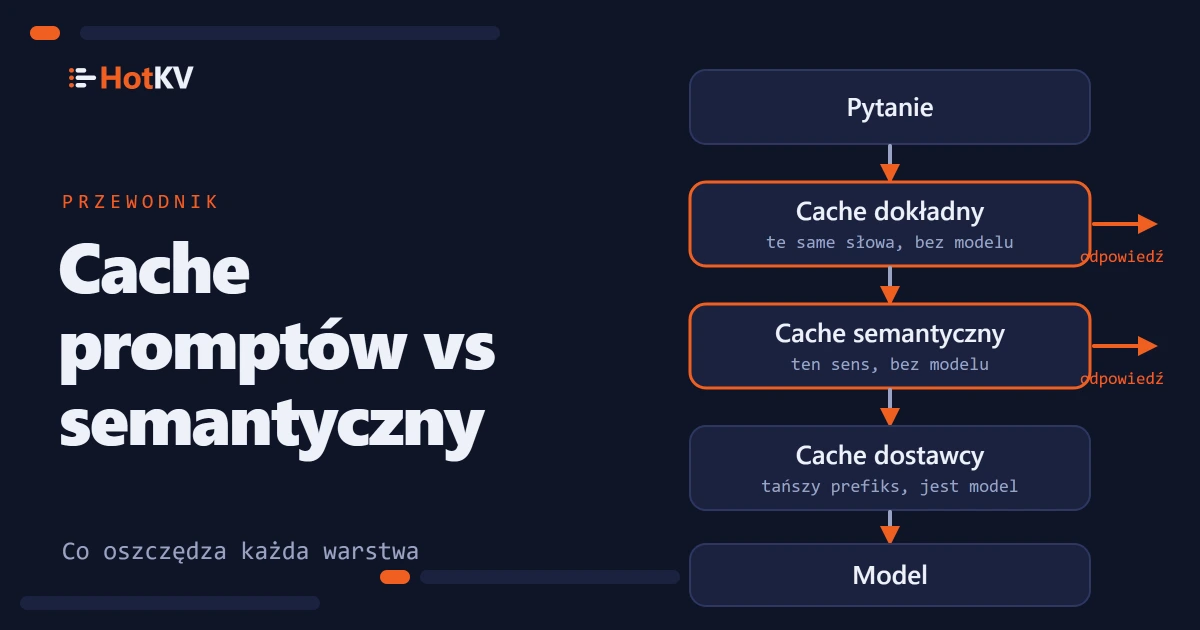
Cache promptów kontra cache semantyczny: co każdy oszczędza
Cache promptów obniża koszt powtórzonego prefiksu. Cache semantyczny eliminuje wywołanie modelu. Jak działa każdy, co zmierzyliśmy i którego użyć kiedy.
Tag
Dokładny i semantyczny cache odpowiedzi w HotKV, w tym progi podobieństwa, współczynniki trafień i sposób, w jaki oceniamy jakość odpowiedzi.
2 artykuły w: Cache semantyczny
Cache promptów obniża koszt powtórzonego prefiksu. Cache semantyczny eliminuje wywołanie modelu. Jak działa każdy, co zmierzyliśmy i którego użyć kiedy.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Podążaj za ciekawością