
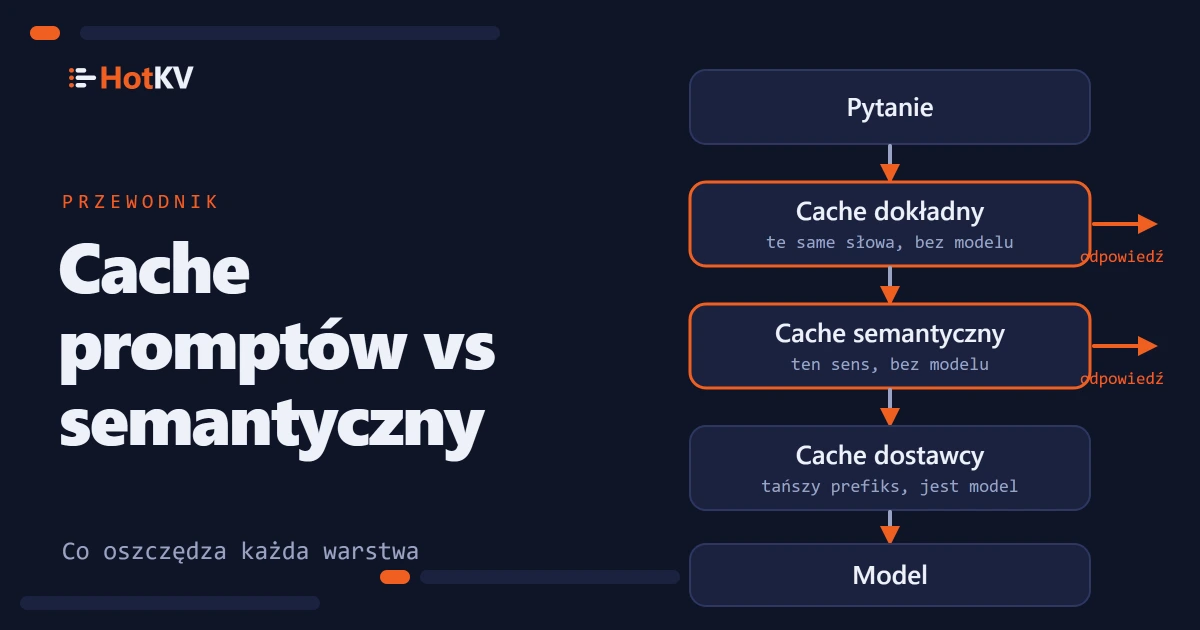
Pod nazwą cache dla modeli językowych sprzedaje się dwie różne rzeczy, a zespoły regularnie kupują jedną, spodziewając się drugiej. Cache promptów to funkcja dostawcy, która obniża koszt odczytu powtórzonego prefiksu promptu. Cache semantyczny to warstwa, którą uruchamiasz sam i która odpowiada na pytanie z pamięci, więc model nigdy nie jest wywoływany. Rozwiązują różne połowy rachunku i działają najlepiej razem.
W skrócie. Cache promptów daje zniżkę na powtarzający się początek promptu, taki jak długi prompt systemowy, ale model nadal działa i nadal płacisz za każdy token wyjściowy. Cache dokładny i semantyczny eliminują wywołanie w całości, gdy na pytanie już odpowiedziano. W naszym benchmarku 3000 żądań, przy włączonym już cache promptów po stronie dostawcy, dodanie HotKV z przodu obniżyło liczbę wywołań modelu, tokenów i koszt o około 70%, ponieważ tokeny wyjściowe nadal stanowiły od 73% do 92% kosztu bazowego.
Jak działa cache promptów
Cache promptów działa u dostawcy modelu. Oznaczasz stały początek żądania, zwykle narzędzia i prompt systemowy, a dostawca przechowuje jego przetworzoną postać przez krótki czas. Następne żądanie zaczynające się od identycznego tekstu jest rozliczane po obniżonej stawce za tę część. Opisujemy tu wersję Anthropic, bo to ją mierzyliśmy. Poniższe szczegóły pochodzą z jej dokumentacji cache promptów, sprawdzonej 18 października 2026.
Co jest buforowane
Trafienie wymaga dokładnego dopasowania. Każdy blok aż do oznaczonego przez cache_control włącznie musi być identyczny, w kolejności narzędzia, prompt systemowy, potem wiadomości. Zmień jeden znak na początku promptu, a wszystko po nim jest pudłem. Samo pytanie jest na końcu, więc nigdy nie jest częścią buforowanego prefiksu.
Prompty poniżej minimalnej długości nie są buforowane i nie zwracany jest żaden błąd. Dla aktualnych modeli Claude, których użyliśmy, Fable 5.1, Opus 5.5, Sonnet 5.5 i Haiku 5.5, udokumentowane minimum to 512 tokenów. Wpisy cache są izolowane na organizację, a w API Claude na przestrzeń roboczą.
Ile to kosztuje
Domyślny czas życia to pięć minut, a każde użycie wpisu odświeża go bez dodatkowej opłaty. Dostępny jest czas życia jedna godzina. Zapis wpisu kosztuje 1,25 raza podstawowej ceny wejścia dla pięciu minut i 2 razy dla godziny. Odczyt kosztuje 0,1 podstawowej ceny wejścia w większości modeli, 0,05 w Opus 5.5 i Sonnet 5.5 oraz 0,025 w Fable 5.1, według strony z cennikiem. Te mnożniki się zmieniają, więc przed jakimikolwiek obliczeniami przeczytaj aktualną stronę.
Czego cache promptów nie może usunąć
Cache promptów daje zniżkę na odczyt prefiksu. Nie pomija modelu. Każde żądanie nadal tworzy nową odpowiedź, nadal na nią czekasz, a każdy token wyjściowy jest rozliczany po pełnej cenie wyjścia.
Nasz benchmark pokazuje, jak bardzo to ma znaczenie. Wysłaliśmy 3000 pytań do obsługi klienta do każdego z czterech modeli Claude, z 2200-tokenową polityką jako promptem systemowym i włączonym cache dostawcy. Od 90% do 93% policzonych tokenów to odczyty tej polityki z cache. Wyjście stanowiło tylko od 6% do 9% tokenów, a mimo to od 73% do 92% kosztu bazowego. Prefiks był już tani, więc pozostałe wydatki siedziały w odpowiedziach.
To luka, którą wypełniają pozostałe warstwy. Pełna metoda i wyniki są w benchmarku oszczędności tokenów.
Cache odpowiedzi dokładny i semantyczny
Dwie warstwy odpowiadają na żądanie z pamięci. Różnią się tym, jak decydują, że nowe żądanie pasuje do starego.
Dokładny cache odpowiedzi
Dokładny cache zapisuje ostateczną odpowiedź pod kluczem zbudowanym ze wszystkiego, co ją kształtuje. Zwykle jest to model, wersja promptu i znormalizowane pytanie. Gdy to samo żądanie przychodzi ponownie, zwracana jest zapisana odpowiedź, a model nie jest wywoływany. Nie ma wyniku podobieństwa i nie ma ryzyka zwrócenia odpowiedzi przeznaczonej dla innego pytania.
W naszym uruchomieniu dokładny cache odpowiedział na około 39% żądań. Powtórzone pytanie wracało w medianie około 0,05 ms. Zmierzono to klientem Pythona przez loopback na tej samej maszynie, więc traktuj to jako wartość lokalną, a nie sieciową. Benchmark użył do tej warstwy zwykłych GET i SET. HotKV Enterprise ma też dedykowany cache promptów z dokładnym dopasowaniem, PCACHE.*, z limitami na przestrzeń nazw i śledzeniem kosztów.
Dokładny cache jest ślepy na sformułowanie. „How do I reset my password?” i „I forgot my password” to dwa różne klucze.
Cache semantyczny
Cache semantyczny wyszukuje znaczenie pytania. Zamienia pytanie na embedding, znajduje najbliższe zapisane pytanie i zwraca jego odpowiedź, jeśli podobieństwo cosinusowe przekracza próg. W HotKV to SCACHE.*, zbudowane na tym samym indeksie wektorowym co wyszukiwanie wektorowe.
Około 31% naszych żądań dostało odpowiedź w ten sposób. Parafraza zajmowała w medianie około 130 ms, prawie w całości wywołanie usługi embeddingów, więc trafienie semantyczne jest znacznie szybsze niż wywołanie modelu, ale nie natychmiastowe. Bez warstwy semantycznej sam dokładny cache potrzebowałby najwyżej 1264 wywołań modelu na 3000, czyli o około 58% mniej. Warstwa semantyczna podniosła oszczędność do około 70%.
Tu też kryje się ryzyko. Podobne pytanie nie zawsze jest tym samym pytaniem. Kazaliśmy drugiemu modelowi Claude ocenić każde trafienie semantyczne względem świeżej odpowiedzi. Przy naszym domyślnym progu 0,81 odpowiedzi z cache pasowały do dokładnego pytania rzadziej niż świeże o 5,8 do 10,7 punktu procentowego. W Sonnet 5.5 progi 0,88 i wyższe nie wykazały takiego niedoboru, przy skąpych dowodach. Pytania napisane tak, by różniły się jednym rozstrzygającym szczegółem, nadal pasowały w 62% przy 0,81 i w 10% przy 0,95.
Cache promptów kontra cache semantyczny obok siebie
| Cache promptów dostawcy | Dokładny cache odpowiedzi | Cache semantyczny | |
|---|---|---|---|
| Co usuwa | Część ceny wejścia | Całe wywołanie modelu | Całe wywołanie modelu |
| Reguła dopasowania | Identyczny prefiks | Identyczne żądanie | Podobne znaczenie powyżej progu |
| Rozliczane tokeny wyjściowe | Tak, za każdym razem | Nie, przy trafieniu | Nie, przy trafieniu |
| Ryzyko błędnej odpowiedzi | Brak | Brak dla identycznych żądań | Realne, regulowane progiem |
| Gdzie działa | U dostawcy | W Twoim cache | W Twoim cache, plus wywołanie embeddingu |
| Udział żądań w naszym uruchomieniu | Zawsze włączony | Około 39% | Około 31% |
Cache promptów dostawcy i cache odpowiedzi nie są alternatywami. Jeden obniża cenę wywołań, które nadal wykonujesz, a drugi zmniejsza liczbę wywołań.
Co cache robi z opóźnieniem
Pominięcie modelu zmienia nie tylko koszt, ale i szybkość nadejścia odpowiedzi. W naszym uruchomieniu mediana czasu do kompletnej odpowiedzi spadła z 2,7 sekundy do 127 ms w Fable 5.1, z 2,9 sekundy do 126 ms w Opus 5.5, z 1,8 sekundy do 128 ms w Sonnet 5.5 i z 1,4 sekundy do 125 ms w Haiku 5.5. To od 11 do 23 razy szybciej w medianie.
Wolny koniec prawie się nie ruszył. Około 30% żądań nadal docierało do modelu, a 99. percentyl w Fable 5.1 wynosił około 6,4 sekundy z HotKV wobec 6,6 sekundy bez niego. Cache usuwa czekanie dla żądań, na które odpowiada, i nic nie robi dla tych, które chybia. Jeśli Twoja skarga dotyczy wolnego najgorszego przypadku, a nie wolnego typowego, sam cache tego nie naprawi.
To czasy do kompletnej odpowiedzi, bo wywołania nie były strumieniowane. Odpowiedź strumieniowana pokazuje pierwsze słowa wcześniej. Różnica w oknie czatu jest mniejsza niż różnica w tych liczbach.
Wybór warstwy dla Twojego ruchu
Właściwa warstwa zależy od tego, jak powtarzają się Twoje żądania, a możesz to zmierzyć, zanim cokolwiek zbudujesz.
Dopasuj warstwę do ruchu
Dopasuj warstwę do tego, jak powtarzają się Twoje żądania.
- Długi, stały prompt systemowy lub lista narzędzi: użyj cache promptów dostawcy. Włączenie kosztuje niewiele i nie zmienia żadnych odpowiedzi.
- To samo pytanie tymi samymi słowami, jak przycisk, szablon lub ponowienie: użyj dokładnego cache odpowiedzi. Jest bezpieczny i szybki.
- Ruch wsparcia, wyszukiwania i FAQ, gdzie ludzie pytają o to samo innymi słowami: dodaj cache semantyczny, ustaw wysoki próg i sprawdź jakość odpowiedzi na własnych pytaniach, zanim mu zaufasz.
- Odpowiedzi zależne od użytkownika, zegara lub danych na żywo: nie buforuj żadnych z nich albo kluczuj cache faktami, które zmieniają odpowiedź.
Oszczędności podążają za powtarzalnością. Gdy zrównaliśmy prawdopodobieństwo każdej intencji zamiast skośnego rozkładu, koszt spadł o 56% w dwóch modelach, które uruchomiliśmy ponownie, a przy 3000 wszystkich różnych pytań o 38%. Obciążenie bez powtarzających się lub podobnych pytań nic nie oszczędza.
Najpierw zmierz własną powtarzalność
Zanim cokolwiek zbudujesz, sprawdź, jaka część Twojego ruchu się powtarza. Ta liczba decyduje, czy dokładny cache jest wart posiadania. Zajmuje dziesięć minut z pytaniami, które już logujesz. Znormalizuj każde pytanie tak, jak zrobi to Twój klucz cache, policz odrębne i zobacz, jaka część ruchu była powtórką.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share to ułamek żądań, na które odpowiedziałby dokładny cache, gdy raz zobaczył każde pytanie. Nasz zestaw testowy miał 1264 odrębne pytania wśród 3000 żądań, więc wynik wynosił około 58%. Jeśli Twój wychodzi blisko 5%, dokładny cache niewiele da i pomóc może tylko warstwa semantyczna.
Obowiązują dwa zastrzeżenia. Cache zaczyna pusty, więc pierwsze żądania zawsze docierają do modelu. W naszym uruchomieniu około 52% pierwszego tysiąca żądań obsłużono z cache, a około 81% ostatniego tysiąca. A log ruchu z zeszłego miesiąca mówi o zeszłym miesiącu. Jeśli zaraz uruchamiasz funkcję, która zmienia to, o co ludzie pytają, traktuj wynik jako przybliżoną wskazówkę.
Łączenie warstw
Żądanie powinno przechodzić przez warstwy od najtańszej i najbezpieczniejszej do najdroższej, a Ty powinieneś widzieć, ile każda zaoszczędziła.
Kolejność wyszukiwania
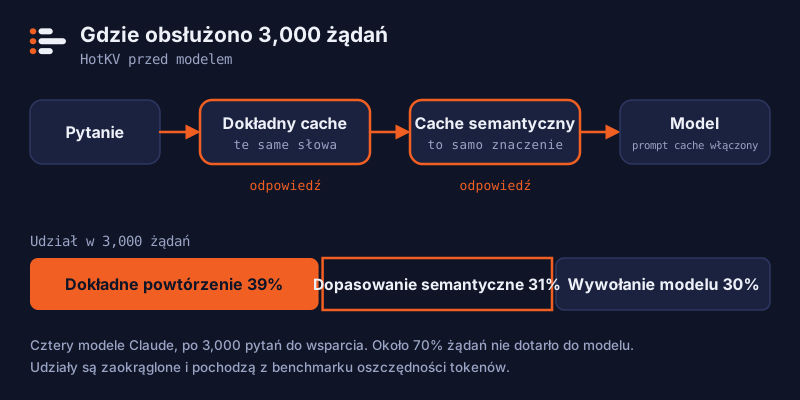
Kolejność ma znaczenie. Sprawdź najpierw najtańszą i najbezpieczniejszą warstwę i wywołaj model tylko wtedy, gdy wszystko chybia. Ten szkic zakłada klienta w stylu redis-py z decode_responses=True, dwie wcześniej utworzone przestrzenie nazw oraz Twoje własne funkcje embed i llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # same words

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # same meaning

    reply = llm.complete(question)                   # provider prompt caching applies here
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Utwórz przestrzenie nazw raz poleceniami PCACHE.CREATE answers_exact i SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, z wymiarem Twojego modelu embeddingów. Zestaw poleceń AI jest dostępny w instancjach HotKV Cloud Performance i Scale, a strona AI wymienia, co robi każdy silnik. Strona cennika pokazuje, który plan co zawiera.
Prowadzenie wyniku na produkcji
Cache, którego nie widzisz, to cache, któremu nie możesz ufać. HotKV prowadzi liczniki trafień i pudeł dla każdej przestrzeni nazw. Jeśli zapisujesz zużycie tokenów pierwotnego wywołania przy każdym wpisie, może też przypisać tokeny i koszt, których uniknęło każde kolejne trafienie. Odpowiedzi PCACHE.STATS i SCACHE.STATS niosą wtedy pola takie jak usage_saved_requests, usage_saved_input_tokens i usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Zastąp <model> identyfikatorem swojego modelu. INPUT liczy niebuforowane tokeny promptu, a CACHEREAD tokeny, które dostawca obsłużył z własnego cache, więc oba się nie pokrywają. Model musi być w tabeli cen HotKV, aby pole kosztu coś znaczyło. LLMSTATS.PRICE LIST pokazuje, które modele są znane, a LLMSTATS.PRICE SET dodaje Twoje własne. Model bez ceny nadal ma policzone tokeny, ale jego koszt jest zapisywany jako zero, a osobny licznik pokazuje, że żądania były niewycenione.
Cache obniżają wydatki, a budżet ogranicza to, co zostaje. LLMBUDGET.SET definiuje limit tokenów i dolarów w oknie czasowym. LLMBUDGET.CONSUME jest sprawdzane przed wywołaniem modelu, więc zbuntowany agent jest zatrzymywany, zanim wyda pieniądze, a nie po. LLMSTATS.RECORD przechowuje sumy na tenanta, które rozumieją tokeny odczytu i zapisu cache dostawcy. Wszystkie trzy używają jednej tabeli cen, gdy podasz nazwę modelu, więc oszczędność, budżet i liczba na dashboardzie nie mogą się rozjechać.
Błędy, które sprawiają, że cache zwraca złe odpowiedzi
Większość złych trafień w cache bierze się z klucza, któremu czegoś brakuje. Wstaw do dokładnego klucza model, wersję promptu i wszelką wersję narzędzia lub polityki, aby zmiana promptu nie serwowała odpowiedzi napisanych dla starego.
Nadaj wpisom czas życia odpowiadający temu, jak szybko zmieniają się Twoje fakty. Trzymaj tenantów osobno, w oddzielnych przestrzeniach nazw, aby odpowiedź jednego klienta nigdy nie była oferowana innemu. Nigdy nie buforuj odpowiedzi zawierającej dane osobowe, chyba że klucz zawiera, czyje to dane.
Na koniec mierz na własnym ruchu. Nasze liczby pochodzą z jednego publicznego zbioru danych krótkich pytań bankowych, fikcyjnej polityki i jednego uruchomienia na warunek, i nie są obietnicą dla Twojego obciążenia.
Najczęściej zadawane pytania
Czym jest cache promptów?
Cache promptów to funkcja dostawcy modelu, która przez krótki czas przechowuje przetworzony początek promptu. Późniejsze żądanie zaczynające się od dokładnie tego samego tekstu jest rozliczane po niższej stawce za tę część. Model nadal działa i tworzy nową odpowiedź, więc nadal płacisz za tokeny wyjściowe.
Czy cache promptów to to samo co cache semantyczny?
Nie. Cache promptów używa ponownie powtórzonego prefiksu promptu i nadal wywołuje model. Cache semantyczny zwraca zapisaną odpowiedź na pytanie o podobnym znaczeniu i pomija wywołanie modelu. Dotyczą różnych kosztów i można je stosować razem.
Czy cache promptów obniża koszt tokenów wyjściowych?
Nie. Obniża tylko cenę odczytu buforowanego prefiksu. W naszym benchmarku wyjście stanowiło od 6% do 9% tokenów, ale od 73% do 92% kosztu bazowego przy włączonym już cache promptów, dlatego buforowanie całych odpowiedzi zaoszczędziło znacznie więcej.
Jak długo trwa cache promptów Anthropic?
Domyślnie pięć minut, odświeżane przy każdym użyciu wpisu. Dostępna jest opcja godzinna, z wyższą ceną zapisu. Sprawdź aktualną dokumentację, bo limity i ceny się zmieniają.
Czy mogę używać cache promptów i cache semantycznego razem?
Tak, a nasz benchmark robił dokładnie to. Cache promptów dostawcy pozostał włączony w obu uruchomieniach, a warstwy semantyczna i dokładna stały przed modelem. Trafienia w cache pomijają wywołanie, a pudła nadal korzystają ze zniżki na prefiks.
Jakiego progu podobieństwa powinien używać cache semantyczny?
Nie ma wartości uniwersalnej. Wybraliśmy 0,81 na osobnym podziale treningowym, a w Sonnet 5.5 odpowiedzi z cache nie wykazywały niedoboru jakości wobec świeżych od 0,88 w górę, przy skąpych dowodach. Zacznij wysoko, oceń odpowiedzi z cache względem świeżych na własnych pytaniach i obniżaj próg tylko wtedy, gdy jakość się utrzymuje.
Kontynuuj rozmowę
Komentarze
Pytania o metodę? Inny wynik na Twoim sprzęcie? Podziel się swoimi wnioskami. Komentarze są sprawdzane, zanim się pojawią.